OXR · 1.3B · DOCUMENT PARSING:把文档读对再交给 Agent。多栏、小票、表格、化学式——数据管道的入口,先把解析做好。
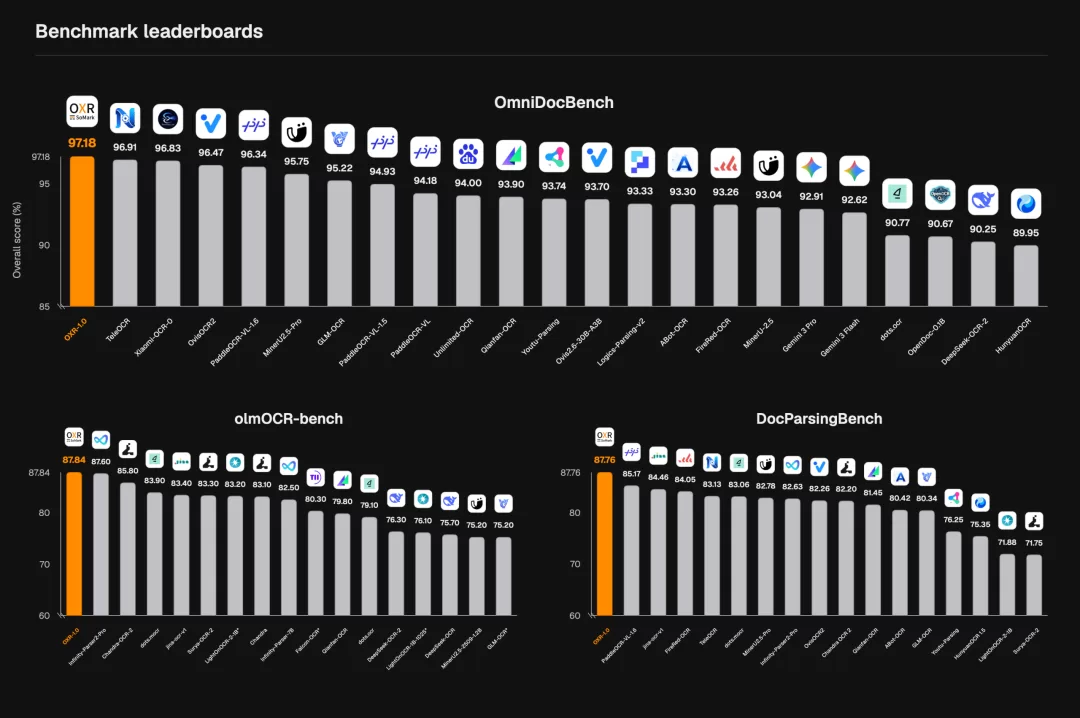
在三大主流基准评测(OmniDocBench、olmOCR-Bench、DocParsingBench)里都排在第一位,GitHub 开源一周多就破了 1.7k Star。
它的体量只有 1.3B,单卡 24G 显存就能在本地机房直接跑起来。
多模态模型总是有上下文窗口限制,如果给它足够的上下文,一页一页高清传上去慢慢看,如此大参数总是能看准的。但现实工作里哪有这么理想的条件?要效率、要算力成本,而且很多内部敏感材料根本不可能传到外网。更要命的是,前面文档解析要是第一步就看走眼,后面不管接多牛的模型,全都在顺着错数据瞎扯。
这次的 OXR 模型,就能解决这些问题。我挑了不同版式的样张,给它来了一轮实测,看看它在文档解析中的表现究竟咋样。
PART 01 它凭什么跑得快,还能认化学式?
OXR,全称是 Optical Everything Recognition,来自 SoMark 团队,模型只有 1.3B 参数,覆盖文字、表格、公式、代码块等 13 类文档元素。
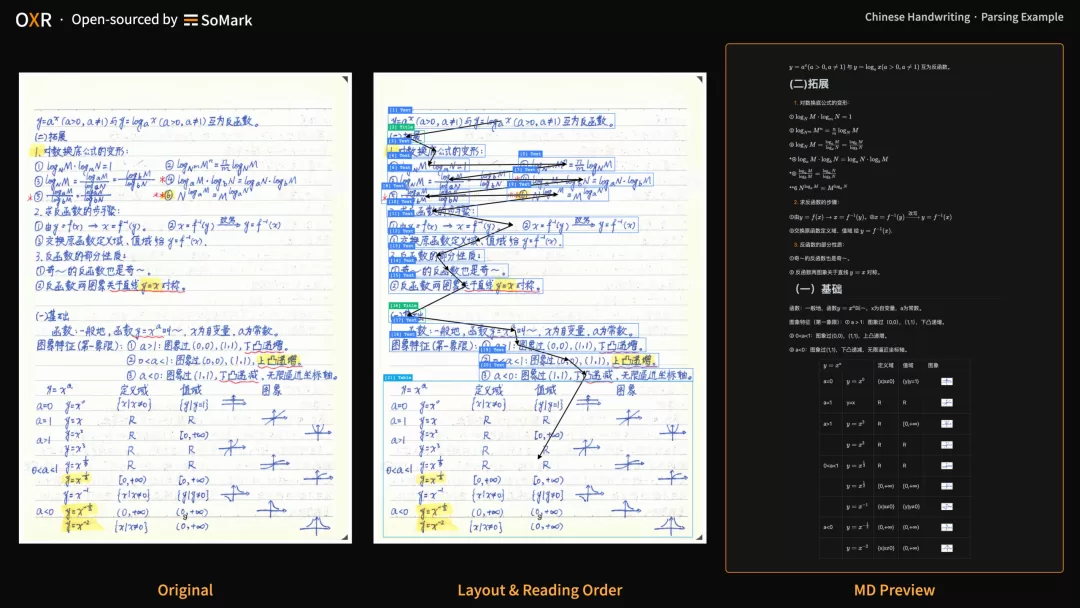
传统模型做解析,一般是版面分析、排阅读顺序、文字识别三步串行,不仅慢,前面切错后面就跟着全崩。
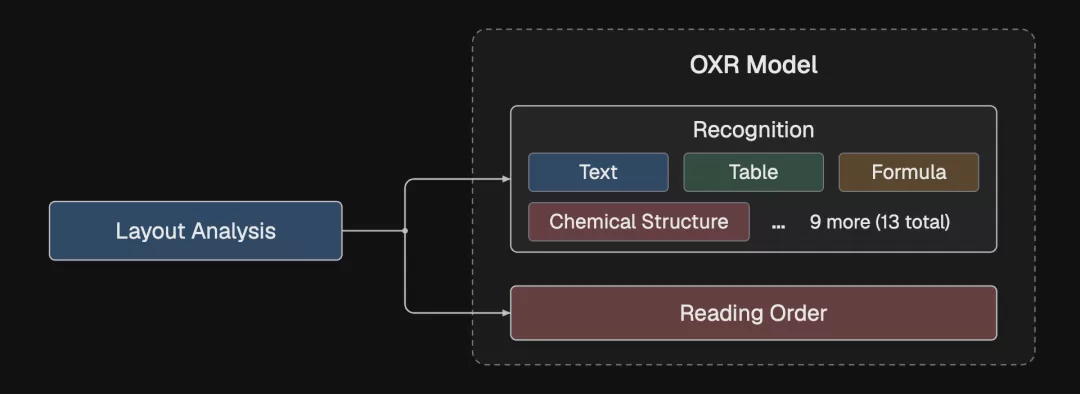
OXR 架构上主要做了两处减法:
1. 阅读顺序并入识别底座:它把阅读顺序判断直接交给多模态底座(SigLIP2 + Qwen 0.6B),识别文字的同时顺带理解上下文语序。一次前向推理直接出结果,少了串行等待。
2. 版面分析模块解耦(可插拔):把区域框选剥离成独立轻量模型。它只管判断这块是表格还是段落,不管阅读先后。企业如果版式特殊,单独微调这个轻量小模块就行,不需要重训底座。
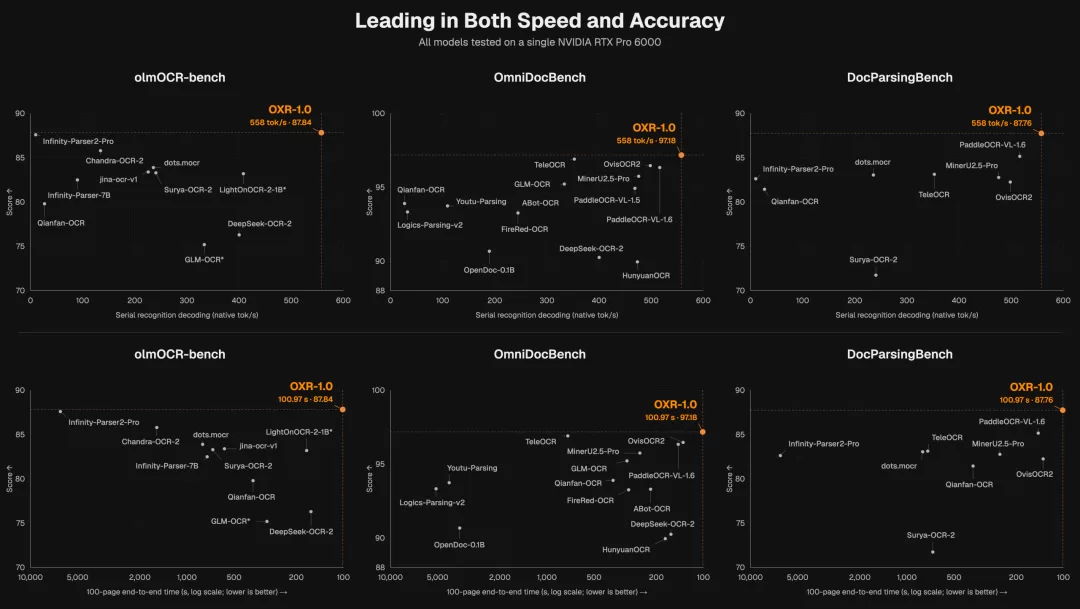
实测速度很猛:在 RTX PRO 6000 上它的串行解码速度达到 557 token/s,端到端每秒约一页;同行在单张 4090 上跑一份 17 页 PDF,速度能达到 618 token/s 左右。公有云调大模型上传加外网排队往往要 5–15 秒;而在本地机房单卡跑只要 1–3 秒,端到端真正做到了一秒一页。
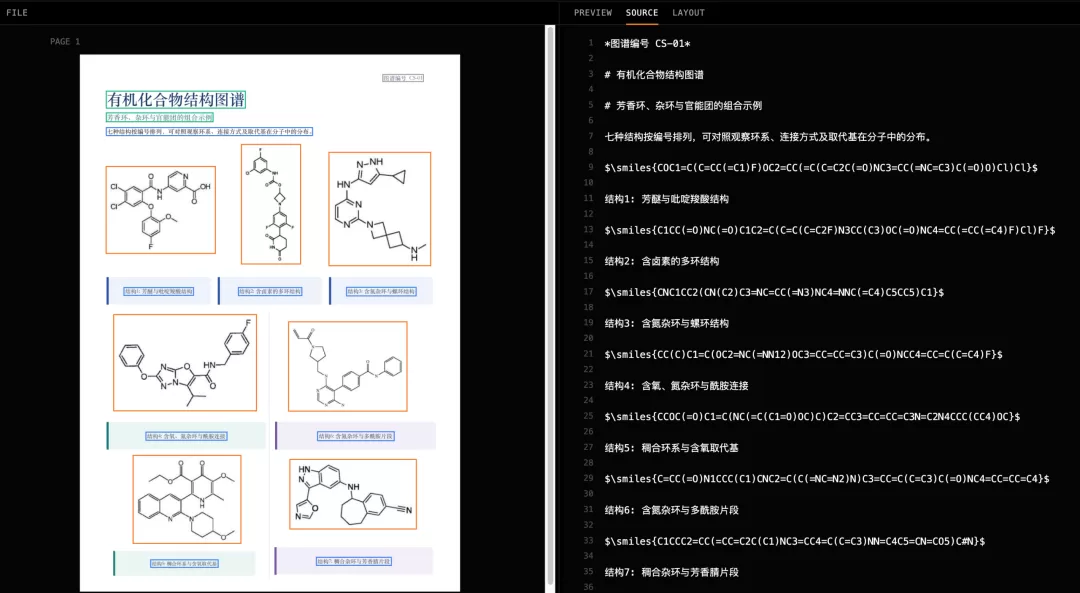
除了速度,支持的 13 类元素里有几个亮点,看下面这两组示例:
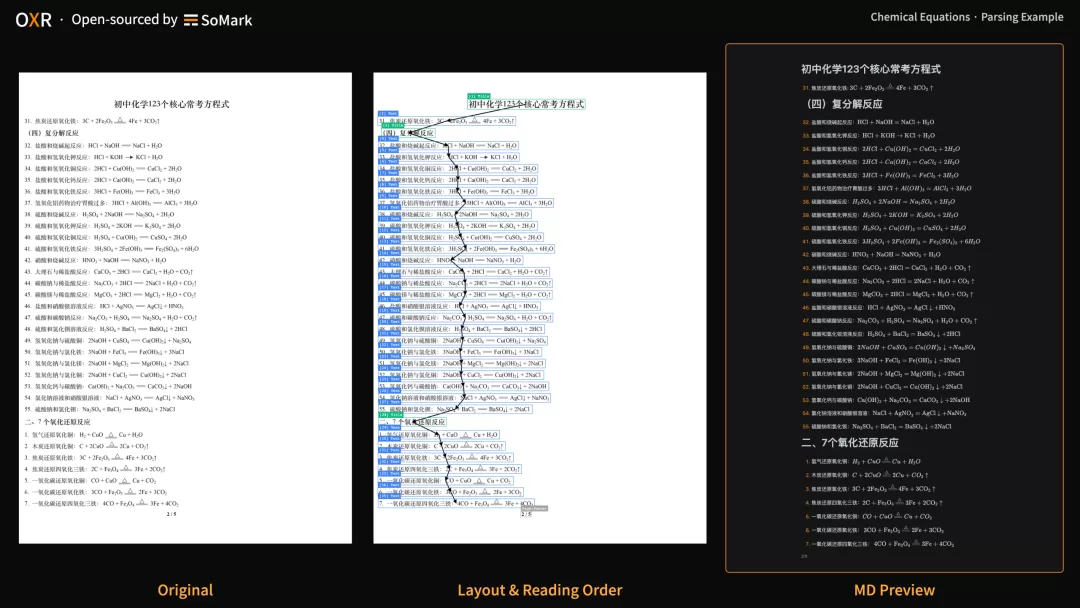
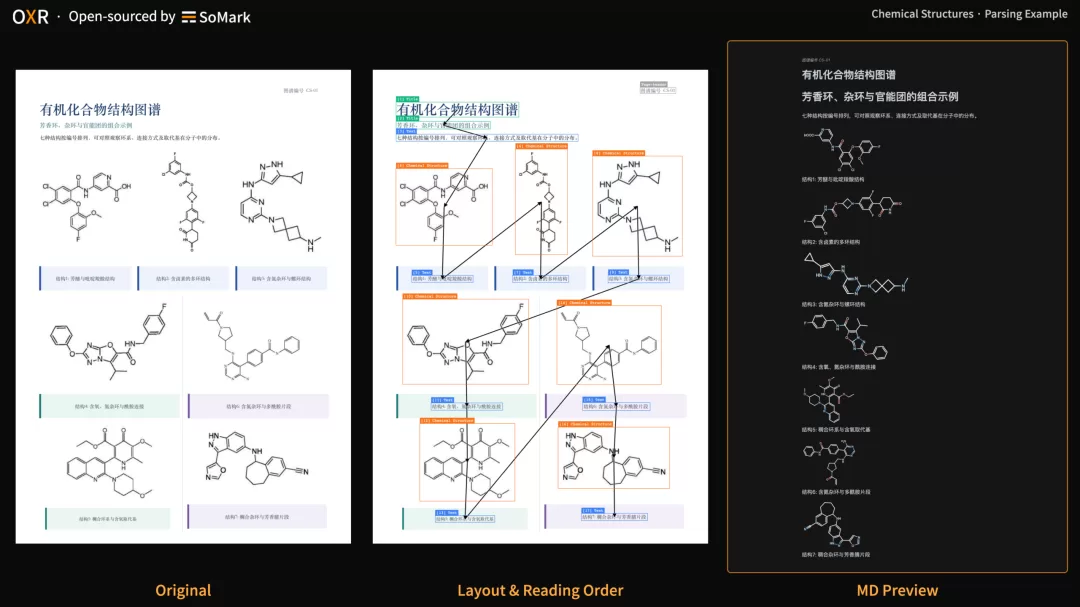
而且它不是截一张图片贴在文档里,是直接提取出标准的 SMILES 字符串,在网页端能直接重新把分子结构画出来,方便接入专业化学数据库。
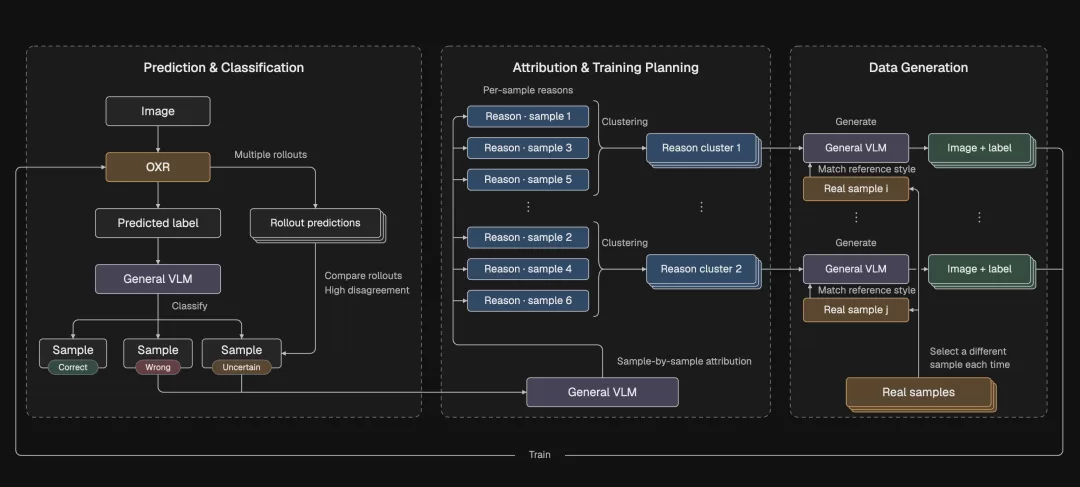
最有意思的是,OXR 的后训练过程采用 RSI(递归自我改进)模型。模型先跑未标注文档,借助大模型裁判与多次输出差异挑出弱样本;再用通用多模态生成渲染代码,批量合成真实版式数据进行填补,跑通了一套不需要外包人工打标的自我进化飞轮。(这好像也是全球首次把 RSI 用到文档解析领域的,有点东西!)
PART 02 样张实测:看看复杂版面解析效果
官方榜单归榜单,放到实际文档面前到底行不行?直接看样张的实测结果。
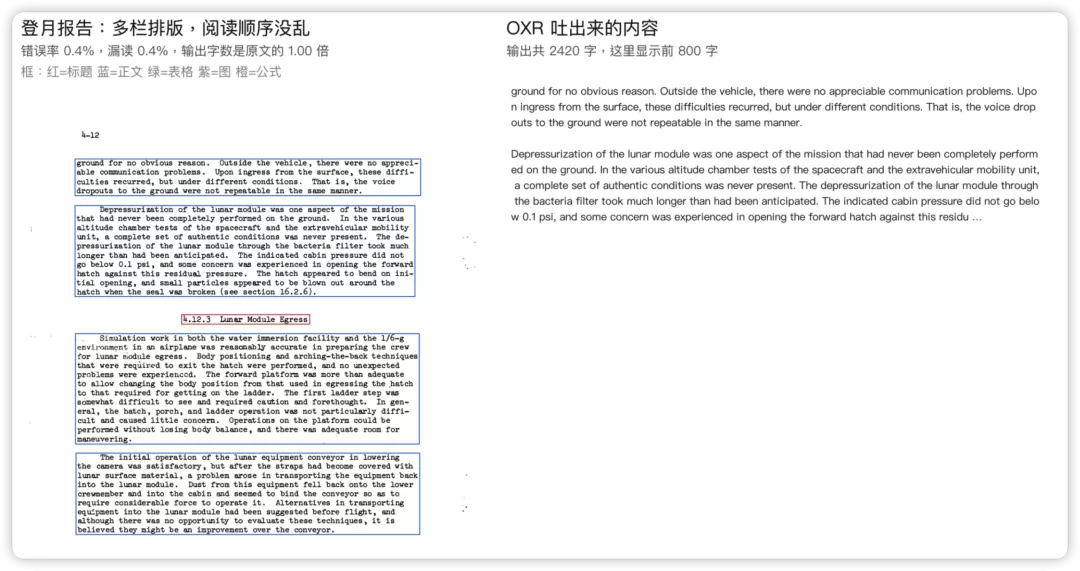
先看多栏和复杂版面,这是它的绝对主场。
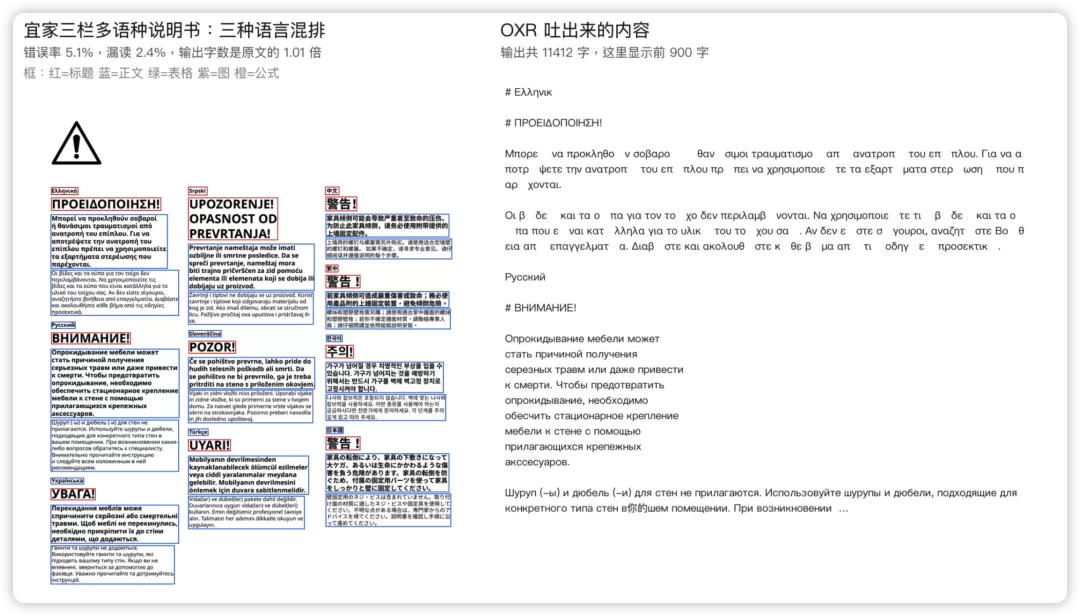
登月任务报告是典型的多栏混排,宜家说明书更是三栏三种语言挤在一页。看右边的解析结果,多栏文本完全是顺着自然阅读顺序排下来的,左右栏没有串联混读,字符错误率也压在 0.4%–5.1% 的极低范围。
既然多栏版面立得住,那放到更复杂的包装、折页和小票面前,跟其它主流模型对比又如何?我用 OXR、PaddleOCR-VL-1.6、Apple 自带的 Vision 模型以及 DeepSeek V4.1 Flash 对照了一批真实样张。我挑出 10 个最典型的真实工况场景:
CASE 01 低温作业告知卡(表格与小字)
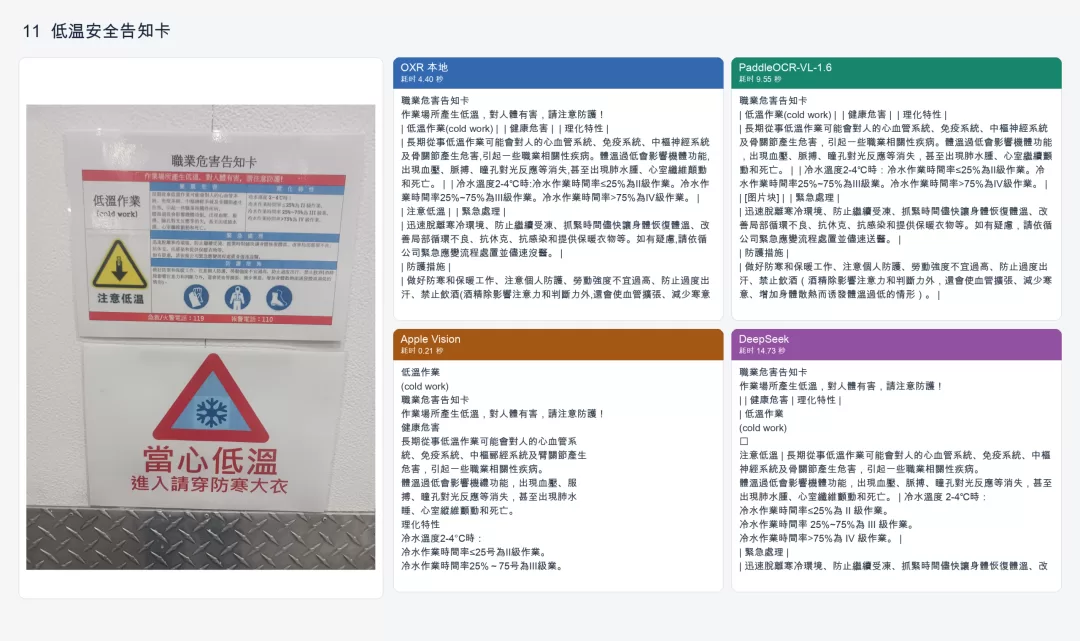
低温作业告知卡里既有表格、正文小字,也有警示标识。OXR 用时 4.4 秒,把健康危害、理化特性和紧急处理等内容提了出来,下方的提示语也识别到了。
CASE 02 食品包装营养成分表(曲面反光表格)
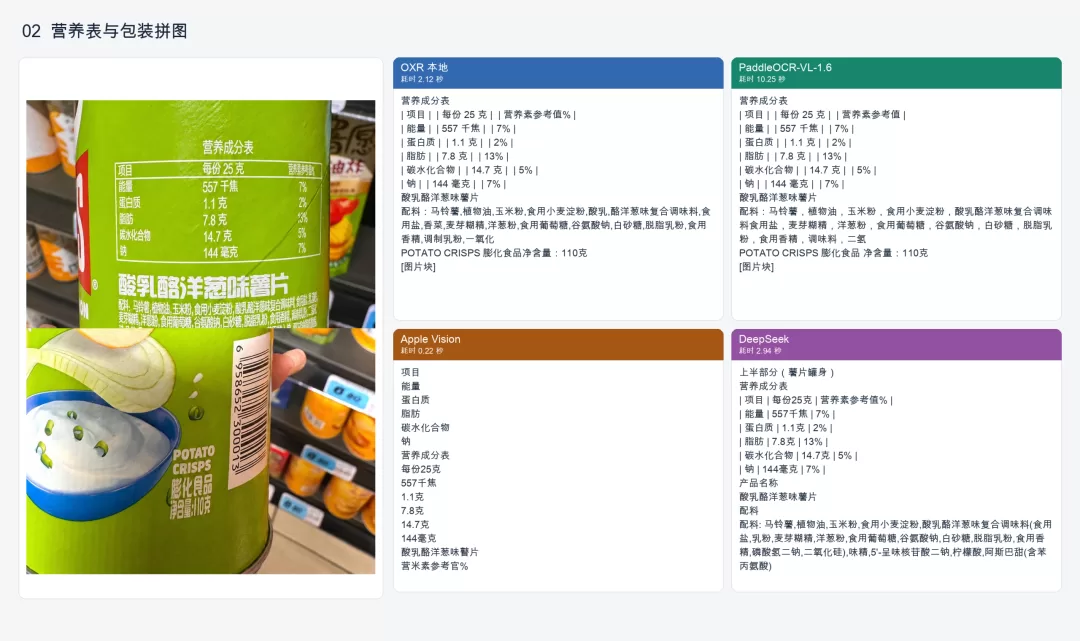
圆柱曲面反光与透视畸变。OXR 仅用 2.12 秒还原出规范表格,表头和营养数值对齐准确,没有跨列错位。
CASE 03 赛百味点餐小票(热敏纸与缩进)
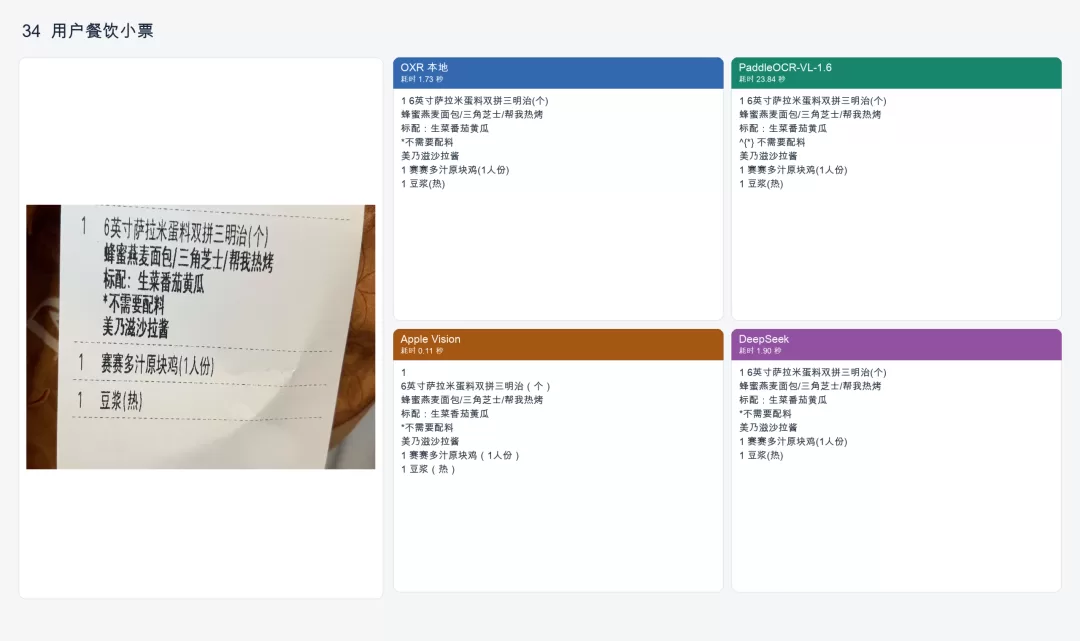
热敏纸字迹偏淡、纸张卷曲。OXR 1.73 秒读出面包类型、芝士和定制加料的层级缩进,能直接接进报销或进销存。
CASE 04 费大厨商场广告(倾斜拍摄)
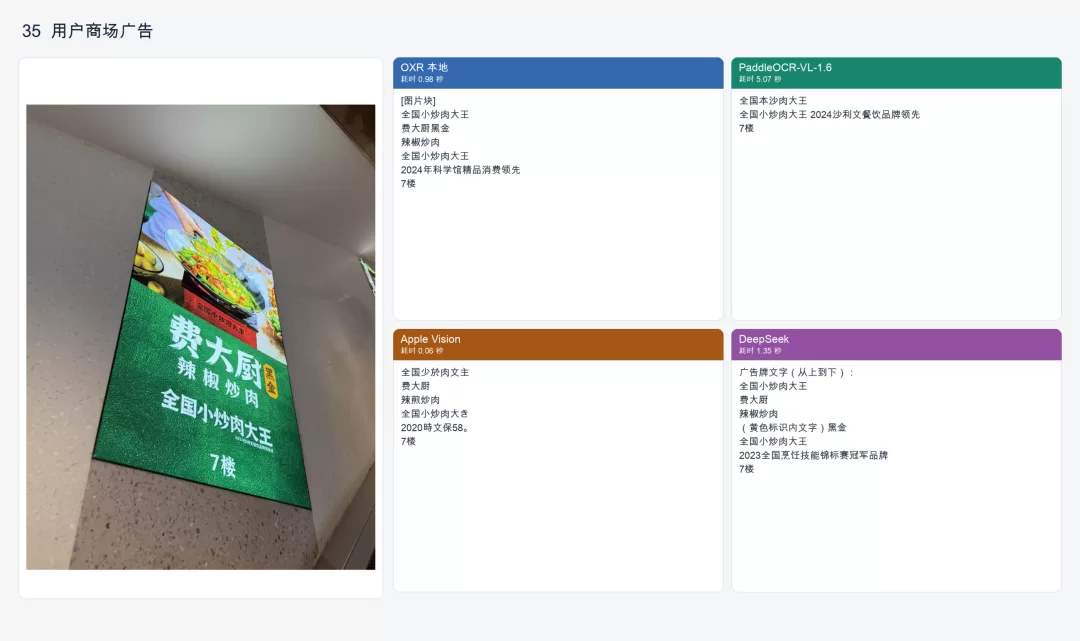
OXR 用时 0.98 秒,识别出了"费大厨""辣椒炒肉"和"7楼"。
CASE 05 广州地铁定额发票(红色印章压字)
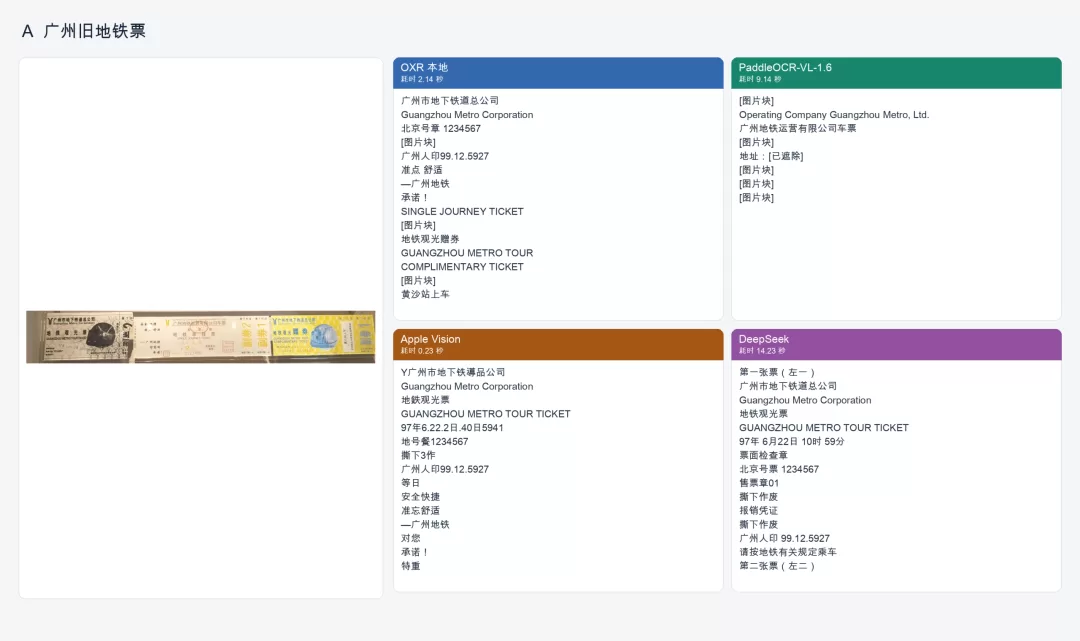
大红公章死死压在金额和发票代码上。OXR 2.14 秒完成识别,核心发票代码和金额都没被公章带偏。
CASE 06 华尔街日报中文版(极密排版与阅读顺序)
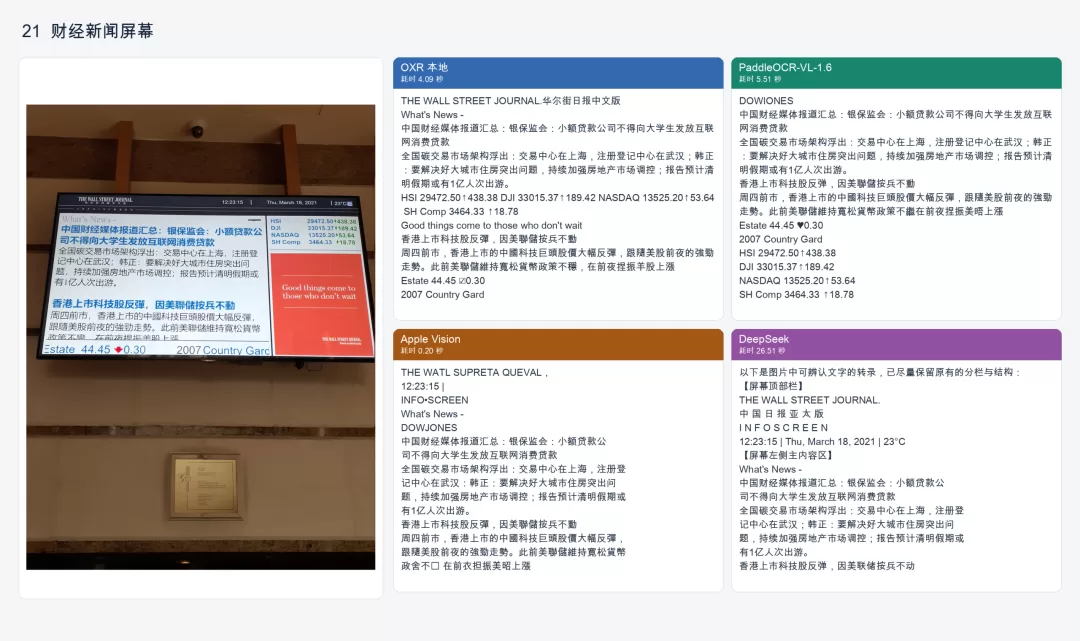
极密报纸小字多栏。OXR 4 秒顺着专栏读下来,多栏之间隔离清晰,左右没有跨栏混读。
CASE 07 珠海公交票(印章与票面文字)
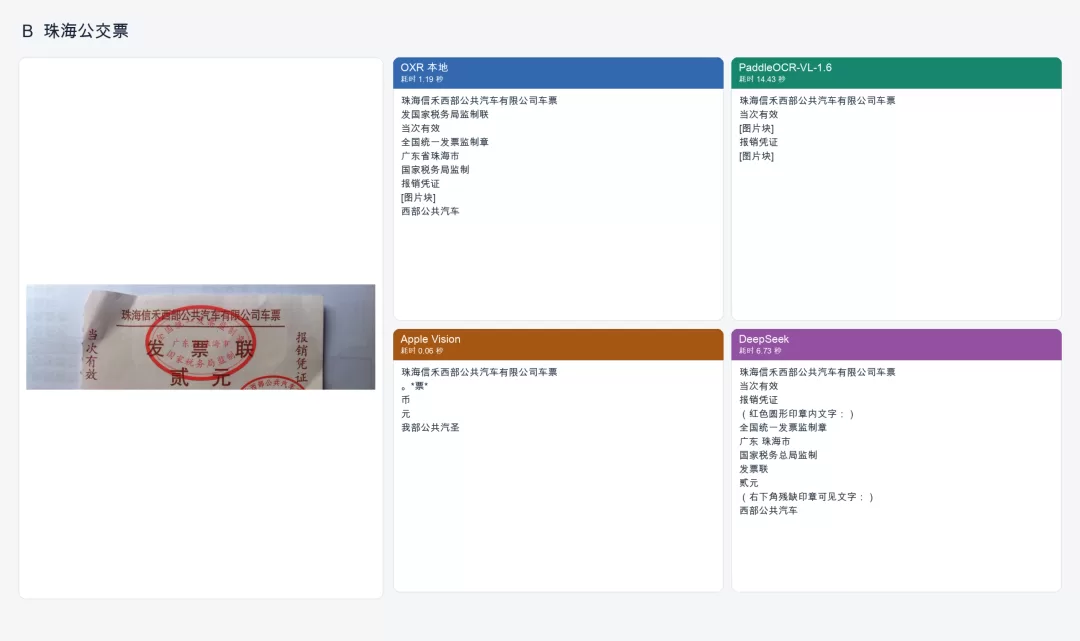
公交票上的红色印章叠着票面文字。OXR 识别出了"国家税务局监制";Paddle 把印章作为图片返回,DeepSeek 则多识别了一个"总"字。
CASE 08 武夷岩茶礼盒包装(书法艺术字)
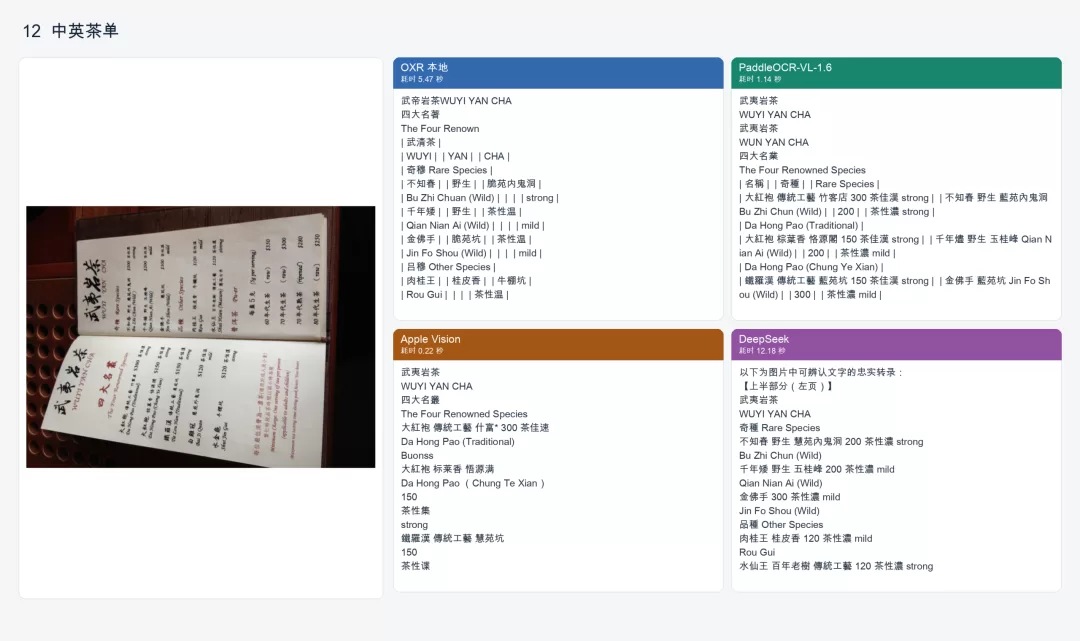
书法体与艺术变形字。OXR 5 秒内精准抓出"武夷岩茶"和茶品介绍,对艺术字体有不错的抗干扰能力。
CASE 09 食品营养标签(曲面小字)
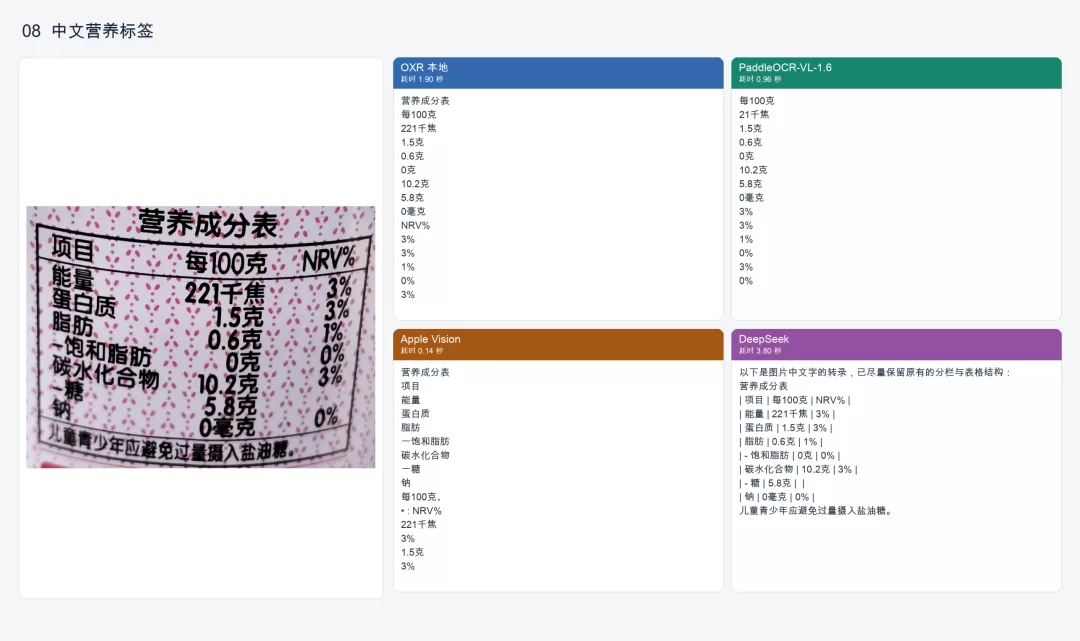
这张营养成分表印在弯曲的包装上。原图的能量是 221 千焦,OXR 和 DeepSeek 都读对了,Paddle 则识别成了 21 千焦。
CASE 10 高等数学公式课件(复杂符号推导)
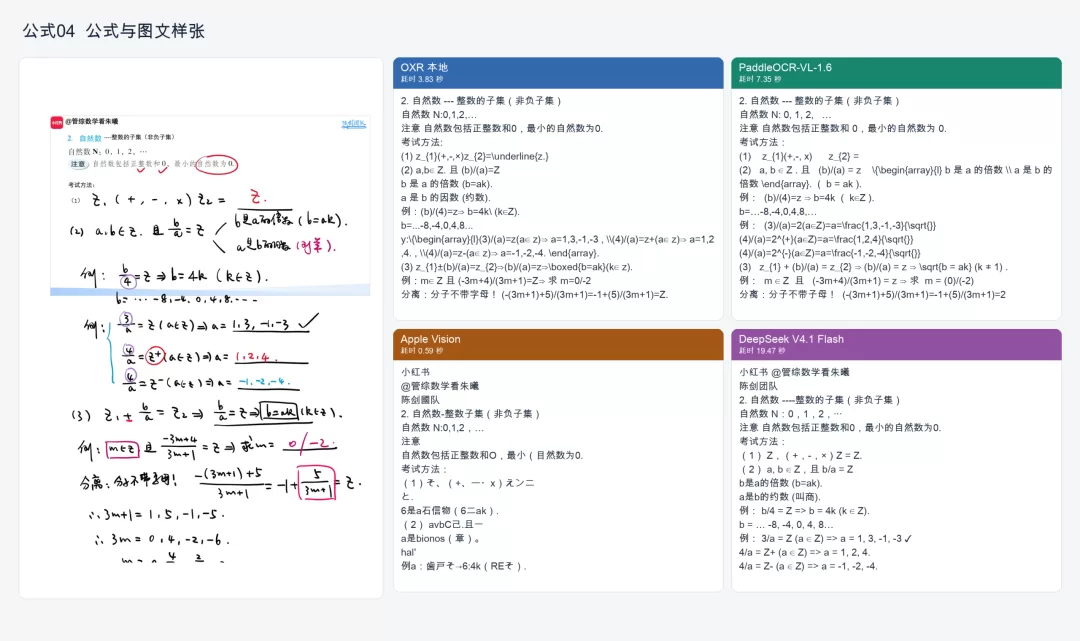
自然数集合、大括号与上标下标。OXR 直接输出标准数学表达式,没有变成一坨乱码。
看完这 10 个典型场景,简单做个小结:
- OXR(1.3B):最大的优势是本地跑、速度快、版面不乱。在多栏折页和密集小票上表现极稳,而且输出自带完整元素坐标。唯一的短板是在极端严重褶皱或红章重叠时容易重复输出内容。
- PaddleOCR-VL-1.6:同为开源选手,精度和基础认字都不错,但在复杂长文档和多栏排版上的吞吐耗时明显偏长(经常跑出 50–70 秒),多级表头和复杂结构偶尔会串行。
- DeepSeek(云端多模态):云端几百亿参数底子确实厚,很多弯曲和模糊字迹是靠千亿上下文语义给"脑补"出来的。但它必须把文件传出公有云并按 Token 付费,面对非常规的多栏排版也容易懵。
BOUNDARY 曲面畸变的边界
我很好奇对于这种曲面的情况,视觉模型测的效果会怎么样,于是我生成了不同曲度的图片来试试效果。
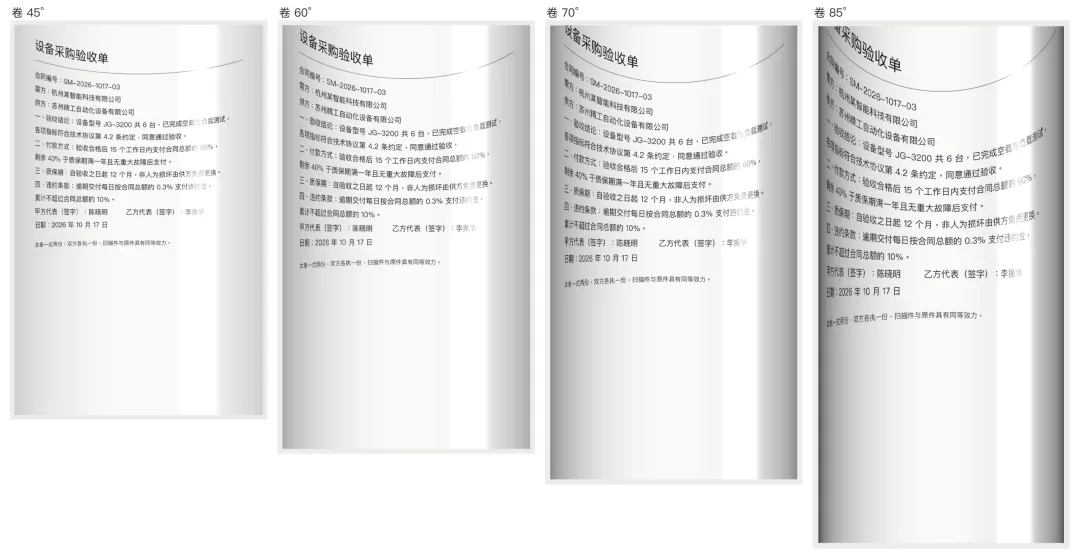
同一份文档,等比缩小宽度但不弯曲,识别错误率是 0%,但一旦弯到 60°,边缘由于透视畸变严重,模型开始整行漏字,到了 70° 以上,大半截内容就读不全了。简单总结就是:45° 以内的轻度弯曲放心用,角度过大任何小模型都救不回来。
PART 03 OCR 怎么应用到业务,该怎么避坑?
如果把这些 OCR 模型接入到业务系统里面,有几个工程化的思路可以去进行尝试:
STEP 01:前置加个"梯形校正"和转正。很多现场翻拍的单据,最大的问题是手机斜着拍带来的透视梯形失真,或者整页直接放反了。别让模型硬猜,在进入模型之前,前置写个轻量脚本做梯形纠偏与自动旋转,把纸拉平,模型的识别准确率能直接从翻车边缘拉回满血状态。
STEP 02:复杂版面可以先尝试自动解析。像论文双栏、说明书三栏、多级表格这种复杂版面,可以先用 OXR 进行解析,再结合业务需求检查阅读顺序和关键字段。
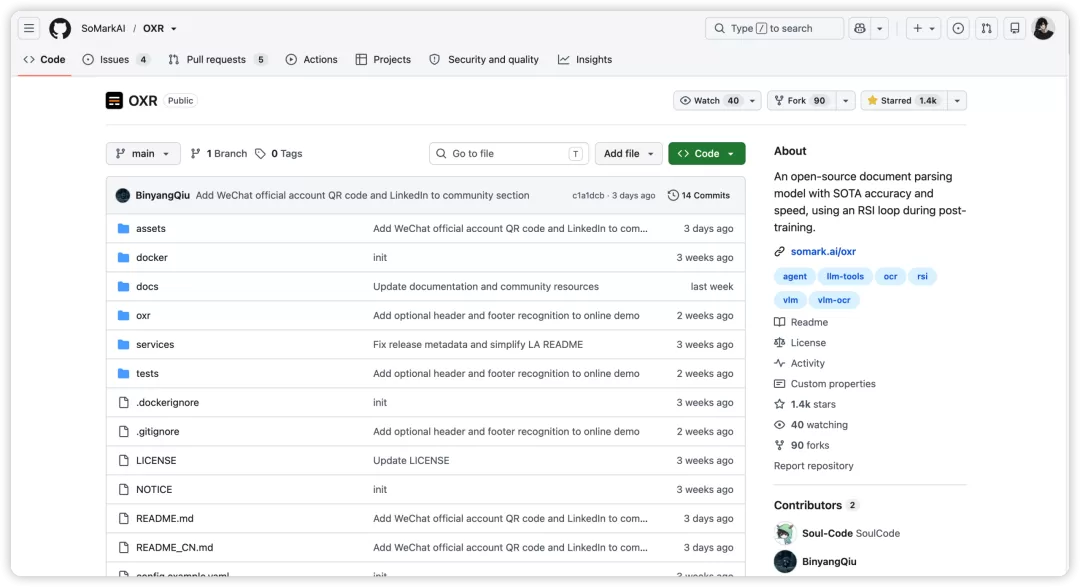
STEP 03:怎么用上它?代码和权重都已经完全公开,在 GitHub 和魔搭社区直接搜 SoMarkAI/OXR 就能找到。它自带现成的 Docker 镜像,单卡 24G 显存就能直接拉起,打开本地网页就能直观对照原图、识别出来的 Markdown 以及阅读顺序标记:
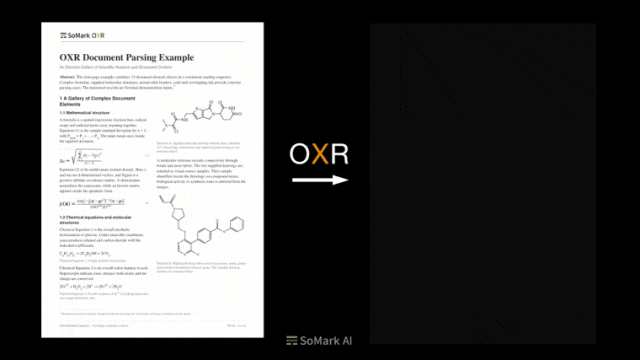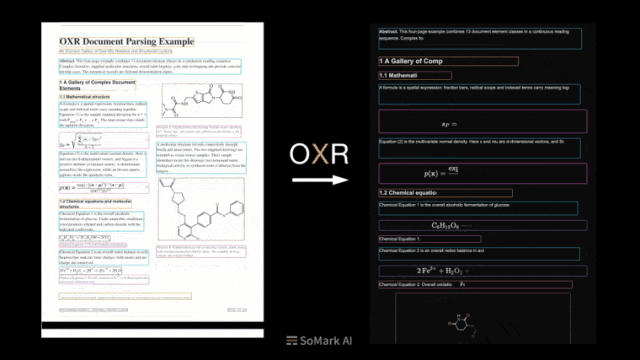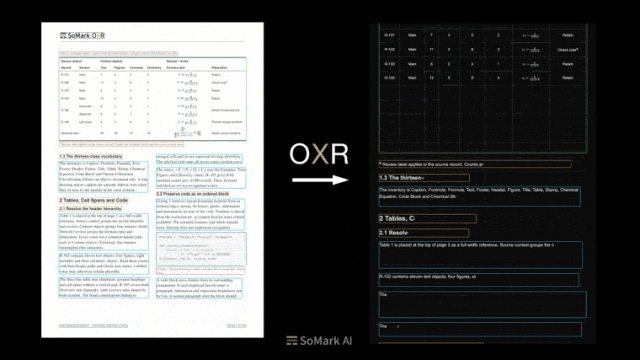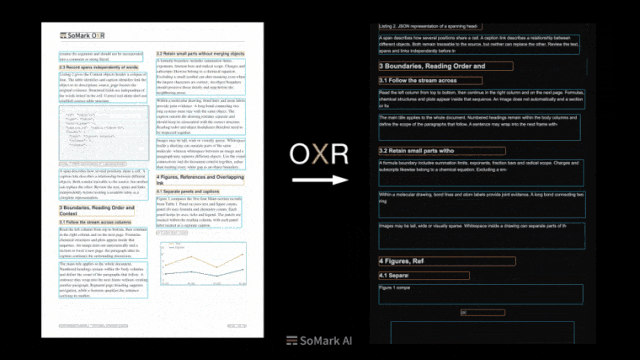
写脚本批量跑的话,官方也提供了配套的 Python 工具包,几行代码就能搞定。顺带提一句商用门槛:采用的是修改版 Apache 2.0 协议,公司内部可以私有化部署、处理内部文档;但商业使用时,如果企业及关联方的累计融资或年营收超过 200 万美元,或者打算对外提供与官方竞争的云端接口,就需要跟官方单独谈商业授权了。
PART 04 算清本地与云端
回到最开始的问题:有了多模态大模型,我们为什么还需要这样一个 1.3B 的小模型?什么时候选公有云,什么时候该上本地解析?算笔账就知道了:
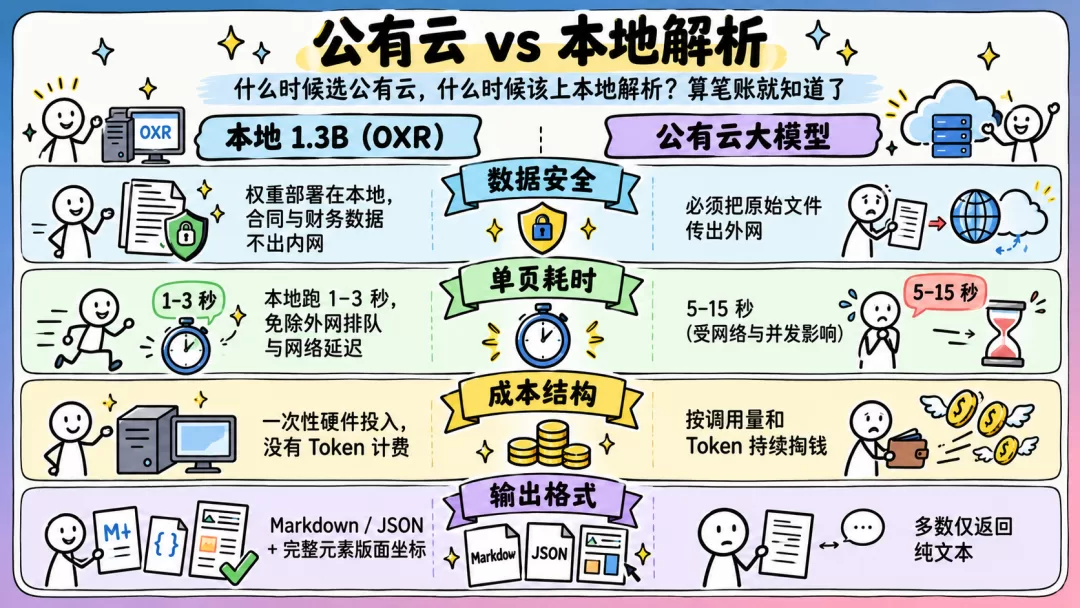
在真实的企业业务现场,算力有限、数据敏感、效率优先才是常态。如果你的业务涉及大量商业红线、不想承担持续的 Token 账单,下游知识库又严重依赖原件坐标去追溯答案,那这个能塞进单张 24G 显存、一秒吃一页的本地模型,就是目前性价比极高的数据管道入口。
这才是真正能落进业务流水线里的 AI 工具。反正已经开源,大家不妨去试试看。