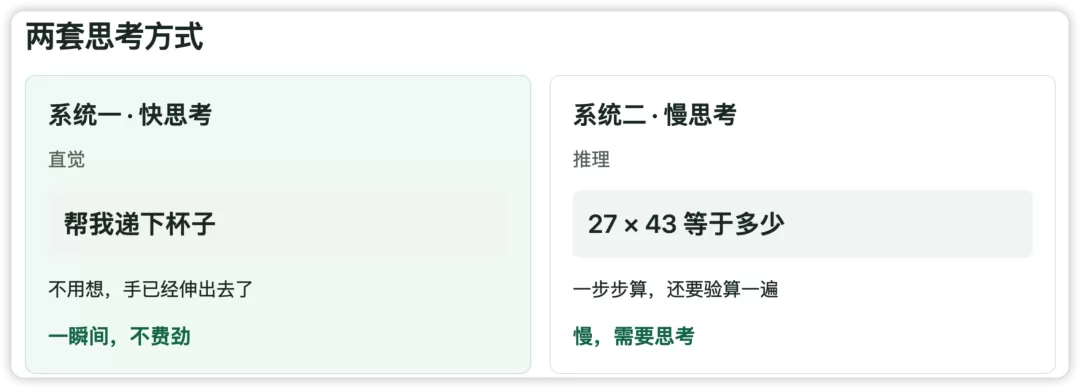
前段时间聊到 Jev 和 Instinct 时提到人脑的「快思考与慢思考」:大模型擅长一步步推理的慢思考,但业务里海量的活其实只需要快判断。
让大模型来做这种判断,就像每次递杯子前都先写一份分析报告——慢,而且贵。
不过在真实的业务里,光做选择题往往不够用。用户说「订单 445566 到哪了」,系统不仅要知道他是要查物流,还得把「445566」这个单号一并抽出来,后面的工单才能跑通。
中电信星辰实验室开源的意图理解专用模型 Xing4.0-29B-Intent(简称 Xing),补的就是这后半步。
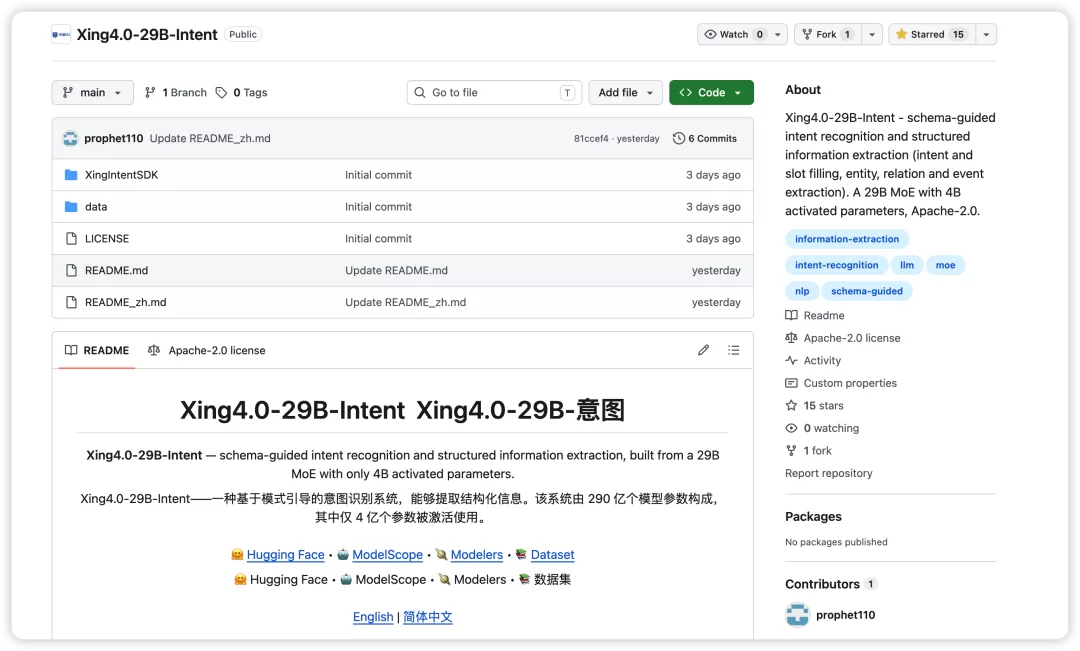
项目地址:github.com/XingChen-AGI/Xing4.0-29B-Intent
又一个专门用于意图判断的小模型,不同的是它既能做选择题,也能做填空题——在做分类判断的同时,把关键参数一并提出来。
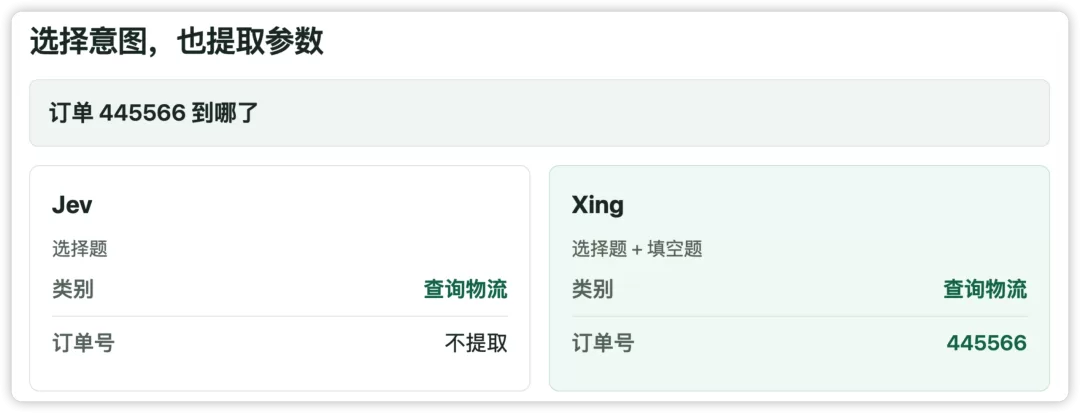
这里的「意图」指用户想办什么事;「参数」指办这件事需要的具体信息,比如订单号、时间、地点。
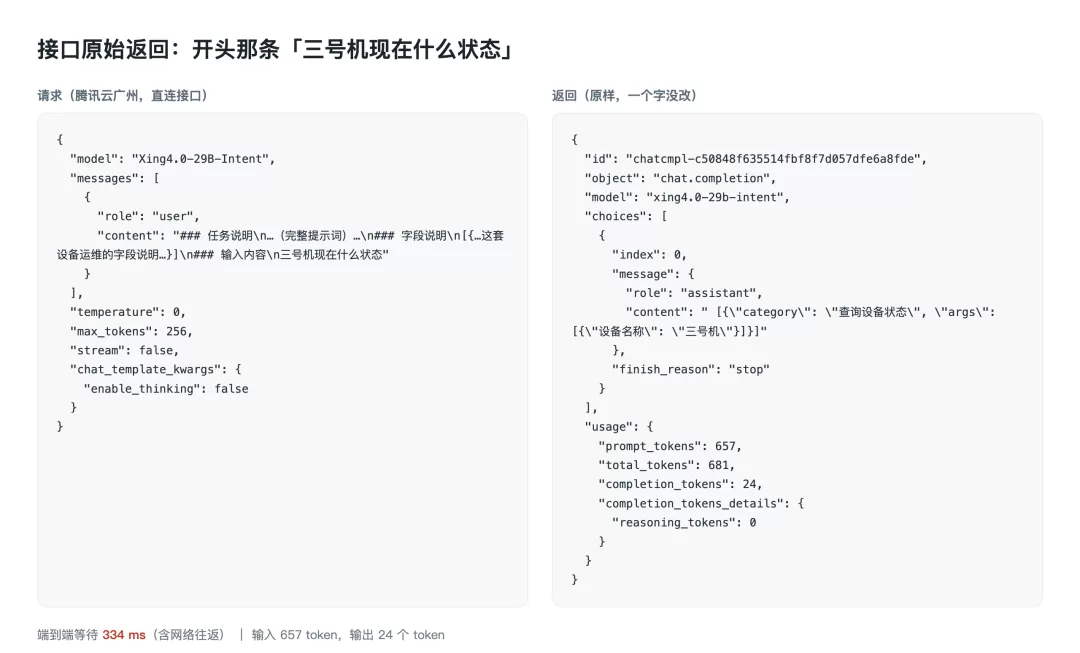
第一条请求从广州的腾讯云服务器发出,到收完整个 JSON 一共 334 毫秒,差不多眨一下眼的工夫。这是算上公网和网关的端到端时间,模型自己推理那一段还要更快。
整体实测下来效果很稳,Xing 模型不仅分得清要干嘛,具体的设备和时间基本都没填错。
AI 的系统一,是怎么分出来的
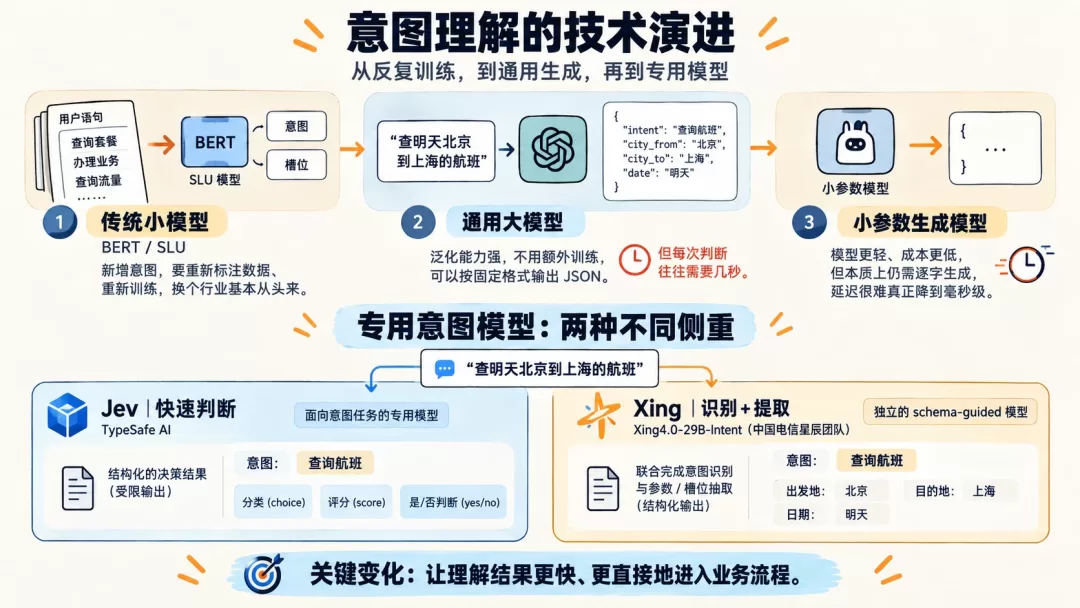
在 2022 年大模型大火之前,意图理解在业务里就一直在用。电信客服等场景早前主要靠 BERT 这类小模型来给意图和槽位打标。但每加一个新意图都要重新标数据、重新训练,换个行业基本得从头来。
大语言模型出来后,泛化能力极强,不用额外训练就能识别各种复杂意图。于是大家开始让大模型按固定格式输出 JSON,程序拿到再去执行。能用了,但每次判断要等好几秒。
所以把系统一单独拆出来的路线成了行业新解法:先是 Jev 专攻极速判断,紧接着 Xing 补全了参数提取,把填空题也一起做完。
Xing4.0-29B-Intent 基于 Xing4.0-29B-A4B 微调,每次推理只调用其中的 4B。星辰实验室直接把全家桶开源:训练语料、模型权重、推理 SDK 和部署镜像全部公开。
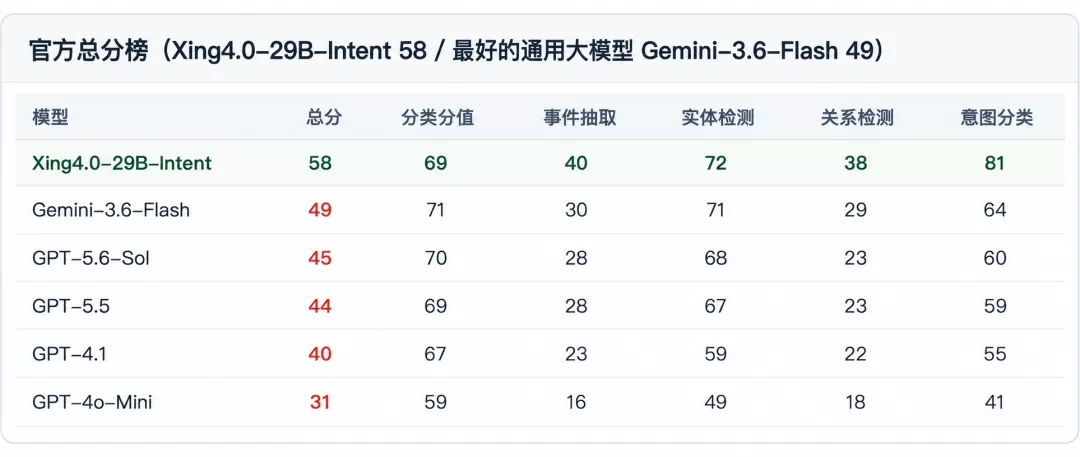
在官方评测里,它的严格全对总分达到了 58,而海外通用大模型中最高的 Gemini-3.6-Flash 是 49。差距主要在参数提取上。
基础测试:写一份说明就能用
要想用 Xing,得先给它写一份说明,交代清楚有哪些意图、什么样的话归入这个意图、需要提取哪些参数,再把用户说的话一起发给它。
CASE 01:设备运维
拿工厂设备运维场景试了试,写了一份说明:四类意图加一个兜底,分别是查设备状态、报设备故障、查工单进度、调运行参数。20 道题,意图和返回格式全部答对。
时延方面,从广州的云服务器发出,保持同一个连接、一条接一条地发,中位数是 372 毫秒,最快 238 毫秒,最慢 655 毫秒。
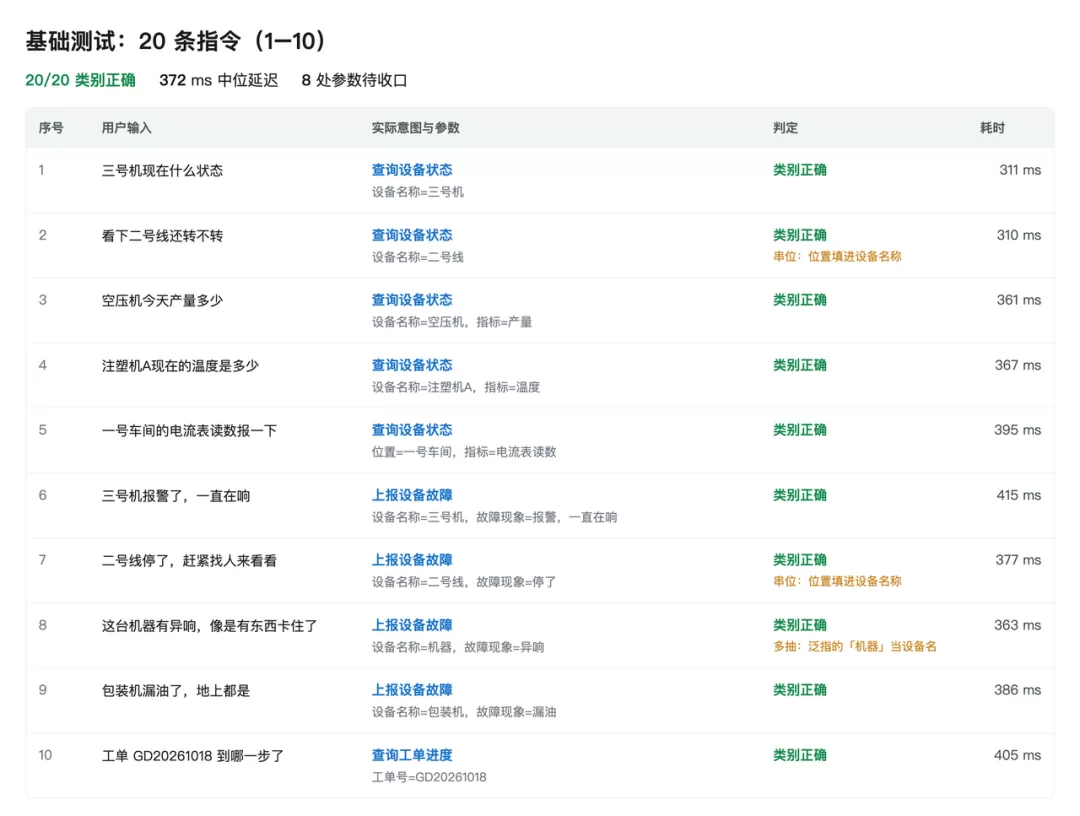
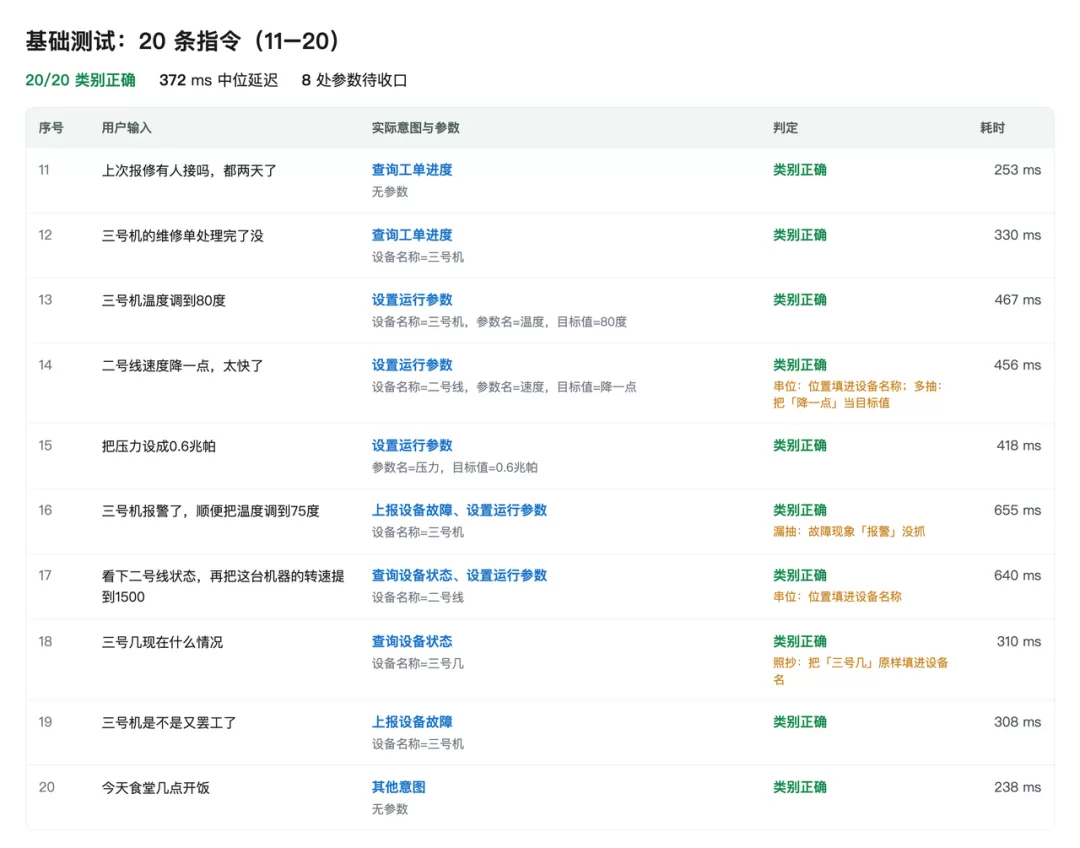
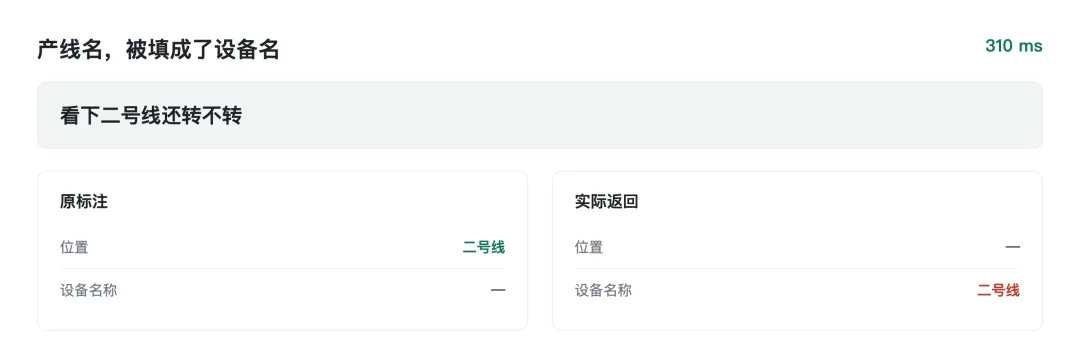
不过参数提取这块还是翻了车。20 条里有 8 条没填干净,比如下面这条,它直接把产线名「二号线」错填进了设备栏。
CASE 02:智能家居
不管用户口语怎么表达,电器的开关、模式调节和设备状态查询都很明确,天然适合交给这类模型来处理。24 条指令,对了 23 条。
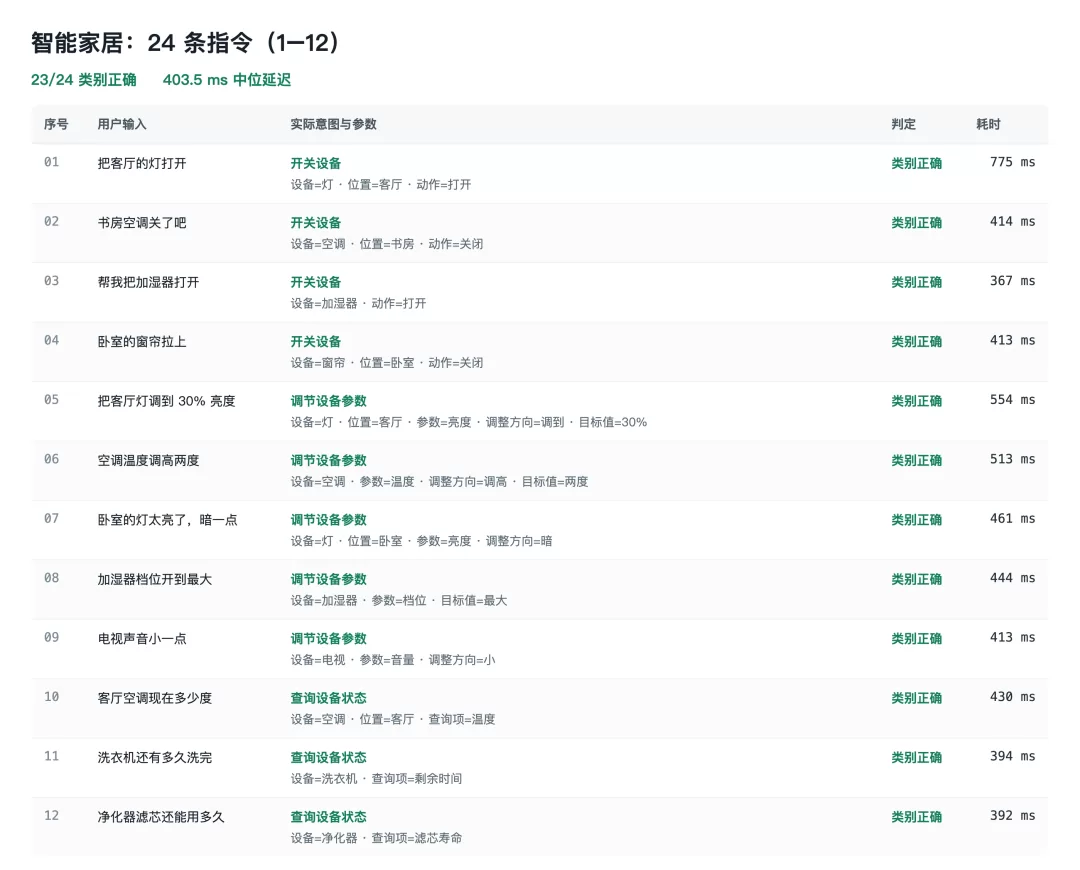
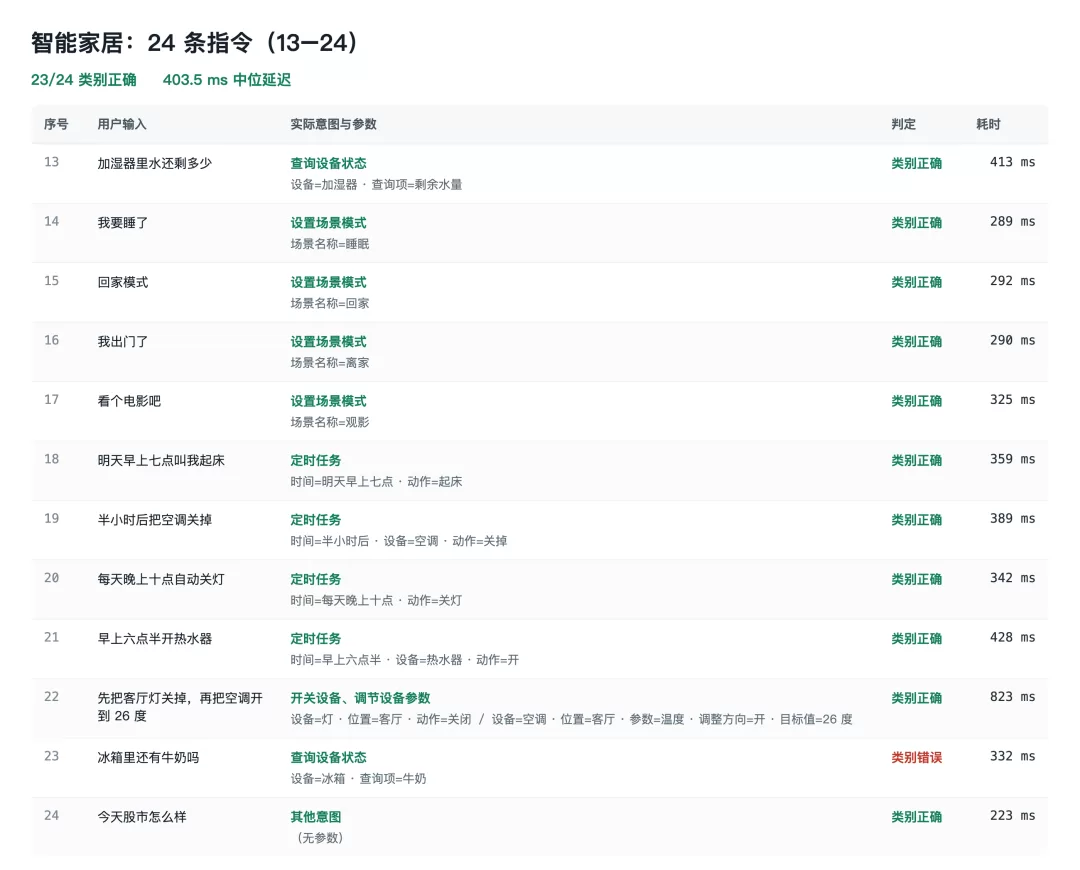
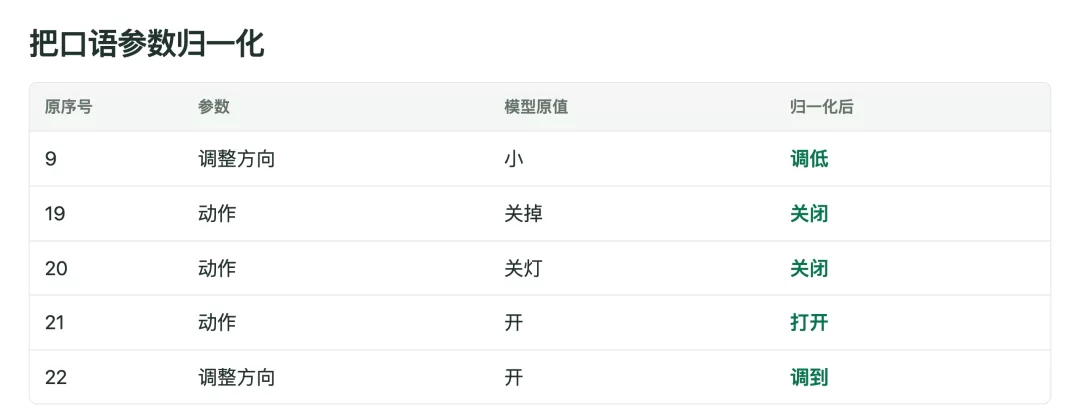
唯一错的一条,也是因为说明里两个分类的边界没写干净。另外它偶尔会沿用口语,比如该填「关闭」时填成了「关掉」,执行前加一步简单的词表归一化就能解决。
智能客服:不用来回答,用来打辅助
换成 Xing 这种专用系统一之后,最大的改变就是速度:响应基本是秒出(四五百毫秒)。拿企业客服说明对应的常见业务测了 14 条,意图判断对了 12 条。
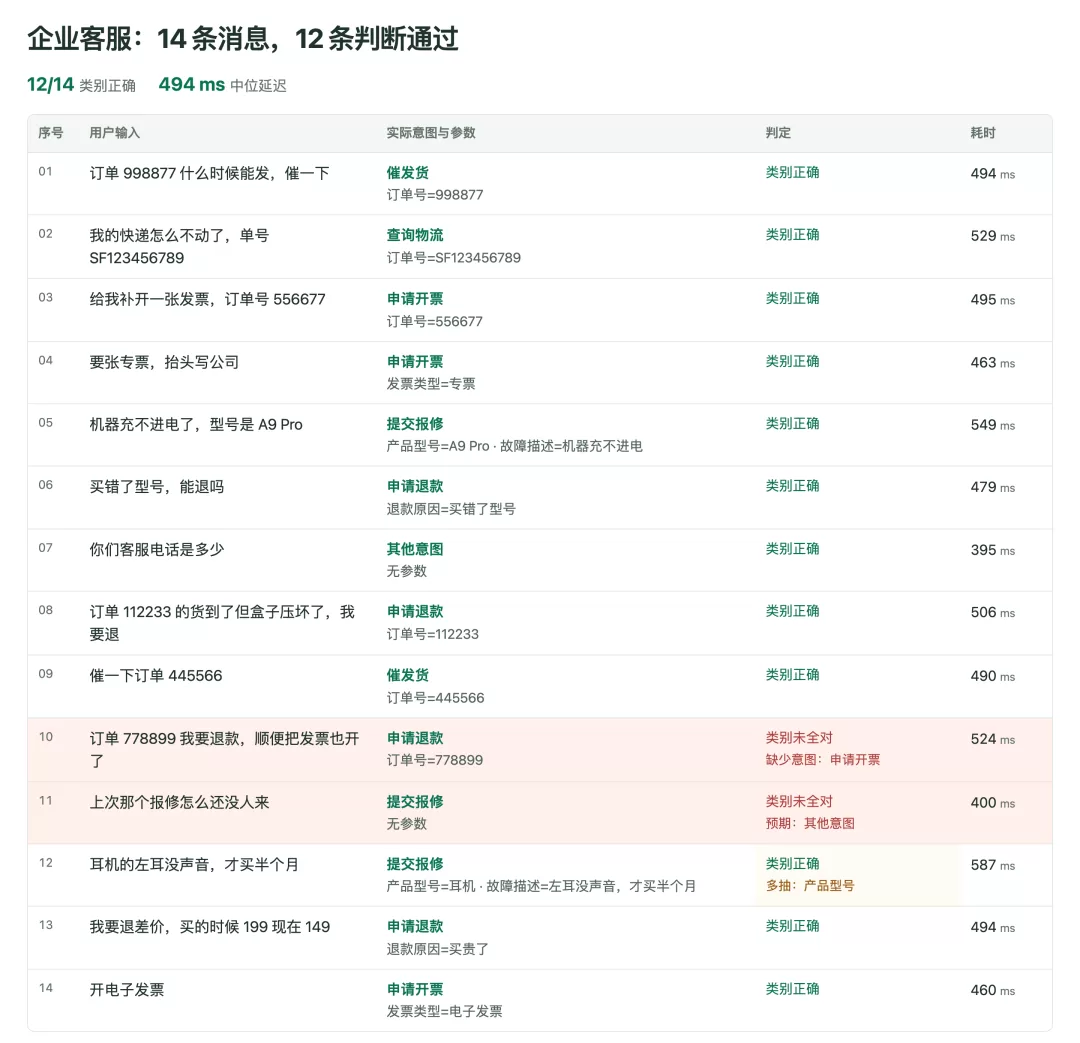
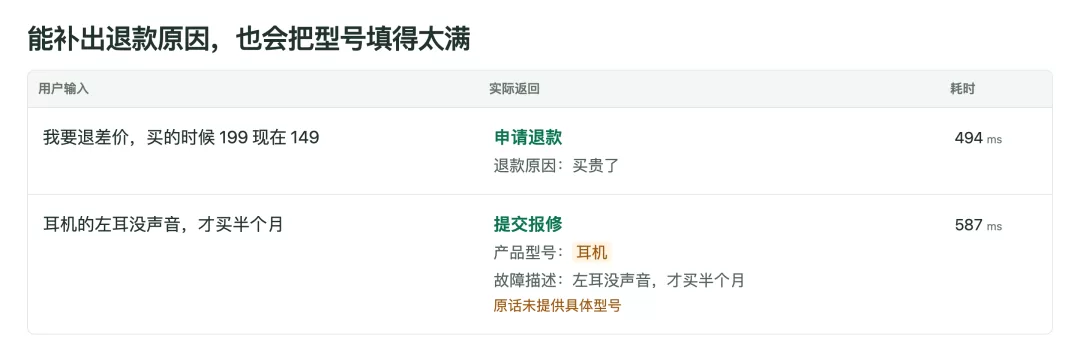
泛化太强偶尔也会过度脑补:比如「耳机的左耳没声音」,用户没提具体型号,它太想把参数填满,顺手把「耳机」俩字填进了型号栏。这类小失误在工程上加一道后置规则就能解决。
比起一味强推全自动的智能客服,让 AI 在旁边给真人打好辅助、秒级提供对应材料,提效反而来得更快、更稳。
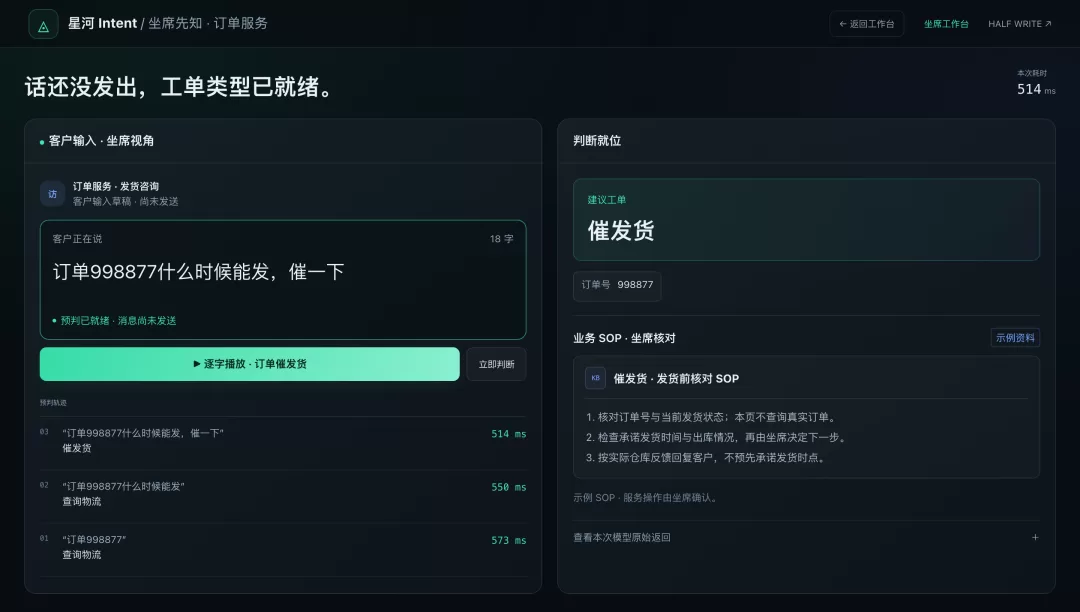
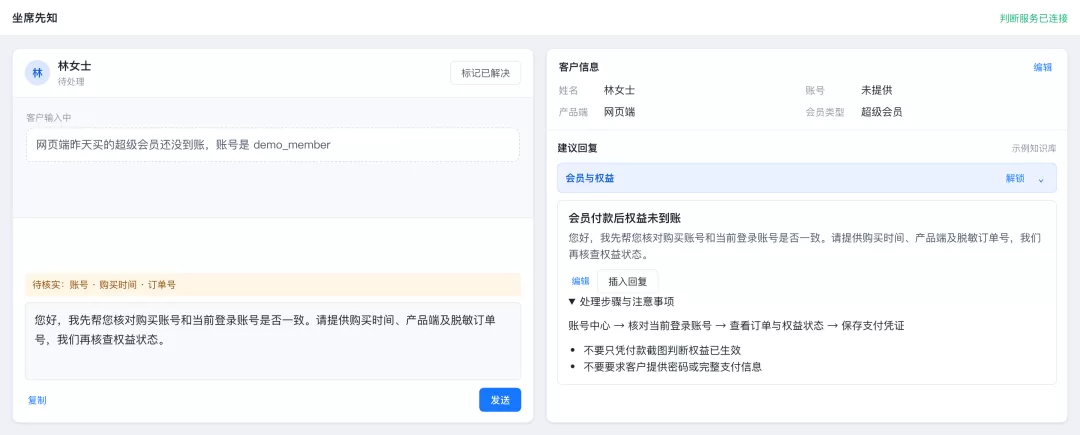
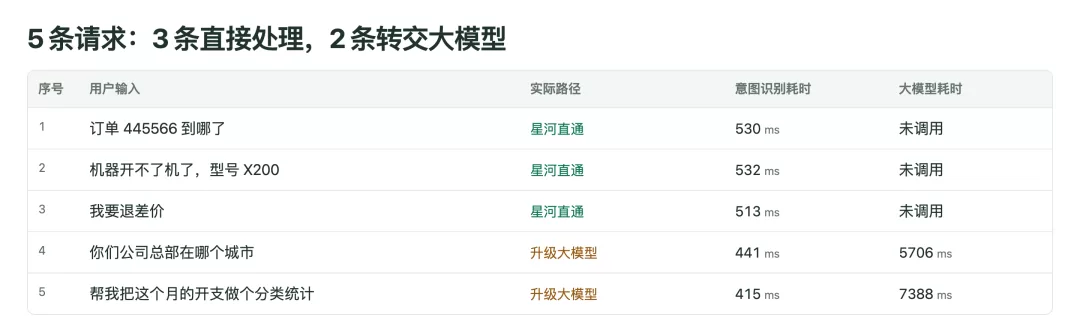
如果遇到更复杂的需求,也可以让模型判断之后,直接把问题上升到更大的通用模型(比如 Kimi K2.8)去做深度推理。
输入框变成工具:逐字路由 + AI 伴写
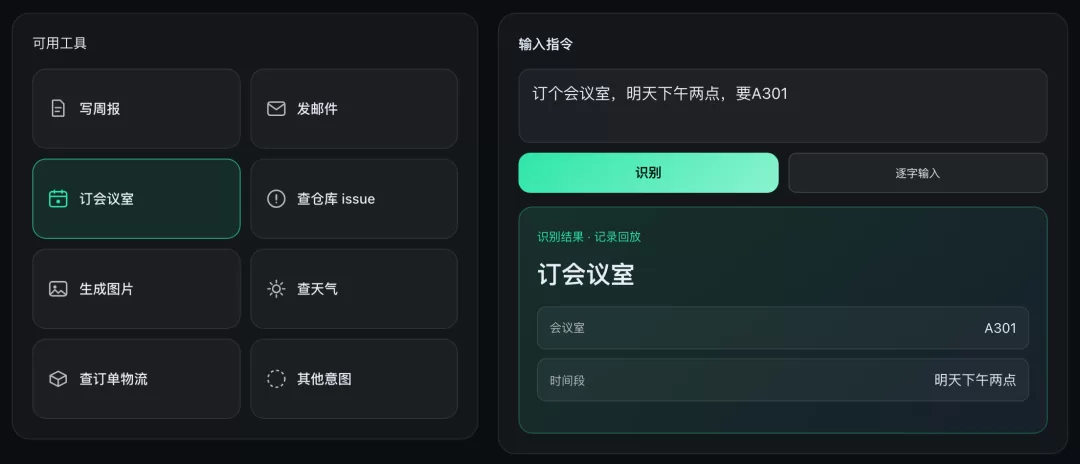
用 Codex 做了一个网页版的 demo,比如上一句刚聊完项目周报,接着只敲了「发给」两个字,后台就预判出发送消息的意图,并把「项目周报」抓取并填进了参数栏。
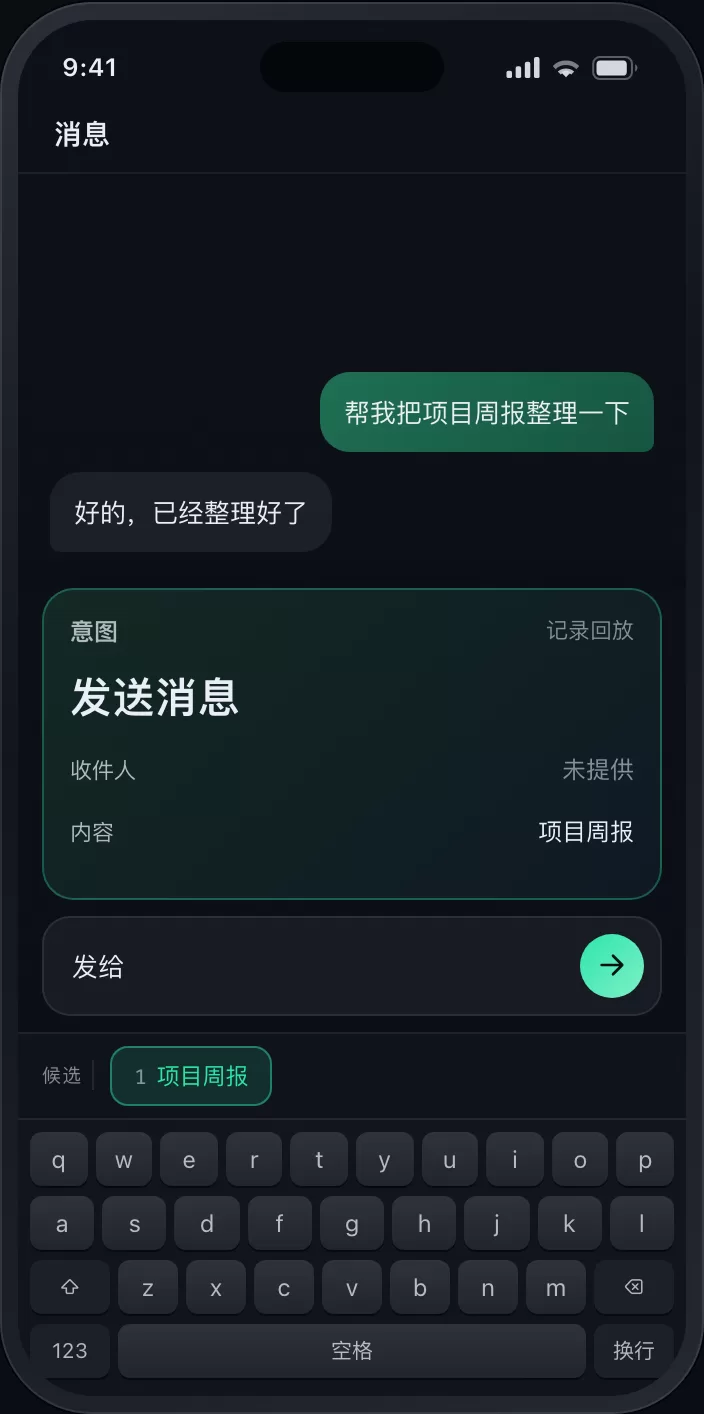
敲一个字发一次请求,四五百毫秒就能返回。
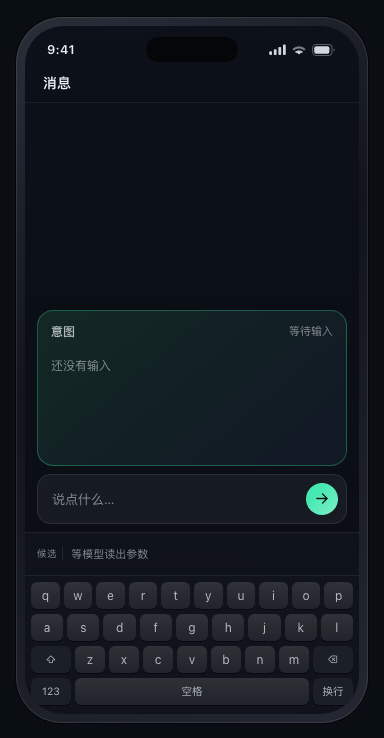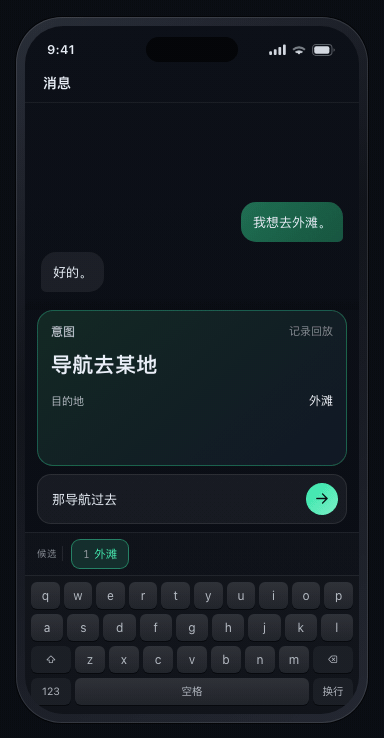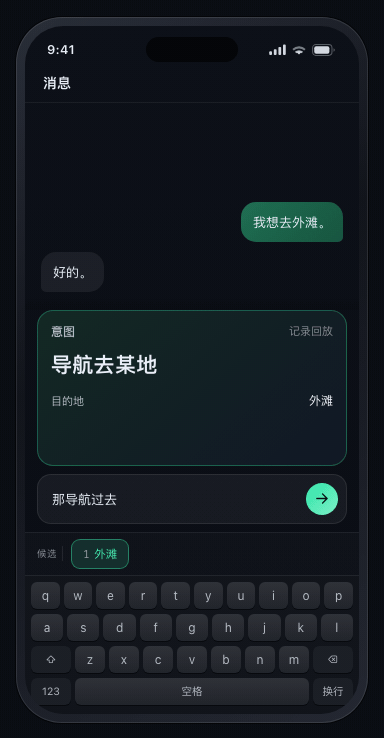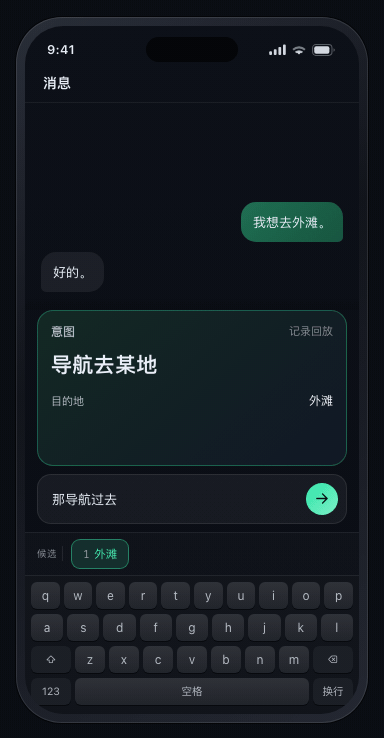
这种预判本质上就是把 Agent 的工具路由直接做进了输入行。键盘刚敲到「订个会议室」,后台就已经锁定了会议室工具。
落地前的取舍
实测时有个很有意思的细节:因为直连官方 API,响应速度太快、调用太密集,测试时甚至好几次把接口给打熔断了。
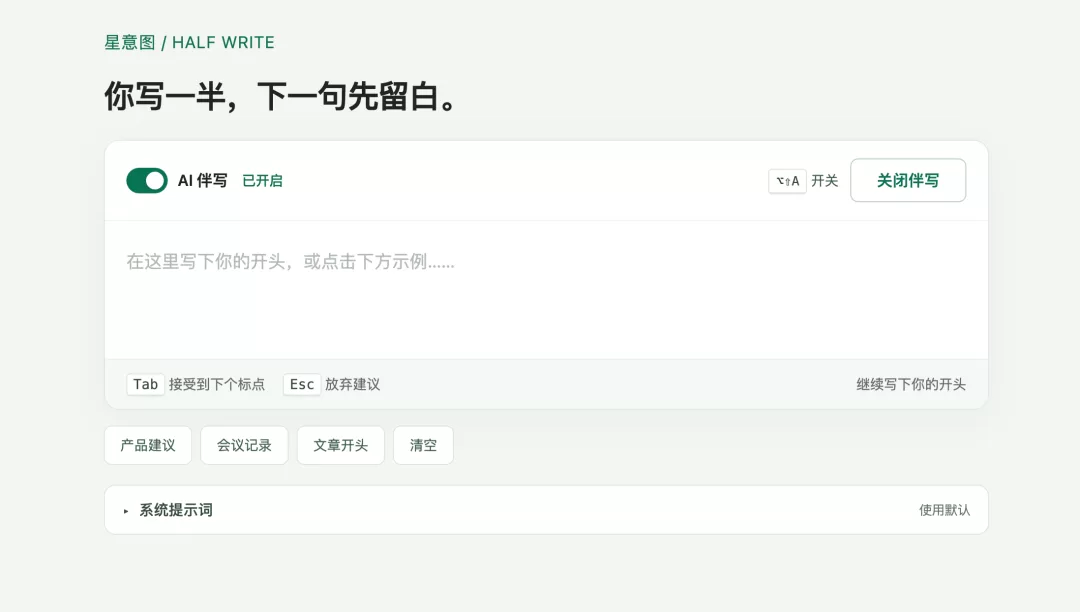
不过抛开频控限制,实际用下来体感非常丝滑,键盘敲击只要稍微一停顿,光标后立刻就会浮出一行灰色的短句建议。
总结
Xing4.0-29B-Intent 代表了一条清晰的技术路线:把「系统一」从大模型中独立出来,专攻毫秒级的意图判断和参数提取。对于语音助手、智能客服、智能家居等强业务场景,这种「快思考」模型能在几百毫秒内给出结构化结果,让程序直接读取并执行。
它不是大模型的替代品,而是大模型的加速器——把即时判断的活交给小模型,把复杂推理的活留给大模型,各得其所。