大家每天刷短视频,有不少是 AI 配音的。AI 声音背后用到的技术,就是 TTS 模型(Text-to-Speech,文字转语音)。
现在 TTS 完全到了以假乱真的程度。TTS 和图像、视频、文字模型相比,最大优势就是可以在本地电脑跑最顶级的效果。
这是我拿自己声音克隆的一段视频,给朋友看,他们都说听不出来是 AI 做的。我也在社媒上分享过一个 TTS 的用法。
当然,真正的用途还是用它来做视频。这期就来做一个 TTS 模型大评测,以及推荐几种免费使用 TTS 模型的方式。
01 TTS 简介
TTS 是 Text-to-Speech,意思是文字转语音。输入一段文案,它就能生成朗读音频,有默认的声音,也支持声音克隆,用接近你自己的声音来读。
TTS 模型基本都能在个人电脑上运行。我自己用的是 Mac M4、32GB 内存,就能跑千问和 Index 团队的模型。
最近比较火的"Vibe 知识大赏",用网页代码制作知识动画,配上自己的声音,一个人也可以完成优质视频。整个制作流程完全由 Agent 完成,你只要说你想做什么,它就会按这个流程执行:
写脚本 → 输出配音 → 制作动画、安排背景音乐 → 合成视频。
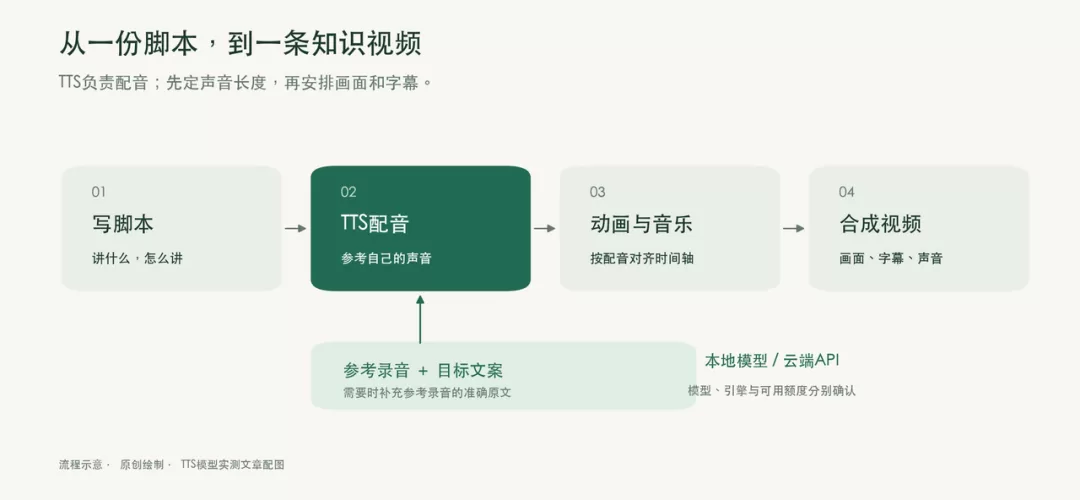
配音就是用 TTS 模型,有两种方式调用:本地模型和云端 API。
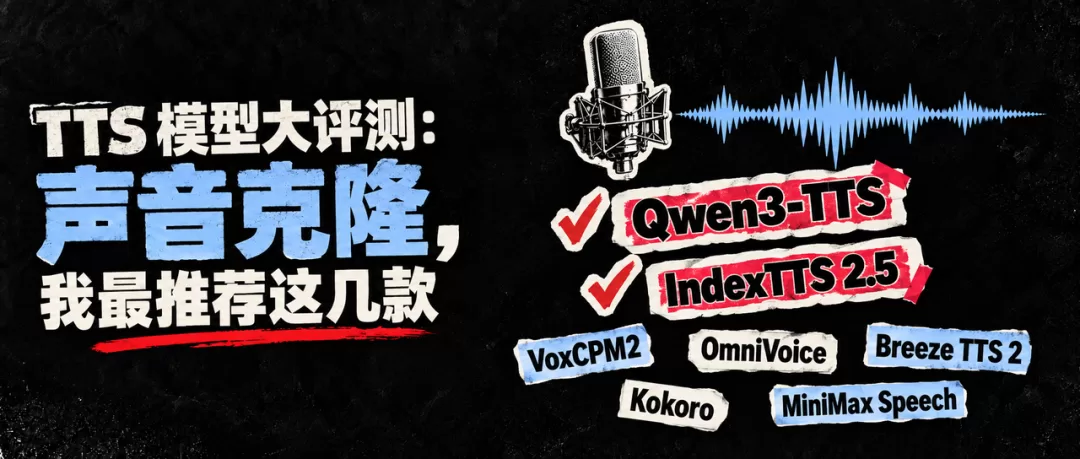
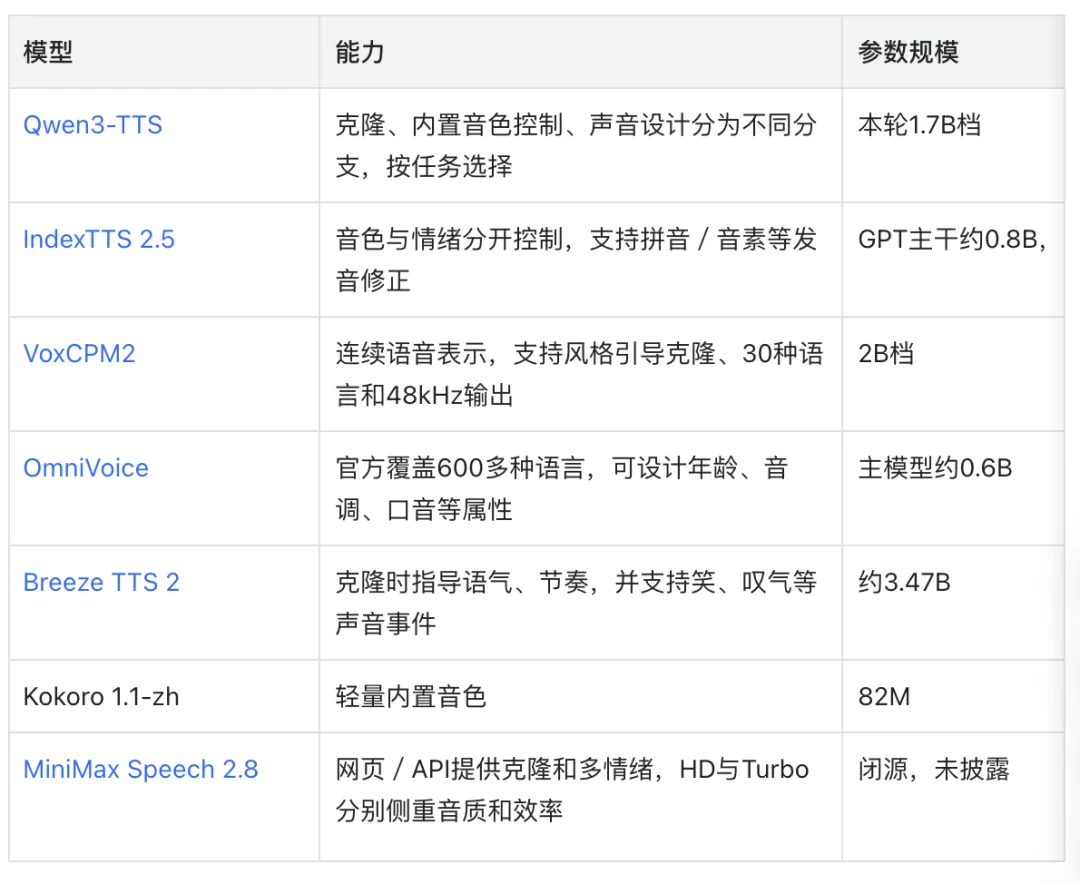
目前主流的 TTS 模型有:Qwen3-TTS、IndexTTS 2.5、VoxCPM2、OmniVoice、Breeze TTS 2、Kokoro 1.1-zh、MiniMax Speech 2.8。下面是它们各自的介绍和参数规模,B 表示十亿参数,M 表示百万参数。
02 技术原理和成本
TTS 原理和人朗读差不多:模型先读懂文字,搞清楚读音、停顿和语气;要克隆声音的话,再从录音里提取一份"声音指纹",也可以叫声纹。然后逐帧预测声音的音高、强弱,生成一份"语音草稿";最后由"声码器"把草稿还原成我们能听到的声波。
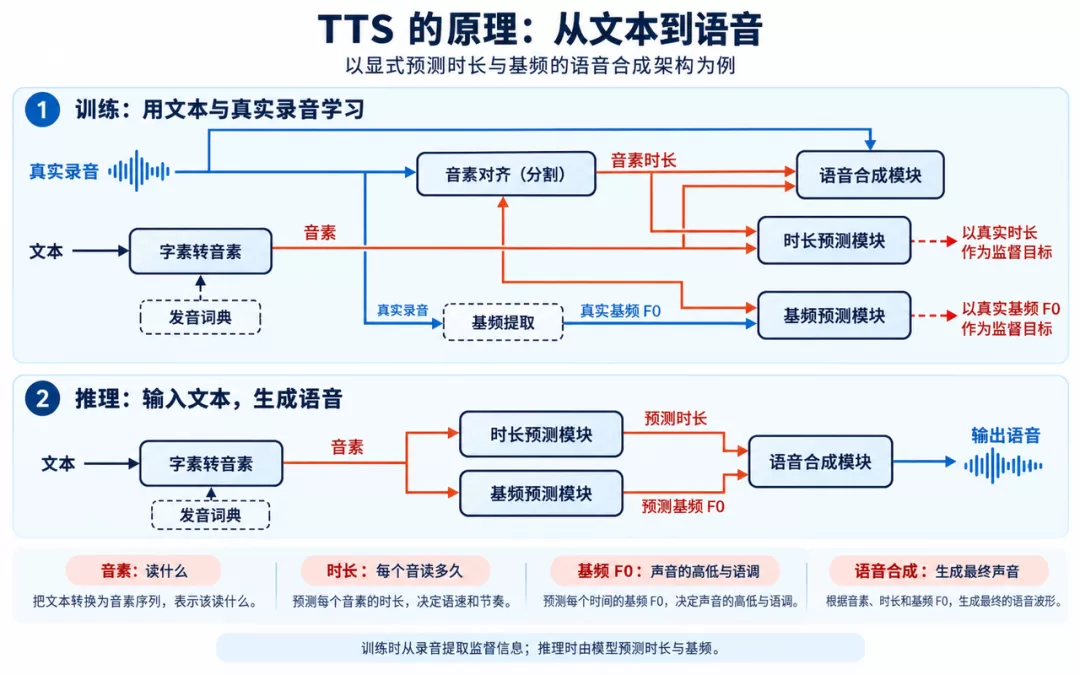
各家的差别主要在"怎么表示声音",也直接影响效果和速度。
Qwen 把声音切成一个个带编号的"声音积木",能直接套用大语言模型来预测,读长文更稳;Vox 用连续数字直接描述声音,像"高清原图",细节更平滑;Omni 则像 AI 画图一样,从噪声里反复"去噪"磨出语音,音质细腻但要算很多遍,所以本地生成最慢。
上述模型的使用:Qwen、Index、Vox、Omni、Breeze、Kokoro 等开源模型基本都能在本地跑,不按字数产生 API 费用,主要成本在设备、GPU 和生成时间上。
本地生成普遍较慢,例如 Index TTS 2.5(哔哩哔哩团队做的模型)在 M4 芯片上跑 2 分钟音频约需 1 小时,Omni 约 59 秒旁白耗时约 205 秒、Breeze 一份工作耗时约 239 秒;Kokoro 文件小、设备负担低,但用不了克隆音色。
云端方面,免费的可以在 HuggingFace、魔搭平台试用,API 也能申请,但是会有速度和额度限制。
MiniMax 的 Speech 3.8 是普遍反馈较好的 TTS 模型,个人套餐约 36 元/月(API 另有计费规则),愿意花钱省配置可以直接选它。
这次我在本地跑了 6 款 TTS、共 25 条音频,完成了 94 项评分。我主要看四件事:像不像本人、说话自然不自然、情绪是否到位、音色是否稳定。检查有没有漏读、重复或读错内容。
03 评测结果
普通克隆使用相同的 20 秒参考录音和同一段新文案。下面每项满分 5 分:
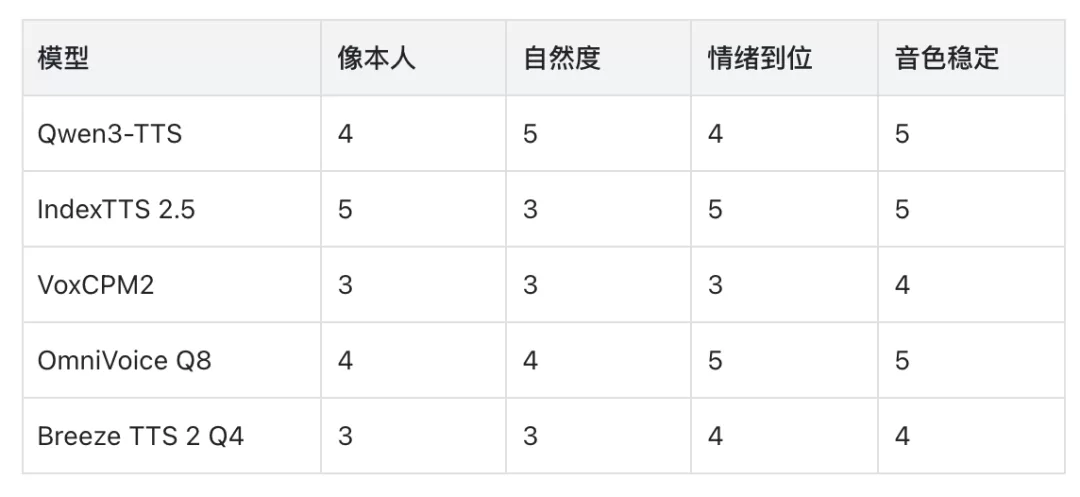
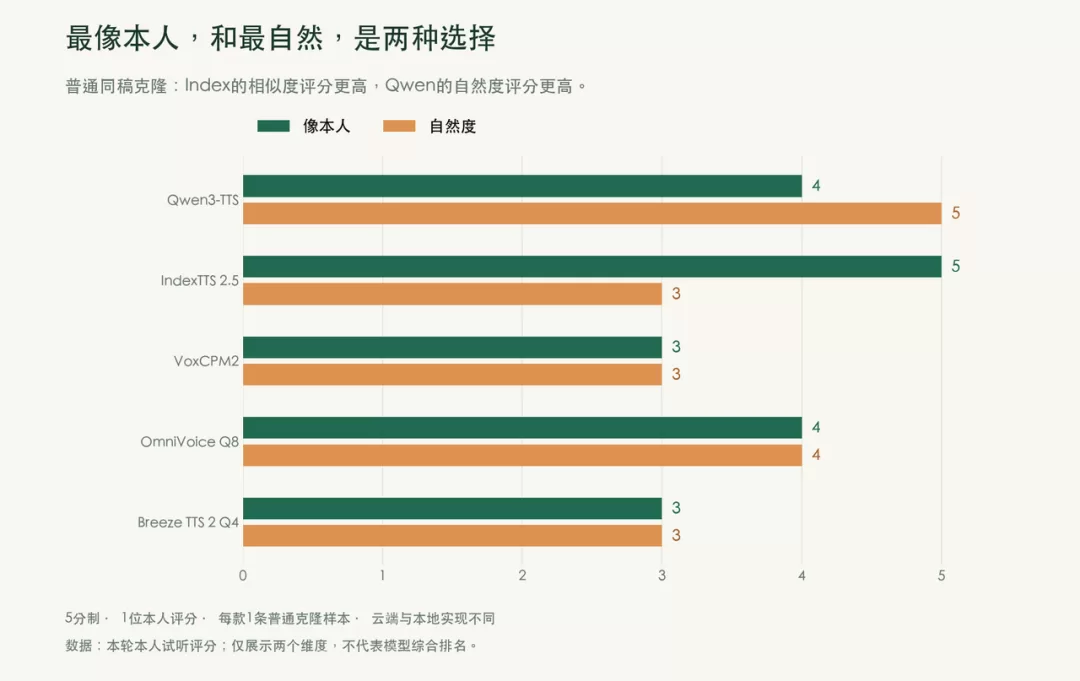
以上评分仅供参考,按综合表现和日常实用,可以照这个顺序选:
- Qwen3-TTS:四项最均衡,自然度满分,日常配音首选。
- IndexTTS 2.5:最像本人,情绪和稳定性都满分,只是自然度稍弱。
- OmniVoice Q8:长文表现好,但要分段生成,否则容易和原稿不一致。
- Breeze TTS 2:情绪场景最出彩。
- VoxCPM2:克制愤怒的场景更适合它。
- Kokoro:效果不好,不推荐使用。
04 使用方法
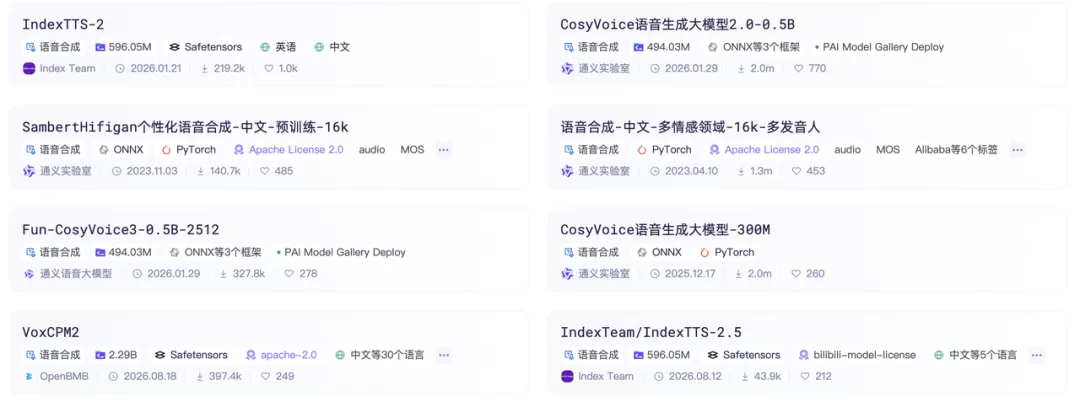
这些 TTS 模型基本都能免费试用,在 HuggingFace 或魔搭(ModelScope)上找到对应模型,就能在线体验、测试效果。
如果想长期、稳定地使用,推荐以下三种方式:
1. 本地安装开源模型。直接让你的 AI Agent 帮你装,比如对它说"帮我搜索并安装 Index 最新的 TTS 模型";装好之后,每次用都让 Agent 操作本地模型,直接说"帮我克隆这个声音,发送 mp4 文件或音频文件都可以",它就会自动完成生成。
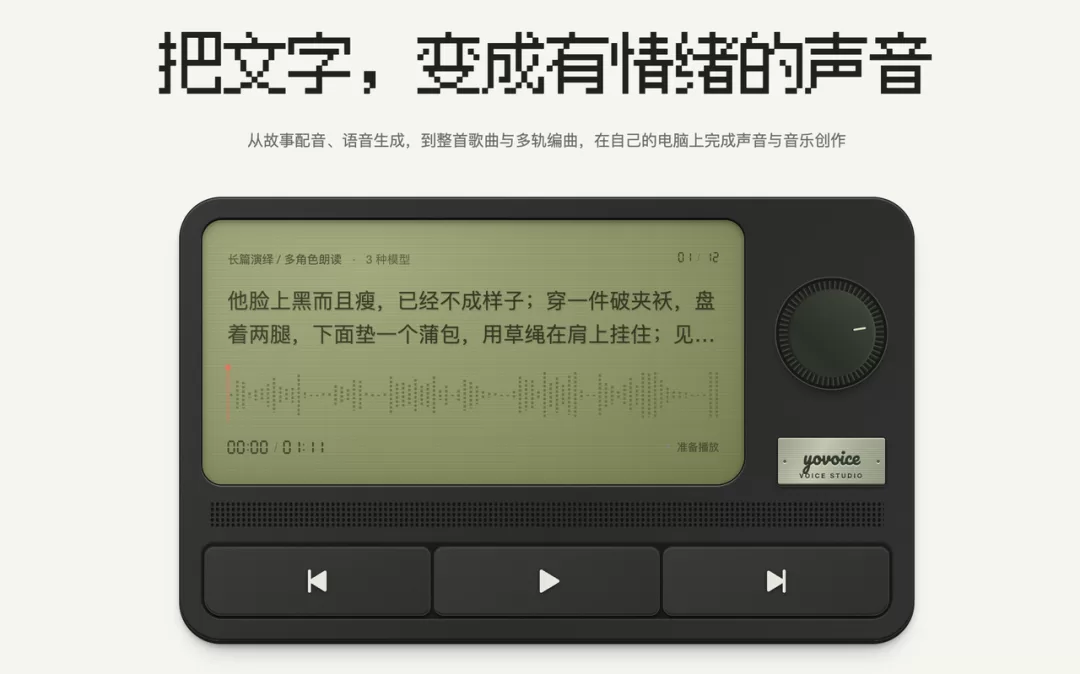
2. 使用开源的 TTS 软件。推荐 Yovoice,它提供图形界面和命令行,能一键下载、管理和调用本地模型,支持声音克隆、情绪控制,内置了本轮评测的 IndexTTS、VoxCPM2、OmniVoice、Qwen3-TTS、Breeze、Kokoro 等模型,省去自己配环境的麻烦。想要更多选择,也可以去 GitHub 搜索其他开源 TTS 项目。
3. 调用 API。在阿里云、腾讯云、MiniMax 等模型广场就能搜到开源模型,充值后拿到 API Key,再让自己的 Agent 调用,不用本地部署和等待,适合不想折腾设备、愿意按用量付费的人。
TTS 模型的更新速度还是蛮快的,基本上一个季度就换一轮。但现在的模型用在克隆声音,完全够用了。大家也可以尝试在本地下载上述模型,让 Agent 克隆你的声音试一试。
模型只是工具,但在使用工具这个过程中,也许你会有灵感,用声音创作艺术作品。