今天看到一个让我挺激动的事情——我常用的 WorkBuddy 和 LibTV 竟然官宣打通了!现在在 WorkBuddy 里连接 LibTV,就能直接调用 LibTV 的视频创作能力。
我看到这个消息后,赶紧去实测了一下。我拿一张酒红手提包的产品图试了试,连续做了三条视频。老规矩,来,先看成品吧。
第一条,开箱视频
第二条,穿搭分享视频
第三条,通勤生活 Vlog 视频
怎么样?同一只包,开箱、穿搭、通勤,拍出来的感觉还挺不一样。WorkBuddy 和 LibTV 这两个 AI 产品强强联合之后,不管是做品牌视频、UGC 素材,还是做短剧,都非常方便。下面把我实测的过程讲给你看,提示词我也会放出来,你可以直接复制去实操。
一、先把 LibTV 接进 WorkBuddy
1. 具体怎么连接?
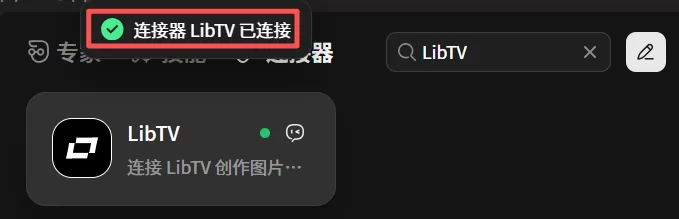
打开 WorkBuddy,点击左上侧的"专家·技能·连接器",然后右上角的搜索框里输入「LibTV」,点击 + 号连接。
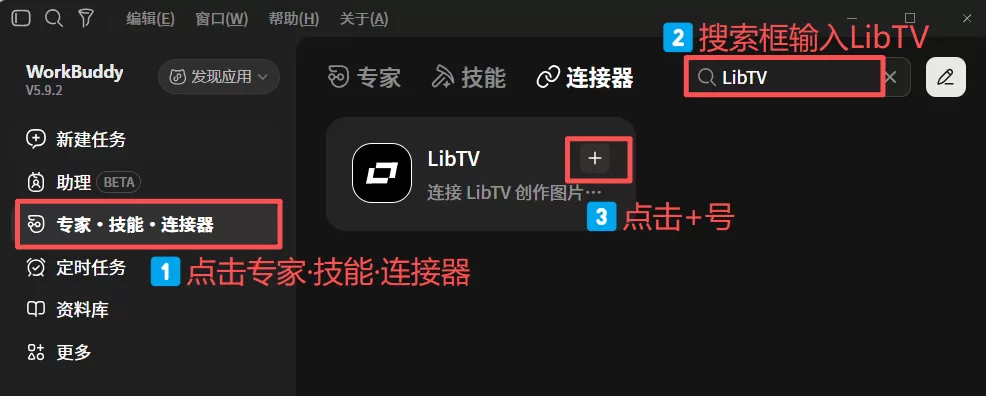
点完 + 号后,会自动跳转到浏览器,再按页面提示完成账号授权。
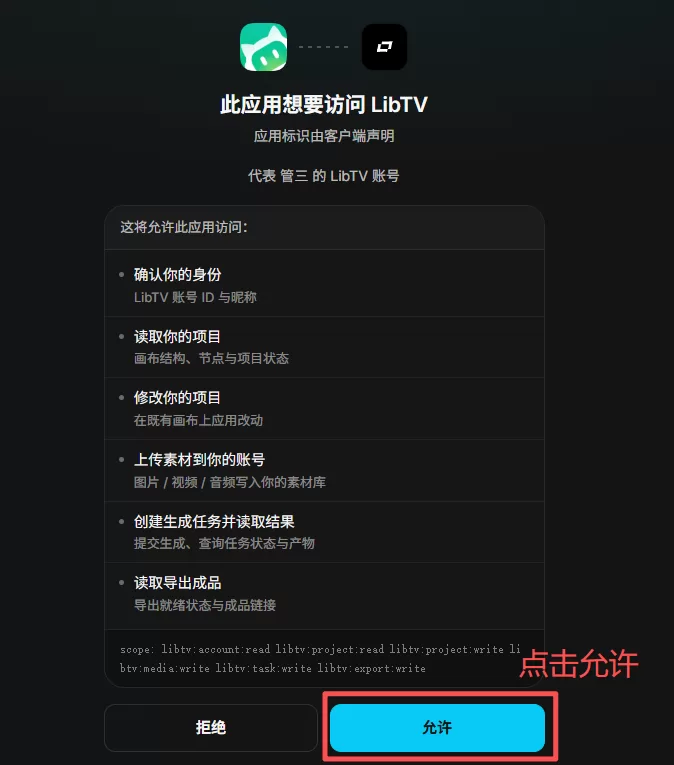
返回 WorkBuddy,看到 LibTV 显示"已连接",就可以开始用了。
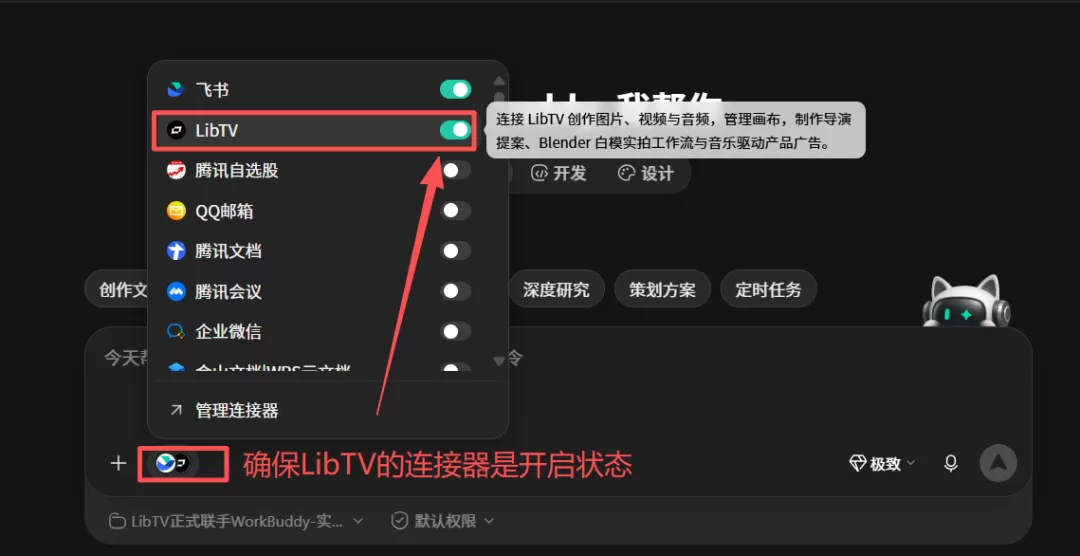
用的时候,要确保 WorkBuddy 对话框左下角的 LibTV 连接器是开启的状态。
2. 给 WorkBuddy 一张商品图,先让它出方案
做视频其实就是做一个项目,所以要先建一个项目文件夹。我在电脑里建了一个文件夹,把酒红手提包的产品图放进去。
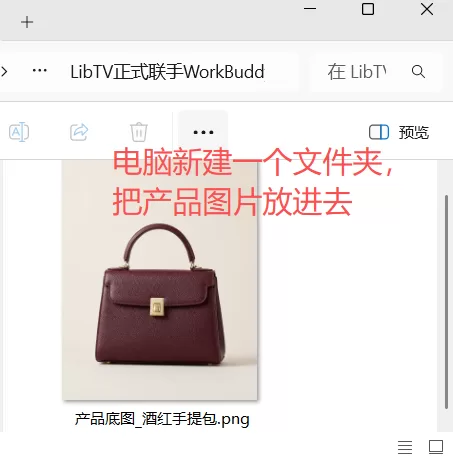
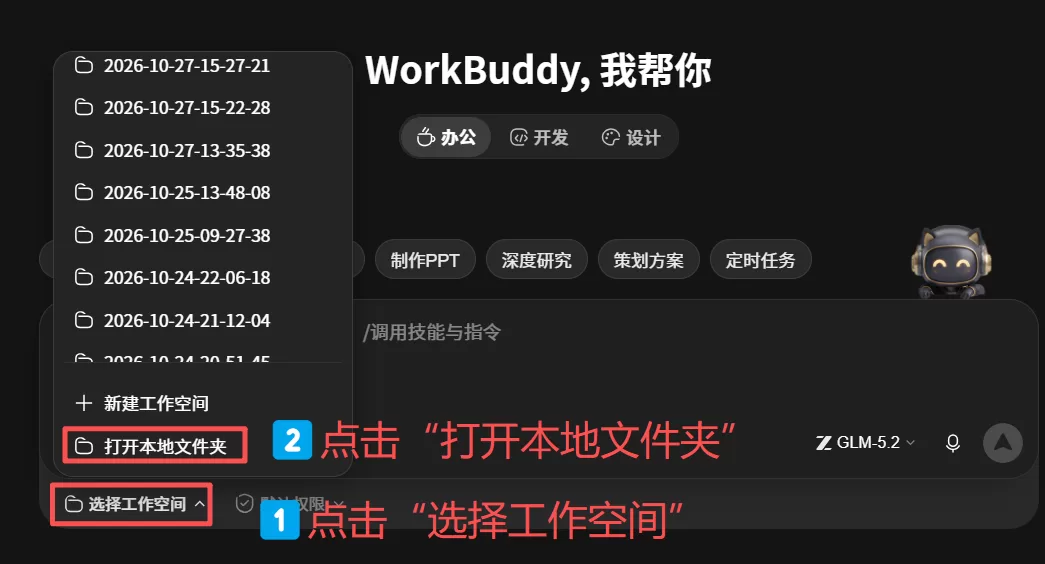
接着在 WorkBuddy 里新建一个任务,点击底部的"选择工作空间",点击"打开本地文件夹"。然后选中前面创建好的文件夹,这样 WorkBuddy 就能够读取我们的酒红色包包产品图了。
然后,我发了第一段提示词:
我想用项目文件夹里的这款酒红包包,做 3 种不同场景的短视频广告,包括:开箱、穿搭分享、通勤 Vlog,每条目标 20~30 秒。
你担任创意总监,先帮我分析这款包包的特点、核心卖点、适合的人群,以及不同人群可能会被什么内容打动。
然后基于这些分析,帮我策划这 3 条视频的创意方案,后面再由你负责拆解任务,并调用 LibTV 里合适的专业能力、Skill 或视频模型完成制作,尽量保持包包外观一致。
先不要生成视频,先把产品分析和 3 条创意方案给我确认一下。
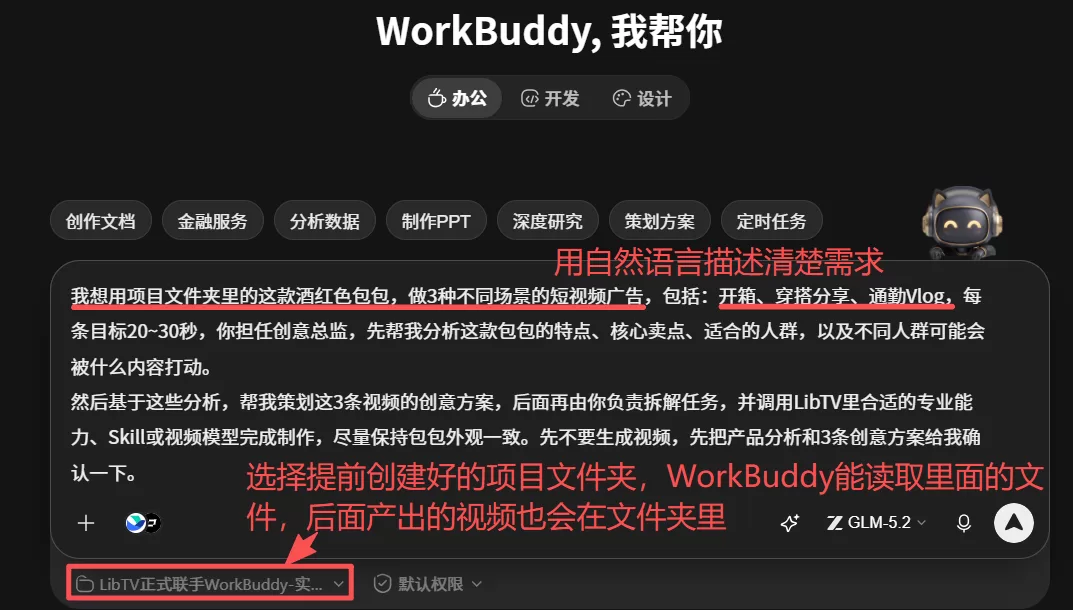
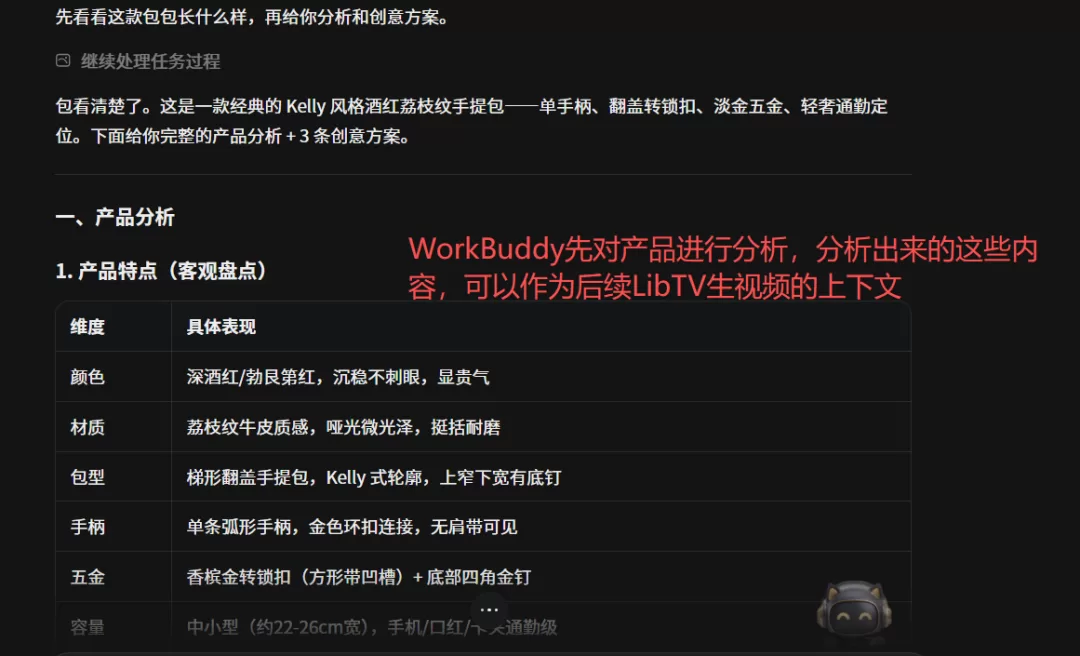
我特意让它先不要生成视频,因为我自己做内容也是这样,方向没想清楚就开工,片子做完才发现不对,返工更麻烦。WorkBuddy 收到指令后,针对我的商品做了细致分析。
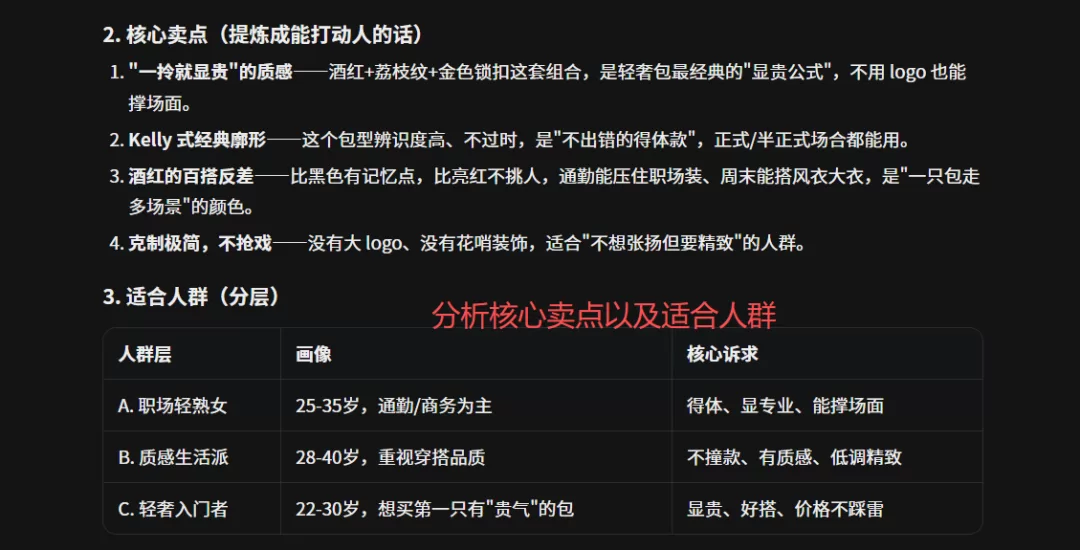
还梳理了核心卖点以及适合人群。
包括三条视频的创意方案也帮我想好了。
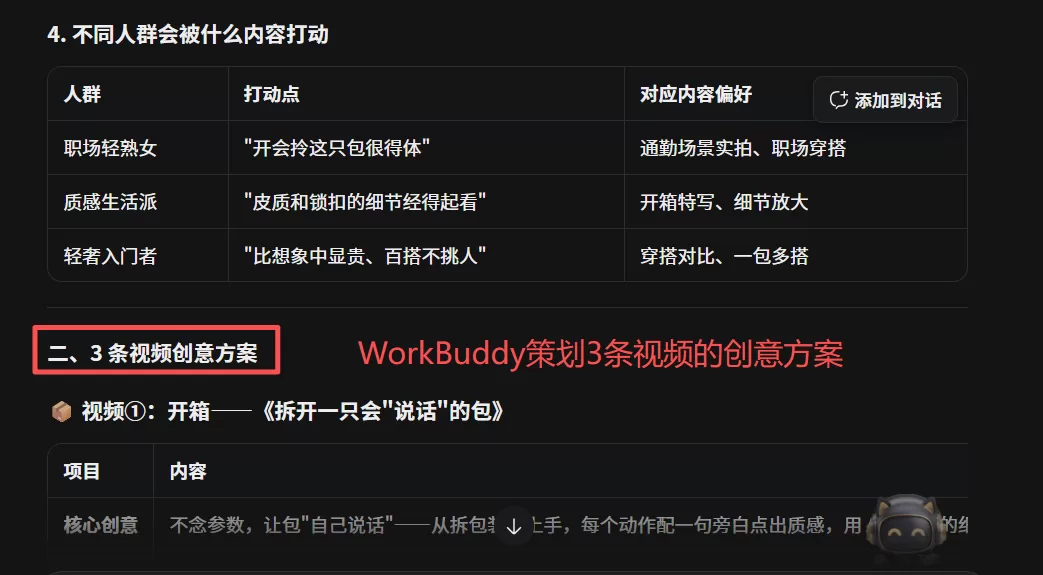
我看完,觉得方向可以,然后就可以让它调用 LibTV 开始做视频了。
二、同一张图连做三条视频,最后一条让它定时交片
第一条:先做开箱视频
确认方案后,我给 WorkBuddy 发了第二段指令:
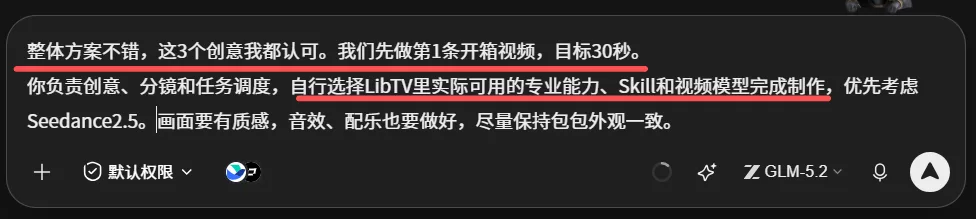
整体方案不错,这 3 个创意我都认可。我们先做第 1 条开箱视频,目标 30 秒。
你负责创意、分镜和任务调度,自行选择 LibTV 里实际可用的专业能力、Skill 和视频模型完成制作,优先考虑 Seedance2.5。
画面要有质感,音效、配乐也要做好,尽量保持包包外观一致。
收到指令后,WorkBuddy 就会沿用前面的创意方案,调用 LibTV 去做视频,做好的视频会直接推送到聊天的界面。而且右侧可以展开面板,在面板上可以用浏览器进入 LibTV 官网,能实时看到制作的视频节点以及进度。
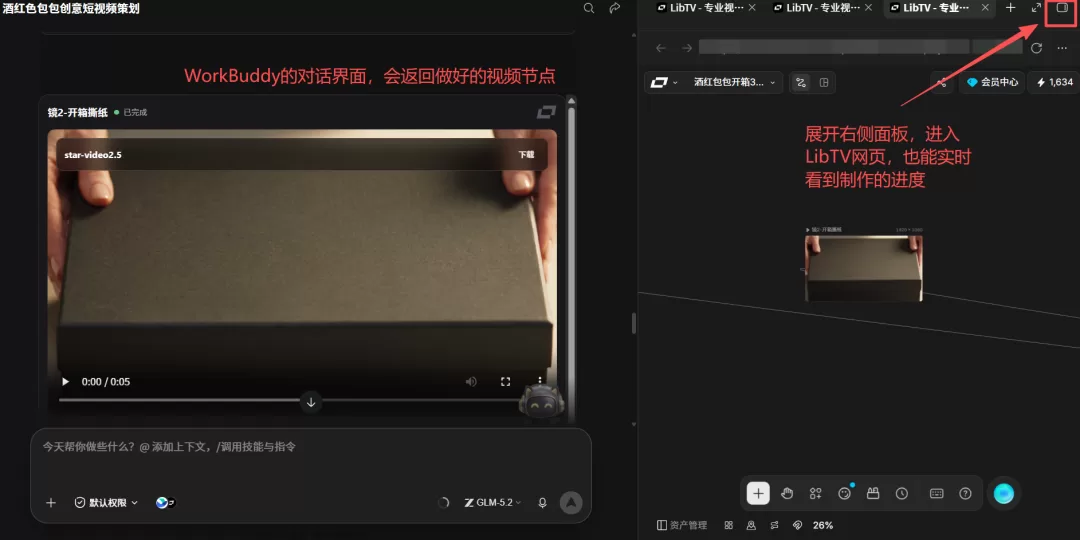
最后拿到的是一条约 30 秒的成片。画面里有拆包装、包身纹理和金色锁扣的特写,最后再回到产品展示。
第二条:穿搭分享视频
这一条,是我最想测的地方。因为 WorkBuddy 是有前面聊过的所有上下文的,我就想试试换个类型的片子,直接在原来的对话框里提新的需求:
继续按照之前的方案,帮我制作「一包三搭」穿搭分享视频,目标 30 秒,用 Seedance2.5,直接生成 30 秒的视频。
调用 LibTV 合适的能力完成制作。要有网感,音乐和画面节奏要协调,保持包包外观一致。
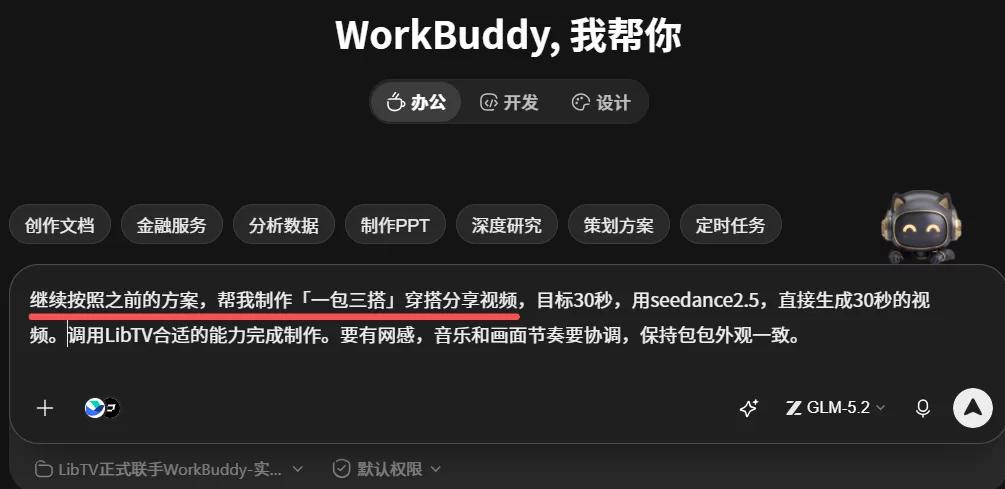
WorkBuddy 的回复确实接上了前面做过的项目和商品图,然后继续调用 LibTV。
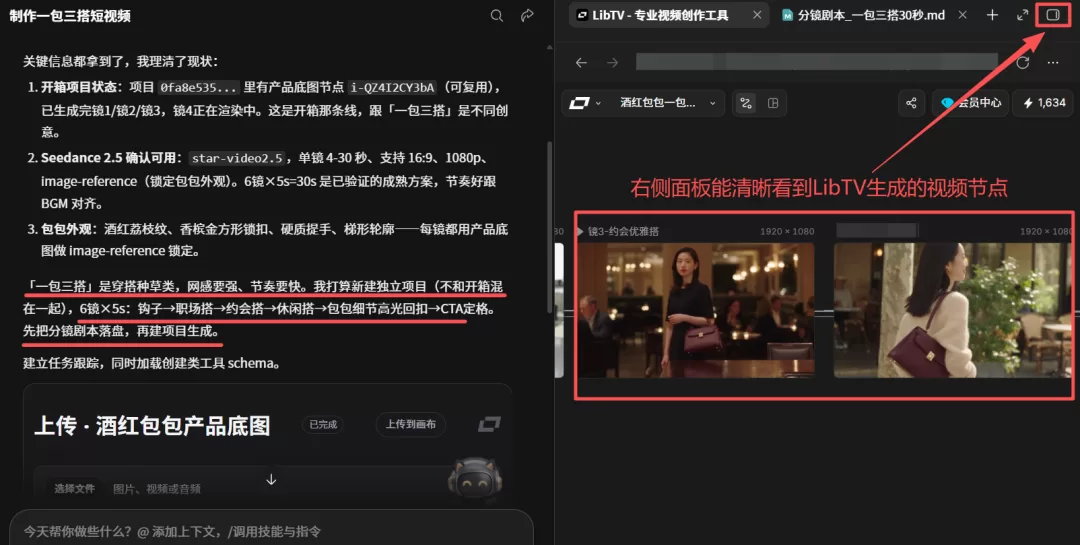
最终我拿到一条 30 秒的片子,包包分别出现在办公、晚间和休闲场景里。这比单独做一条视频更让我有感觉,因为第二次做的时候,我不用再从头解释商品信息以及之前做过的片子风格。
第三条:安排定时任务做通勤 Vlog
做了 2 条后,我又想再换个风格,打算做个 Vlog 类型的氛围短片。所以接着做第三条,而且我还上了个难度,搞了个定时任务。我给 WorkBuddy 发送了下面这个需求:
请帮我安排一个定时任务,1 小时后自动调用 LibTV,用项目文件夹里的酒红色包包图,再制作一条 20 秒的女生通勤生活 Vlog。
从早上出门、通勤、上班到下班,让包包自然融入生活场景。
视频要有真实的手机 Vlog 感觉,画面自然、有生活气息,配上合适的音乐,广告创意由你自己策划。
到了指定时间后自动执行,直接调用 LibTV 的 Seedance2.5,视频时长直接设置 20 秒,直接单次生成完整 20 秒的有声视频。
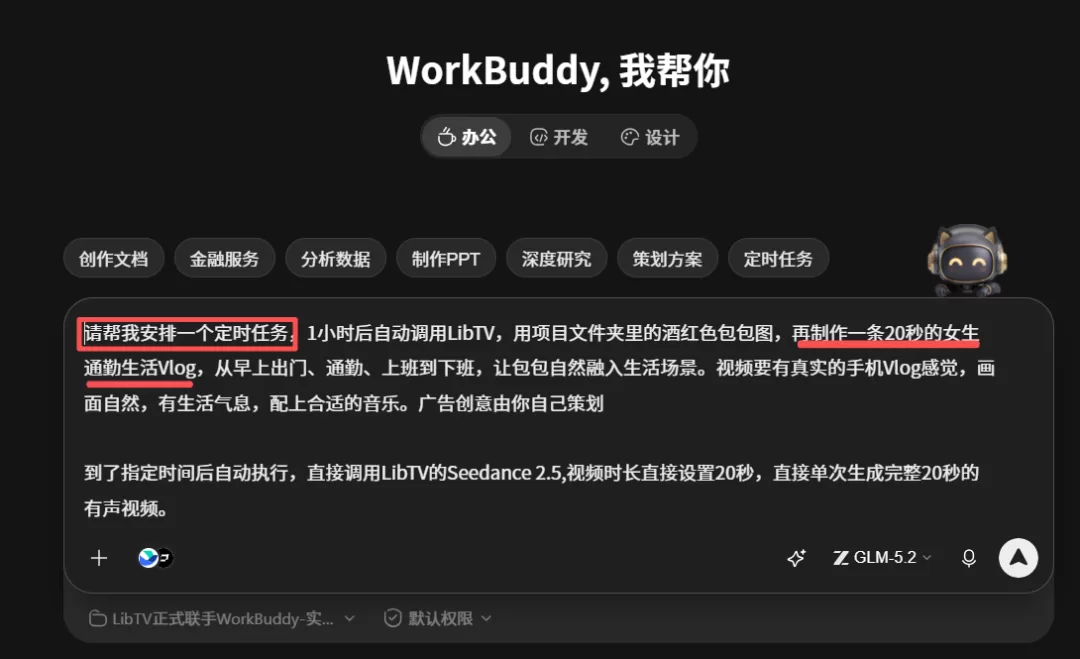
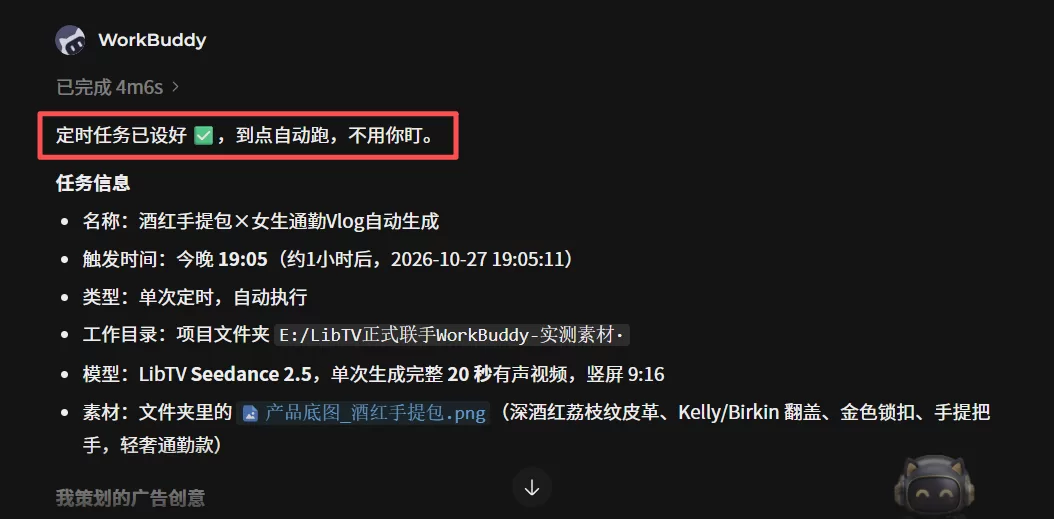
收到指令后,它就设置好了一个定时任务,说不需要我盯着,到点会自动跑。
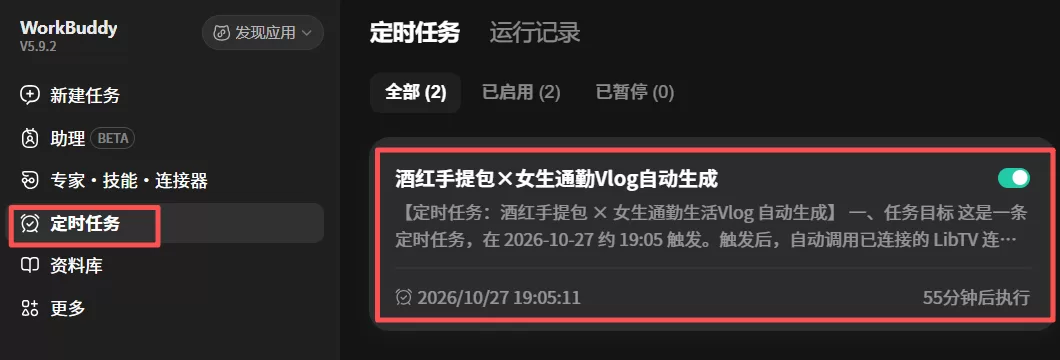
在左侧的定时任务列表里,也能看到这个定时任务。
设置好之后,我就去楼下吃了个面,回来后就发现它自动在执行任务,把片子做好了。
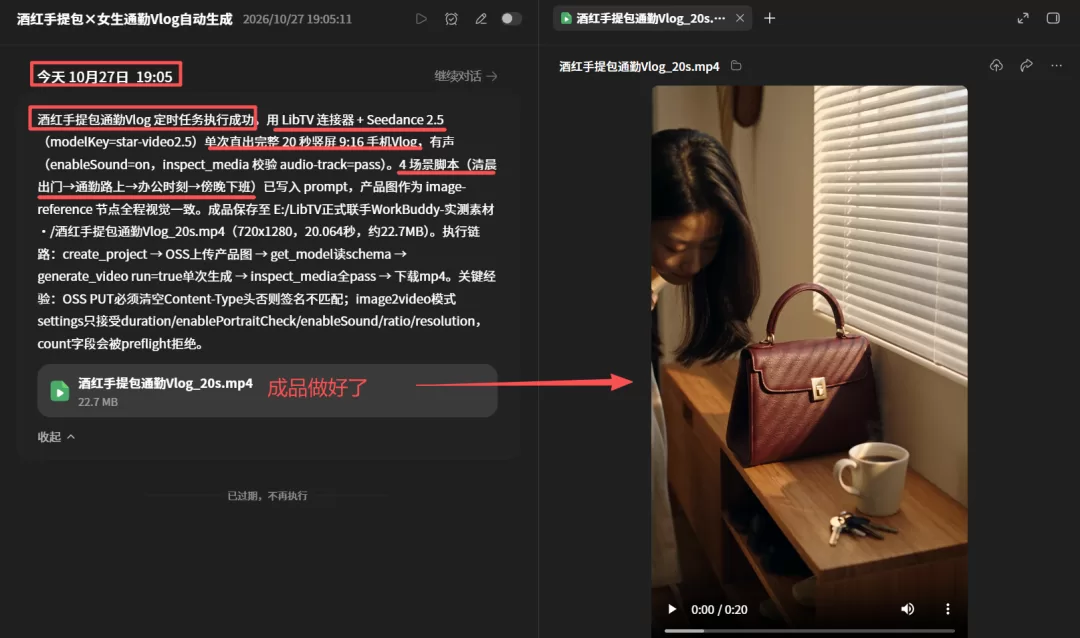
这次我设置的是一次性定时任务。当然,每个人的需求不一样,如果你要每天自动做、长期批量做,可以试试设置每天定点自动做,那就相当于能搭一座 7×24 小时运转的视频工厂了。
LibTV 还有 Wan3、Seedance2.0 Fast 等模型可以选择,这些模型成本会更低。
怎么换模型呢?很简单,只需要在给 WorkBuddy 发送需求的时候,说清楚用哪个模型就行。
三、WorkBuddy 调用 LibTV,到底有什么特殊优势?
第一,在"工作上下文"里做视频更方便了。我相信现在很多人都习惯在 WorkBuddy 里面梳理想法,产出各种方案和素材。那这些想法、方案出来后,如果想基于它们做出专业的视频,以前得打开另外一个 AI 视频工具,沟通成本太高了。但现在可以在 WorkBuddy 的同一个任务里把方向说清楚,然后直接调用 LibTV 去做视频。WorkBuddy 负责动脑和指挥,LibTV 负责动镜头和交片子。
第二,同一窗口里,视频可以连续迭代。我前面做了包包的开箱视频、穿搭视频,以及 Vlog 视频。但在实际的短视频营销种草环节,对素材的多样性要求很高。同一款包包商品,你还可以做真人口播短视频、送礼场景短片、TVC 短片、皮克斯短片等。你可以继续在这个任务里提需求,不用重新整理一遍,直接口喷需求就好。
第三,可以产生更多无限的玩法,把视频生产接到后续流程里。因为 WorkBuddy 有强大的连接器生态,调用 LibTV 把视频做好之后,可以直接让 WorkBuddy 自动分类并推送到飞书多维表格,做成素材库、接到日常运营流程里。对我们这种经常做内容的自媒体人,或者对于要做 AI 视频、AI 短剧的团队来说,还挺爽。
如果你也想试,可以按照这篇文章操作一下,甚至可以直接复制文章里的提示词去玩。