今天跟大家一起看一下 GPT-6 Sol 的情况。GPT-6 Sol 跟 Claude Opus 5.5 基本上是同一天发布的,但口碑已经呈现出了非常明显的两极分化。
GPT-6 Sol 的价格要比 5.6 Sol 更便宜 10 美元/Million 的输出,大约是 5.6 Sol 促销价的一半左右。
OpenAI 方面表示,这个模型采用了类似 Astra 的方法,能够完成很多专业工作、写代码以及操作电脑等任务,而且整个输出更短、废话更少。但从实际使用的体感来看,整个模型的质量其实是大幅下降的,现在唯一能够夸的,就是更加耐用了。
我相信大家也发现了,这一次 OpenAI 整个宣传的核心点,就是反复强调这个模型更便宜。这跟以前新模型发布的宣传套路完全不一样——以前都是告诉你:更聪明、更强、更快;这一次上来先告诉你:兄弟,我便宜啊,香不香。
这种变化肯定是有内在原因的。目前总结下来,最主要的原因就是,这个模型整体智能水平确实不够。也许它在一些非编码任务上表现还不错,但是在编码任务上,肯定是明显倒退的。
编码能力实测
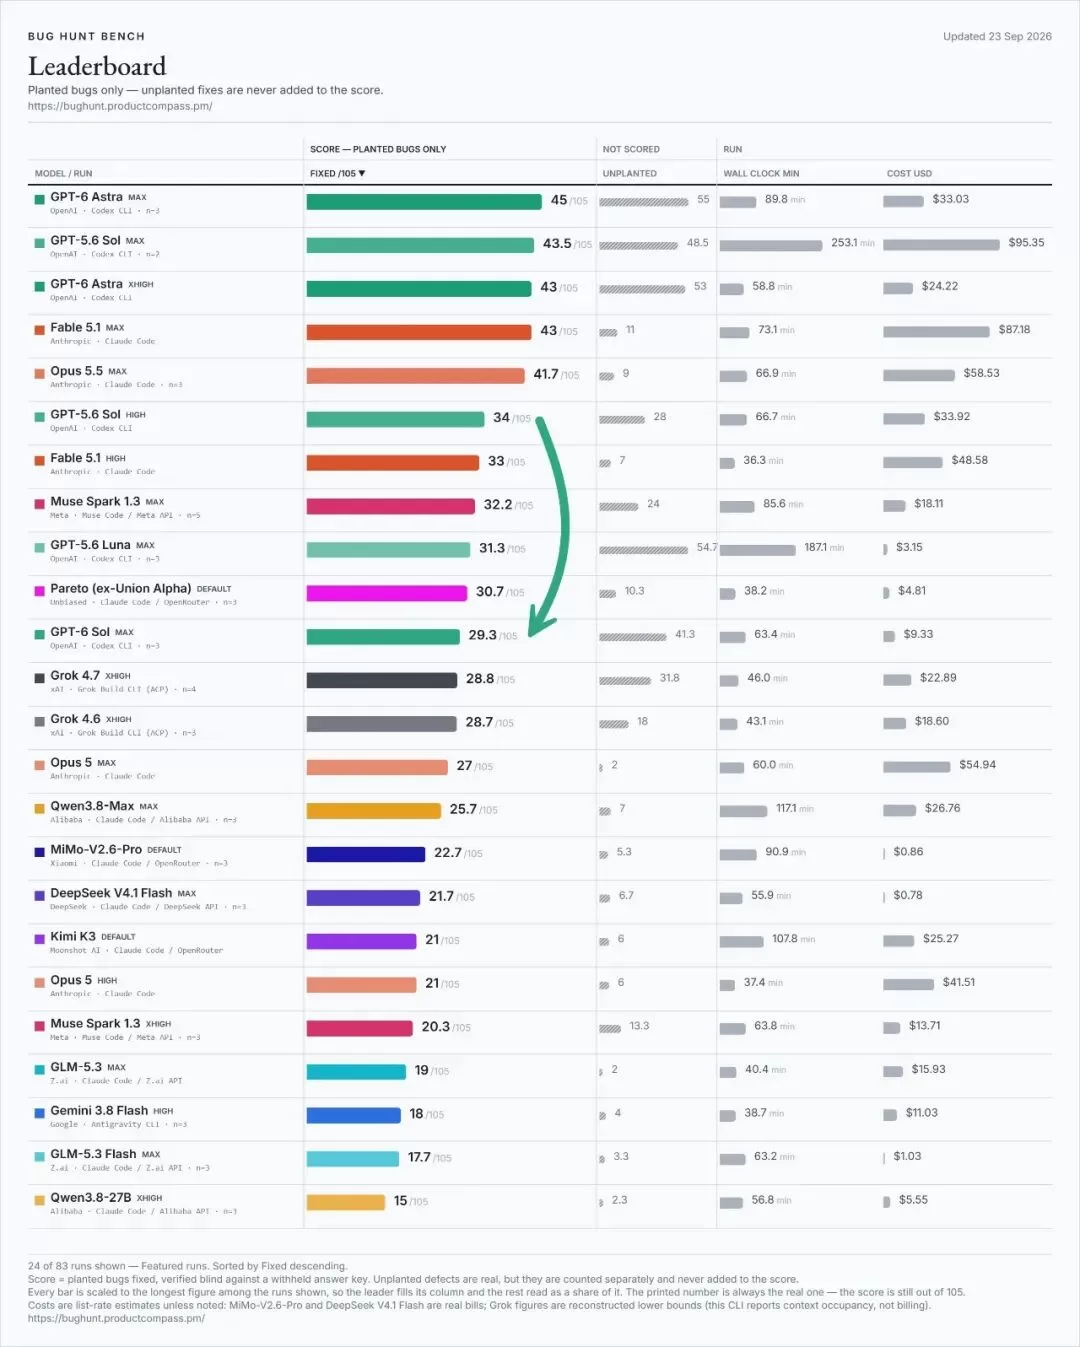
最近有很多朋友都在测试新模型的表现,CodeReader(http://codexradar.com/)也在做更多测试。Twitter 网友 Pawel Huryn 通过"找 Bug"的方式来测试整个模型的编码能力。
这个测试一共准备了 150 个模型比较容易漏掉的 Bug,全部来自两个真实的生产级项目:
- GrokBuild:基于 VS Code 和 Cursor 做的扩展,约 2.8 万行 TypeScript 代码,准备了 45 个 Bug。
- AI 课程系统:约 6 万行代码,前端使用 Vite、React 和 TypeScript,准备了 60 多个 Bug。
测试结果:
| 模型档位 | 修好 | 花费 |
|---|---|---|
| GPT-6 Astra(max,3次平均) | 45 | ## 美元 |
| GPT-5.6 Sol(max,2次平均) | 43.5 | ## 美元 |
| Opus 5.5(max,3次平均) | 41.7 | ## 美元 |
| GPT-5.6 Terra(max,1次) | 32 | ## 美元 |
| GPT-6 Sol(max,3次平均) | 29.3 | 9.3 美元 |
| GPT-6 Sol(xhigh,1次) | 25 | 7.7 美元 |
| GPT-6 Sol(high,1次) | 20 | 4.2 美元 |
| GPT-6 Luna(max,2次平均) | 19 | 0.51 美元 |
GPT-6 Astra 下面,表现最好的是 5.6 Sol,然后是 Opus 5.5,再往下是 5.6 Terra,最后才是 GPT-6 Sol。
性价比确实很高,符合便宜输出又短的特点!价格甚至只有上一代高档模型的 10% 左右,但是它整个"智商"的下降实在太严重了。至少从这组真实项目测试来看,编码能力的差距非常明显。
更深入的测试
再往细了看,GPT-6 Sol 在修复率上不仅比前代低,而且在某些复杂场景下表现更差。
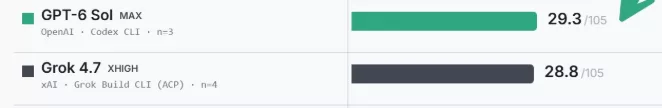
这意味着如果我们真的把这个模型拿到生产环境里去用,虽然模型本身便宜了,但是最后你可能会发现,你得浪费大量时间去纠正它犯下来的错误。模型费用省下来了,人的时间又赔进去了。
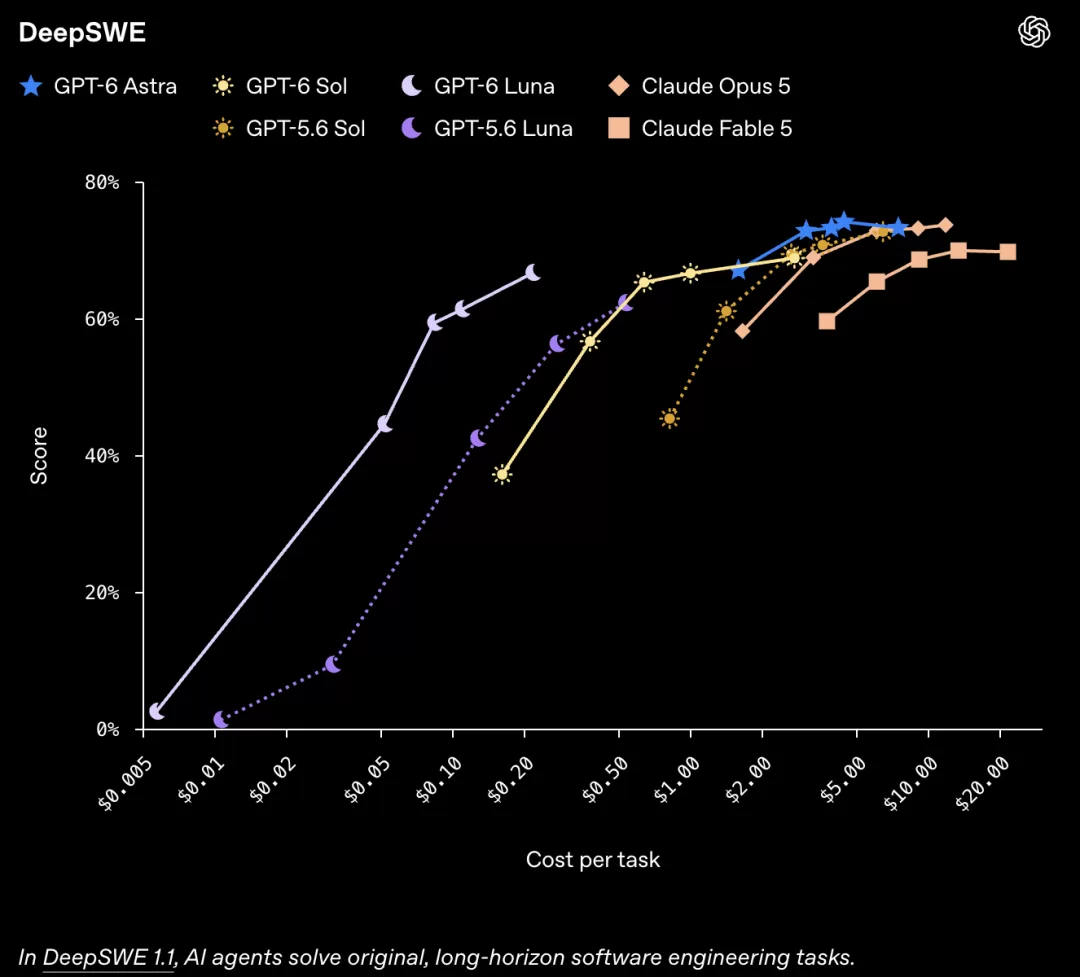
所以到最后,我们又只能夸它一句:便宜。
"哇,GPT-6 Sol 好省啊,跑了半个小时才掉 1%。"但是然后呢?
其实对新一代 GPT-6 Sol 的要求真的一点都不高。只希望它能够达到上一代 5.6 Sol 的水平,然后速度再快一点,便宜点就已经完全满足了。
包括 Computer Use,本来还挺期待 Luna 能有一个比较好的表现。但是如果 GPT-6 这一代的中低档模型整体都是现在这种水平,那 Luna 基本上也没有太大的测试必要了。
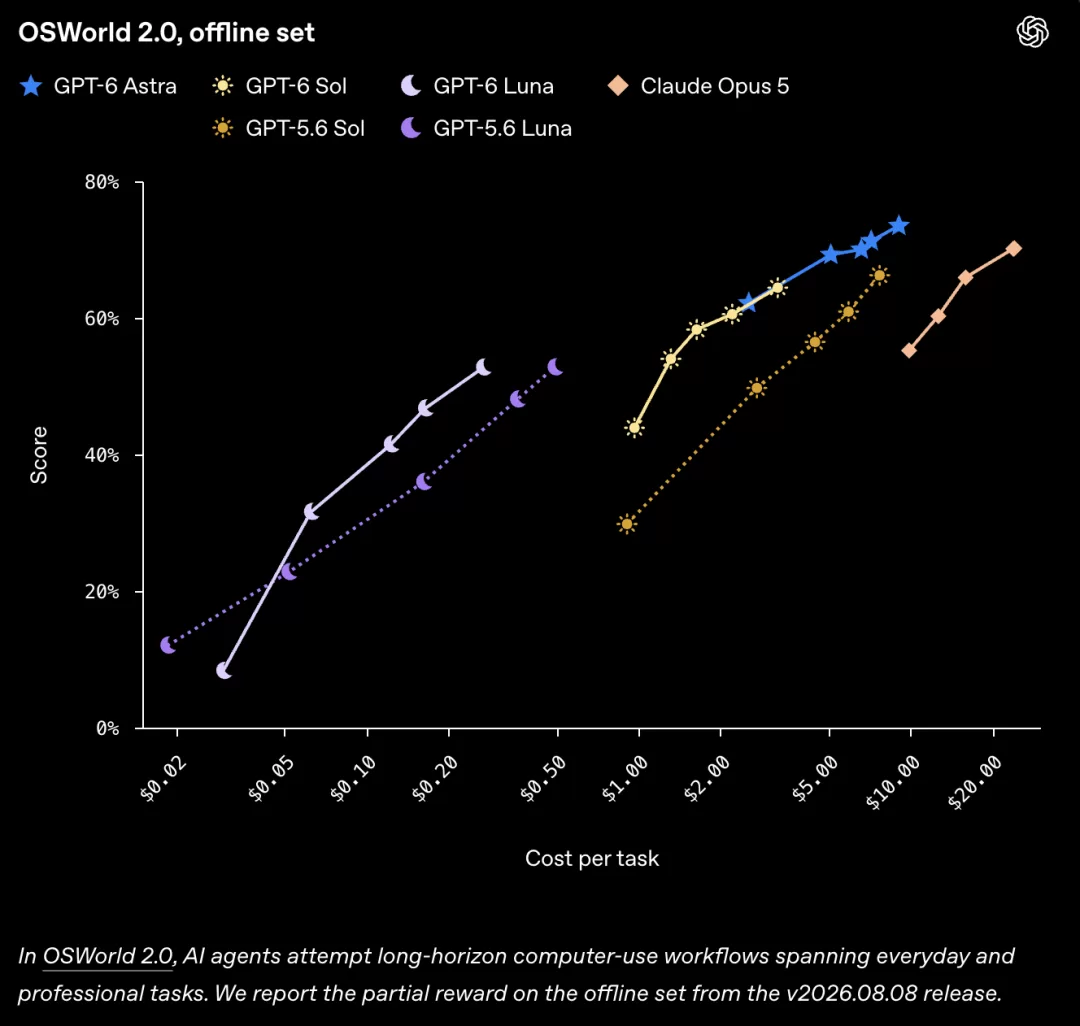
所以现在的问题就变得特别尴尬:Astra 太贵了,一个 X20 可能用个一两天就没了;Sol 确实便宜,但是智商又跟不上。如果你真的在意效果、在意生产力,那反而不如直接用 Astra,这才是版本的真正答案。
尽管官方现在已经把 Astra 的额度砍到了大概 1200 美金,而 5.6 Sol 加起来可能还有 2500 美金左右的额度,但是我们实际使用之后也会发现,5.6 Sol 真正消耗起来其实一点都不算省。
这一代的 Astra,其实就是上一代真正的更便宜的"Sol",但是 OpenAI 不会让你真正赚到便宜,token 输出少了,那就提价(当然可能算力真的更多吧);而这一代的 Sol,"地球"罢了。