2026年9月22日,Anthropic把新一代旗舰模型放到了一个更现实的位置:不是只在榜单上更强,而是试图让它在长任务里更便宜、更快、更容易持续运行。
如果你用过编码 Agent,就知道"模型价格下降"常常不是账单立刻腰斩。真正昂贵的部分,可能是几万轮上下文反复回传、工具调用产生的长输出,以及模型为了完成一个任务不断重试。Claude Opus 5.5 的特别之处,正是它同时改了价格表、缓存价格和默认推理策略。
官方给出的核心说法是:Opus 5.5 在多数工作上达到 Claude Fable 5.1 级别,典型工作负载运行成本比 Opus 5 低 40%,输出速度提升超过 30%。但"40% 更便宜"不是所有调用都自动获得的折扣,它取决于你的上下文是否可复用、模型是否少吐 token,以及你是否接受新的默认 effort。
先把两个"降价"数字分开
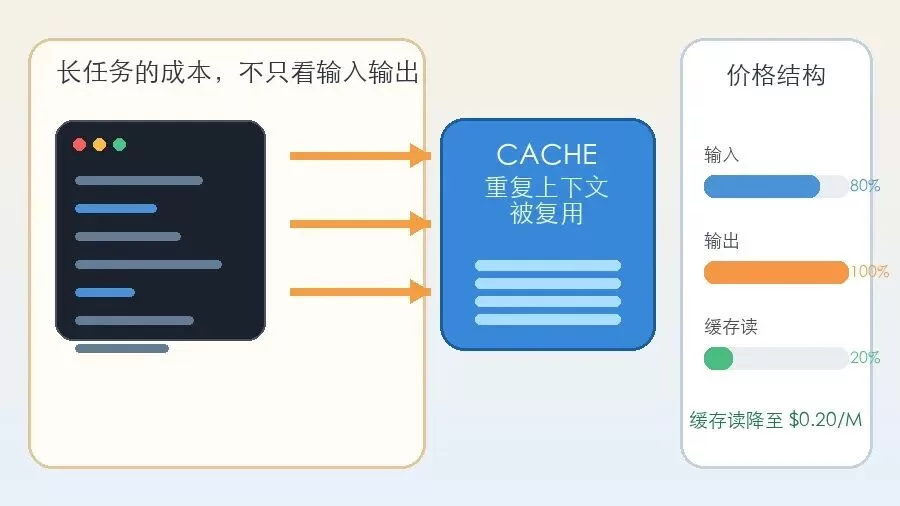
价格表层面:输入/输出从 $5/$25 降到 $4/$20,降幅是 20%。缓存读取则从 Opus 5 的 $0.50/M 降到 $0.20/M,降幅 60%。如果你的调用是短提示、低复用,主要感受到的是 20%。
任务层面:Anthropic 声称典型工作负载低 40%。这是基于自己的任务分布和默认设置计算出的综合结果,不等于每个用户的 API 账单都会减少 40%。长上下文、编码 Agent、重复工具结果越多,缓存读取折扣越有价值。
它真正改变的,是"长任务能不能跑得起"
一个真实的编码任务通常不是"问一次、答一次"。你先让 Agent 读仓库,再让它定位问题、修改代码、运行测试、根据报错继续修复。每一轮都会带上系统提示、工具定义、历史上下文和新产生的结果。若这些内容大量重复,缓存读取就是账单里最值得盯的变量。
因此,Opus 5.5 更像一次面向 Agent 工作流的优化,而不是单纯把旗舰模型打折。Anthropic 还强调它在典型任务中会用更少的 token 完成工作;公开的独立 Java 测试也观察到,新模型输出代码量减少约四分之一、输出 token 减少约 40%,功能通过率与旧模型接近。
能力提升有证据,但不要把榜单当成生产保证
Artificial Analysis 在发布日的独立评测中给 Opus 5.5 的 Intelligence Index 打出 58 分,位列当时榜首;在 Terminal-Bench 4.0 上测得 59.6%,与 GPT-6 Astra 接近。Anthropic 自己的表格则给出更高的 Terminal-Bench 66.4%,并报告 CursorBench 57.8%、GDPval-AA 1846 Elo 等成绩。
这里必须区分证据等级:Artificial Analysis 属于独立评测,Anthropic 表格属于厂商自测;两者的 harness、effort 和安全拦截条件并不完全一致。最稳妥的结论不是"它全面击败所有模型",而是:Opus 5.5 在编码与知识工作上已经进入第一梯队,且把成本效率放到了与能力同等重要的位置。
如果你只是在聊天窗口里偶尔问几个问题,20% 的单价变化未必值得迁移。若你每天让 Agent 持续读代码、改代码、跑测试,或把长文档反复交给模型分析,缓存价格与 token 效率才可能把总成本拉开。
迁移时最容易踩的四个坑
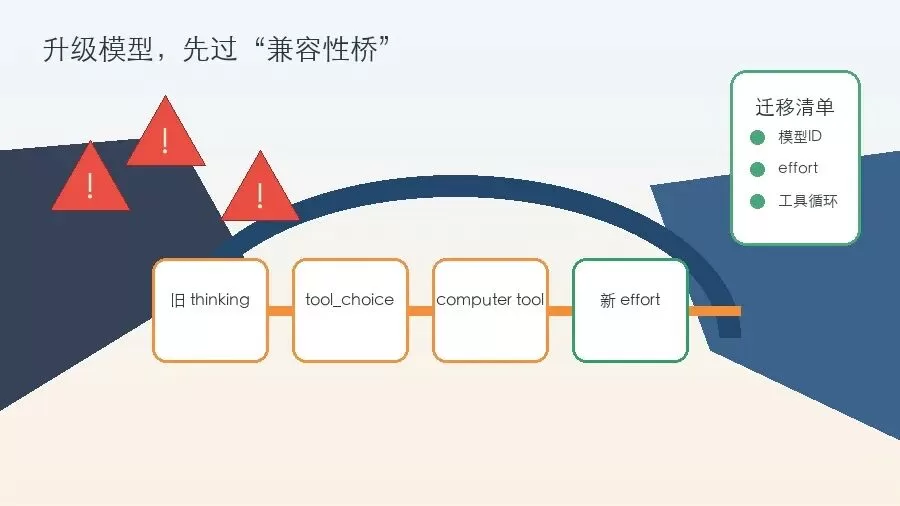
Opus 5.5 不是完全无感替换。Anthropic 的迁移文档明确列出四处变化:
- 第一,thinking 不能再用 disabled 或手动 budget_tokens 关闭,改用 effort 控制;
- 第二,tool_choice 的 any 和 tool 会返回 400,需要改为 auto 配合 strict 工具或结构化输出;
- 第三,thinking block 与模型和会话绑定,修改历史、system prompt 或 tools 可能触发 400;
- 第四,在 Claude API 和 Google Cloud 上,旧的 computer_20251124 工具不再支持,需要迁移到 computer_toolset_20260801。
总结来说,Opus 5.5 的发布不仅是能力升级,更是对 AI 使用成本结构的重新定义。对于重度使用 Agent 的开发者来说,缓存价格的下降和 token 效率的提升可能比单纯的能力提升更有吸引力。