CLM(Contrastive Language Model)是一个用对比学习训练的决策模型。它把状态(state)和动作(action)映射到同一个向量空间,用内积算匹配度。给定当前状态和一组候选动作,CLM 给每个动作打分,选最高分。这听起来简单,但效果不简单。
System One 这个词来自卡尼曼的快慢思考。Agent 领域里,大多数决策依赖 LLM 的逐步推理,慢但可靠。CLM 想模仿的是那种"看一眼就知道该怎么做"的直觉反应,官方直接把它叫做 System One 模型。
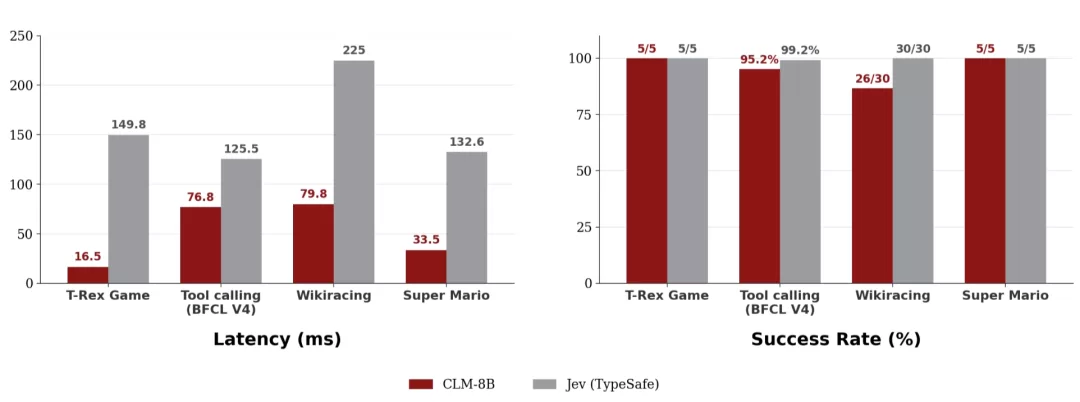
零样本测试覆盖计算机使用、游戏和工具调用。在 T-Rex、BFCL v4、WikiRacing、Super Mario 上,CLM-8B 和 Jev 的表现相当,推理却快得多。候选动作越多,优势越明显。WikiRacing 里动作数量大,CLM-8B 的延迟只有 Jev 的约九分之一。
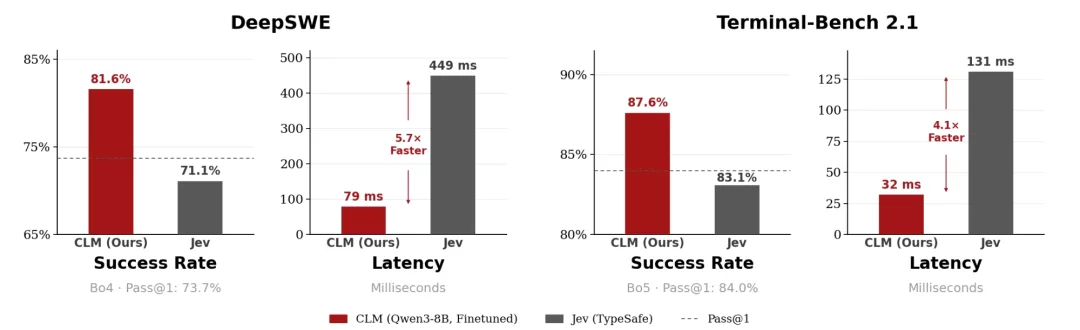
另一个角色是验证器。做法是先采样几个候选答案,然后用 CLM 挑最好的那个。在 38 个 held-out DeepSWE 任务上,轻量微调后的 CLM 达到 81.6%;在 30 个 held-out Terminal-Bench 2.1 任务上达到 87.6%,都刷新了 SOTA。对比之下,Jev 在这类长时任务里连 pass@1 都达不到,当验证器基本失效。CLM 验证时比 Jev 快 4.1-5.7 倍。
核心设计是状态和动作的解耦。两个编码器独立,所以动作 embedding 可以缓存复用。实际场景里状态不断变化,候选动作却常常固定。CLM 在服务端做了一个向量缓存,类似 vLLM 的 KV cache 预留显存。命中后不需要过编码器,直接算点积。实测中,20 个房间反复访问的状态,50 个候选动作下服务端 p50 从 2.0ms 降到 0.7ms。
训练分三个阶段。先拿 6000 万 Nemotron DQA 问答对做预训练,再用 3000 万合成 hard negatives 做中间训练,最后用 100 万 agent 轨迹做后训练。中间训练的价值很明确:如果从一开始就加 hard negatives,top-1 只到 62.4%;先预训练再精修,能到 69.2%。Hard negatives 是精修工具,不是预训练的替代品。后训练阶段混入 40% 预训练数据,能防止性能下降。
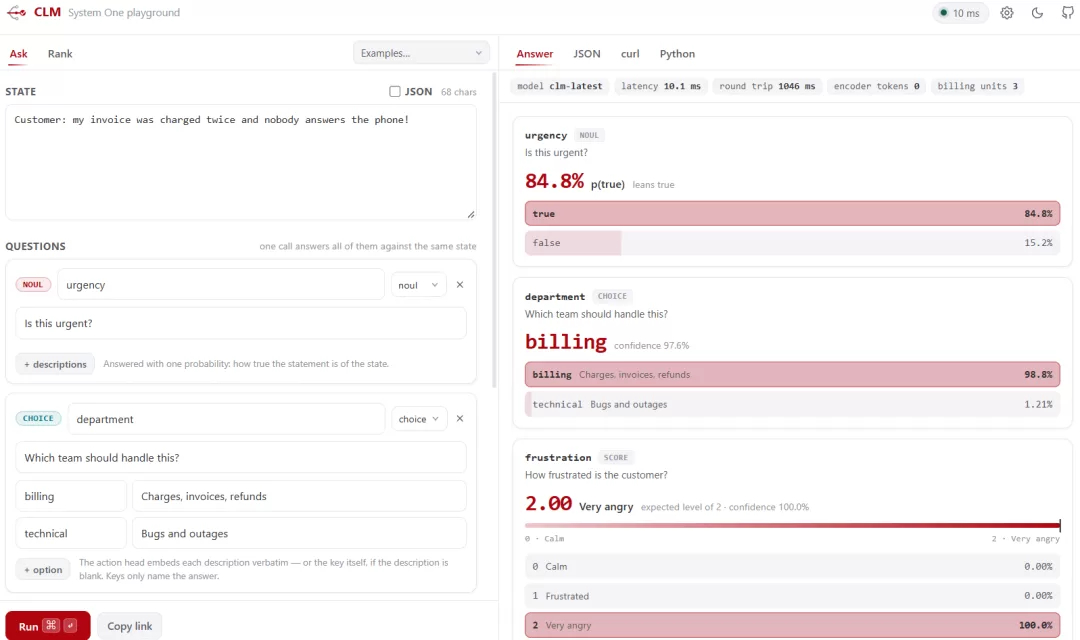
代码和模型已经在 GitHub 和 Hugging Face 上开源。仓库带 playground,可以写状态、加问题,看答案分布。跑起来也不复杂,一个 Qwen3-8B 编码服务,一个 clm-serve 进程。API 支持三种题型:Noul 返回二元概率,Choice 做分类,Score 做评分。另外还有纯 ranking 接口,用来给候选答案排序或做 best-of-N 选择。
值得注意的还有扩展定律。CLM 的测试损失随着训练算力、模型参数和数据量平滑下降,遵循标准的 scaling law。这意味着只要继续投入算力,性能还有提升空间。
CLM-8B 的意义在于:它证明了不靠逐步推理也能做出高质量决策。在需要低延迟、大批量候选动作的场景下(如计算机操作、游戏控制),直觉式决策比推理式决策更实用。当然,它并不能完全替代 LLM——CLM 没有泛化能力,无法处理训练分布外的状态和动作。但在它覆盖的场景里,速度是 LLM 的数倍,成本也低得多。