实测了一下"超级峰"的全自动视频剪辑 skill,是从选题到成片的全流水线生产,配音和字幕也包含在内。如果你配置了数字人,或者提供出镜素材,那么它可以生成更贴近 vlog 的视频。
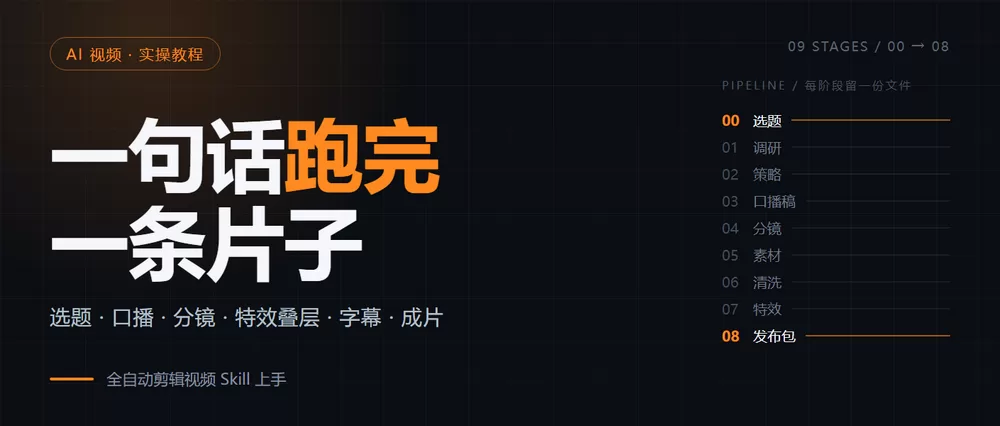
这个 skill 把视频剪辑收成一条流水线,一条视频从选题、口播稿、分镜,到去口水词、按时间轴加动效、出字幕、写发布文案,按 9 个阶段往下走,每个阶段留一份能打开检查的文件。全程就在平时跟 AI 说话的地方完成。
它不是剪辑软件,是把九道工序串成一条线
它是装进 AI 助手里的一个 Skill,可以理解成一份操作手册加现成模板和脚本。不是剪辑软件,也不是网站。能装它的 AI 助手包括 opencode、WorkBuddy、Claude Code、Codex 这类。装好之后不用打开新软件,就在你平时说话的地方提需求。
它管的事,从一句话选题开始,到调研、口播稿、分镜、素材清单;再到把录好的口播转成文字、清掉口水词和重复句、按真实字幕时间轴排动效、出成片和字幕文件、写好发布文案。
官方把边界写得很直白:不自带视频生成模型、封面生成器,也没有发布工作台。封面、标题、逐平台标签交给宿主环境的能力。自动模式也不负责对外发布。
它较真的几处地方
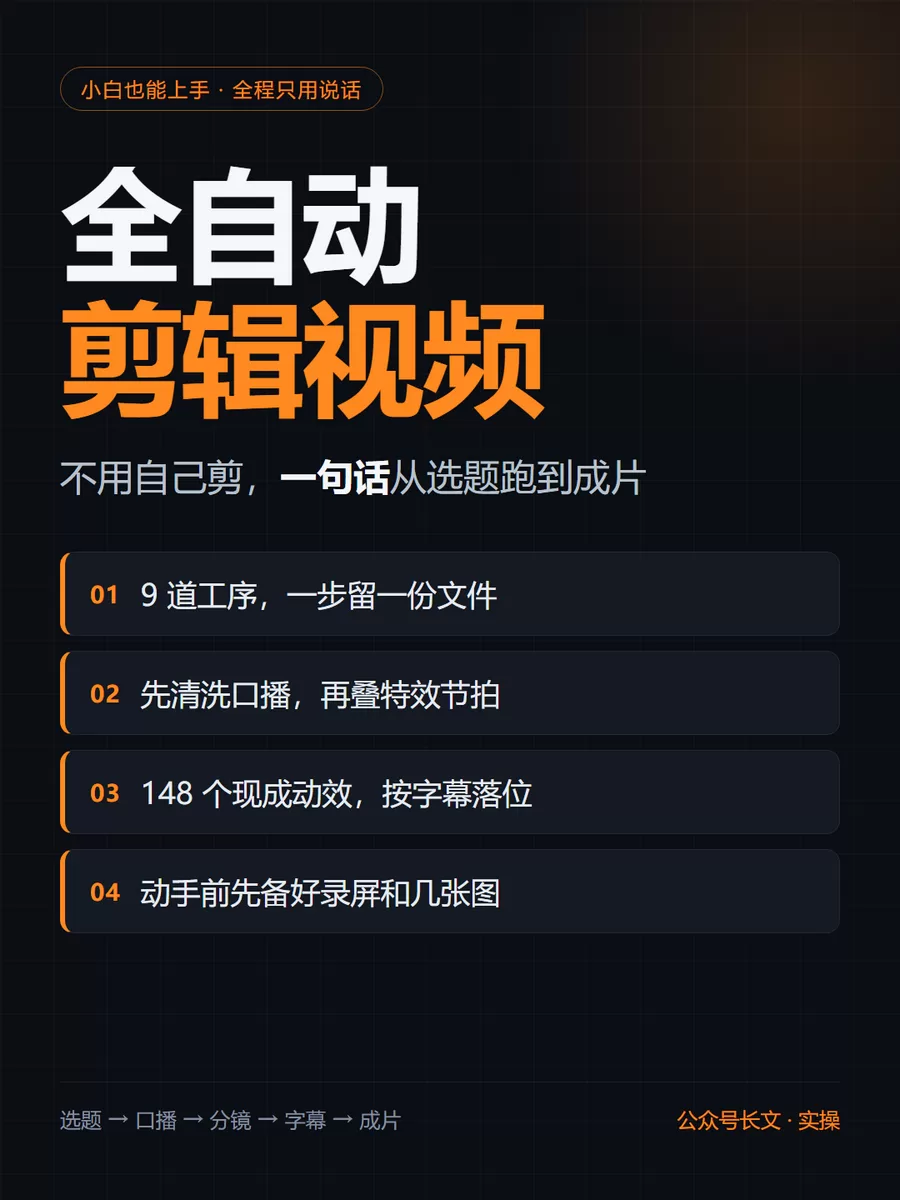
- 把剪辑拆成 9 道有文件的关卡:选题 → 调研 → 策略 → 口播稿 → 分镜 → 素材 → 清洗 → 特效 → 发布包。每一阶段留一份文件,过不了就停在门口。
- 先清洗,再上动效:节拍表只认清洗之后的真实字幕时间戳;从字幕里删掉的口水词,也要按字从声音和画面里一起删,不会音画错位。
- 148 个现成动效,按字幕节拍落位:自带网页动效片段(HTML/GSAP),另有 300 张配方卡的挑选页,先看预览再选;默认每 10 到 20 秒一个节拍。
- 渲染前逐个查剪口:每个剪口都确认没切在说话中间,通过才渲染;屏录里偶然露出的网址按实际出现的帧遮盖,导出后复查漏遮和误遮。
- 半路也能上车:手里有口播稿、录好的口播、粗剪或成片,都能从对应阶段进入,不用把前面重跑一遍。
动手前准备
有两样东西最好自己先备好:一段录屏视频,和几张素材图片。录屏指的是操作过程、产品演示这类画面,和真人对镜头的口播是两码事,两样都用得上。官方要求涉及证据、数据、产品操作的镜头用真实屏录或真实截图,不能用生成图冒充。
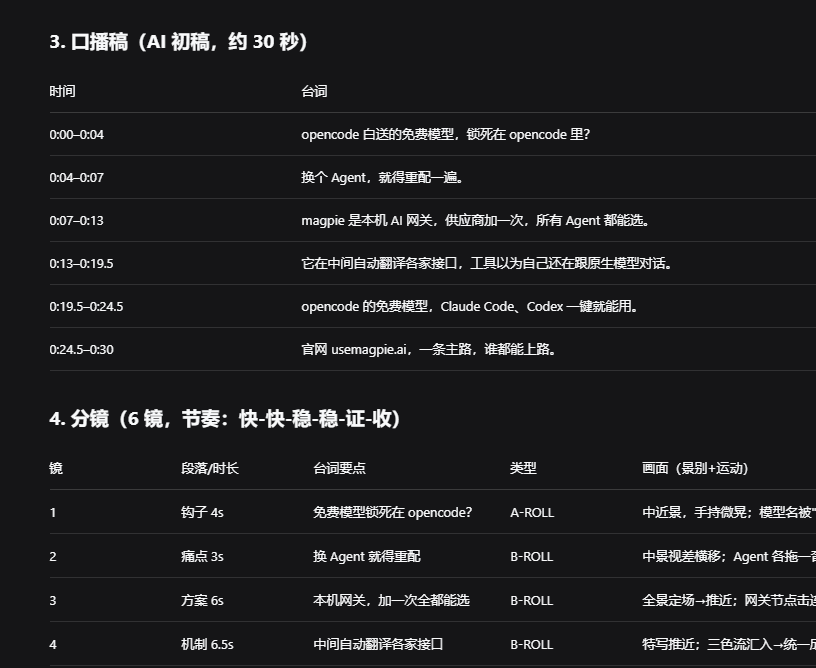
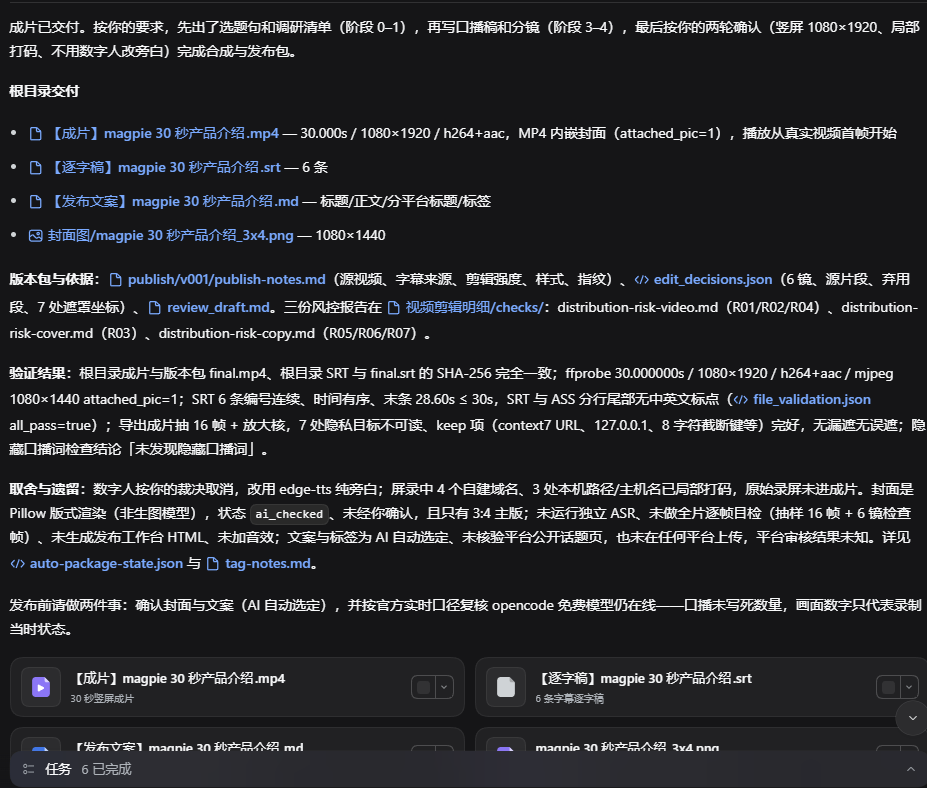
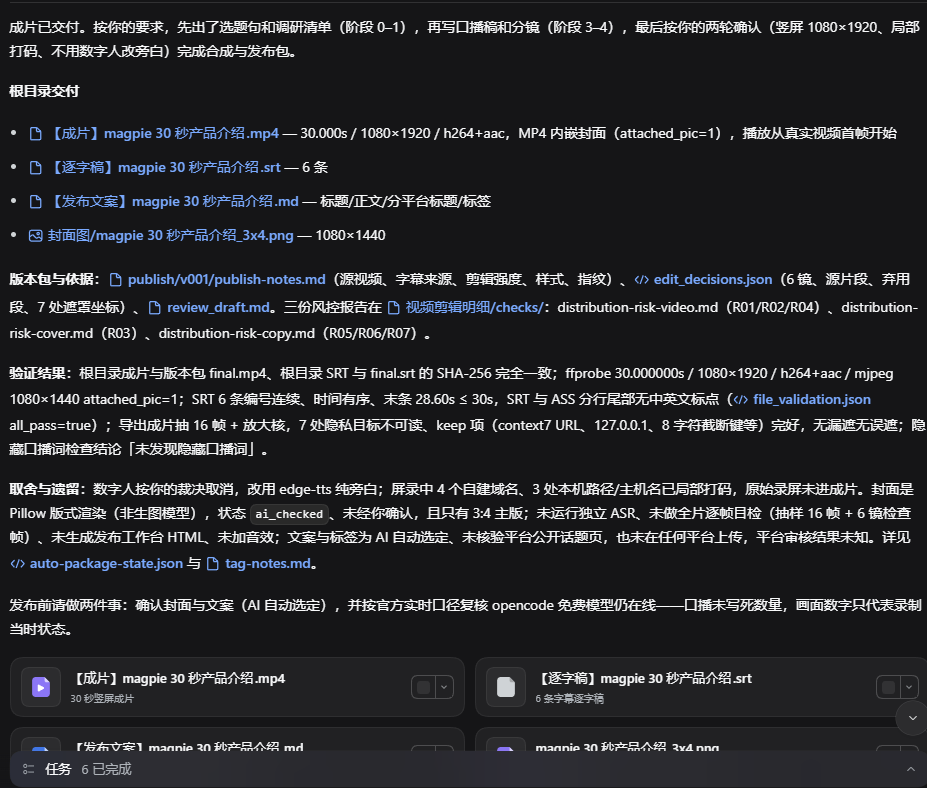
背后要跑起来的软件包括:Python 3(转写整理、剪辑渲染)、FFmpeg 与 ffprobe(渲染成片、检查剪口)、Hyperframes(要有 Node.js 22+,把动效叠到画面上)、GSAP(特效预览页)。语音识别可选云端服务(火山引擎)或本地转写工具。
怎么上手
1、装 Skill:在 AI 助手里说"帮我把 GitHub 上 mileson 的 chaojifeng-video-content-creator 这个 Skill 装到当前环境"。
2、验证环境:"先确认这台机器上有 Python 3、FFmpeg 和 ffprobe,缺哪个帮我补齐。"
3、第一次只跑一小段:"帮我做一条 3 分钟的产品介绍视频,这次只出选题句、调研清单、口播稿和分镜,不渲染成片。"
4、将录屏、素材图交给 Agent:"这是录好的口播,转成文字后清掉口水词和重复句,再按清洗后的字幕时间排动效节拍。"
5、走自动模式:补一句"这个视频,走自动模式"。它会依次做剪辑与字幕、标题正文和逐平台标签、封面图片、发布材料汇总。
半路也能上车:只有口播稿就从分镜和动效绑定开始;已有粗剪或成片就从字幕和发布包开始。没验证的会写明白:交付时会列出口播稿是否本人朗读、时长是否仍是估算、成片有没有播放抽查过,不把没做的事说成做完。