发顶会论文,最费事的是把结果写成审稿人一眼就记住的样子。这个 Claude Skill 把 60 篇 CVPR、ICCV、NeurIPS 获奖论文逐句拆开,蒸馏成一套写作引擎。喂一句摘要进去,出来的是带主张、带配图规划、带检查器的获奖风格底稿。
它是什么
给发顶会的 ML / CV 研究者用的 Claude 或 Codex Skill。输入是你的研究,填表或贴一段摘要都行,输出接近获奖论文写法的底稿。摘要、引言、方法、实验,还有配图。它按 8 类论文走不同论证路线:方法改进、新能力、规模规律、再检验、机理、理论、数据集、测量。
不写 related-work 综述,不写 rebuttal,也不做纯校对。
写出来的稿子长啥样
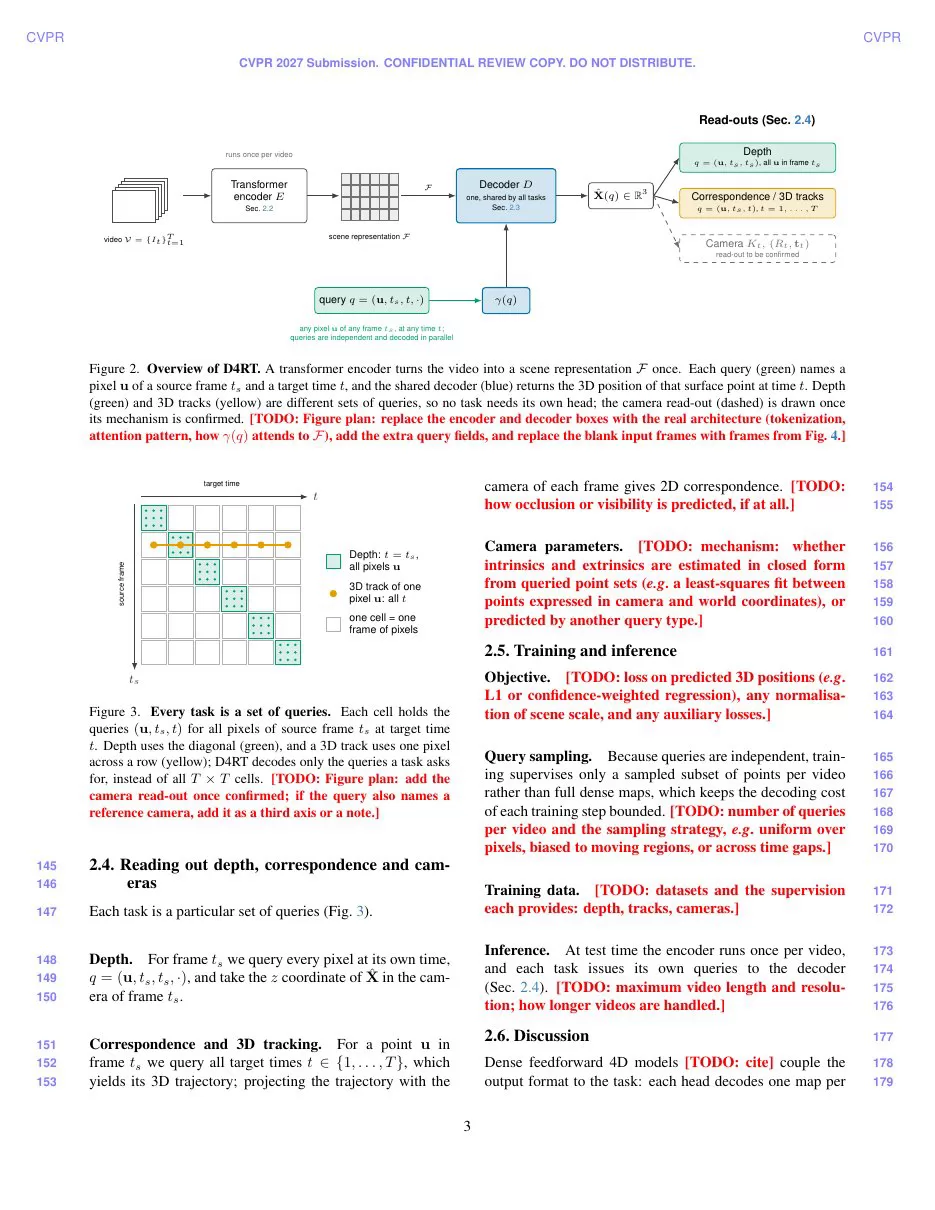
摘要先点缺口再给主张,少数几个数字撑起结论,不铺泛泛背景。Figure 1 的图注里写着 TODO 规划:散点图放哪、峰值标在哪、要几张图,先占好位再等结果。
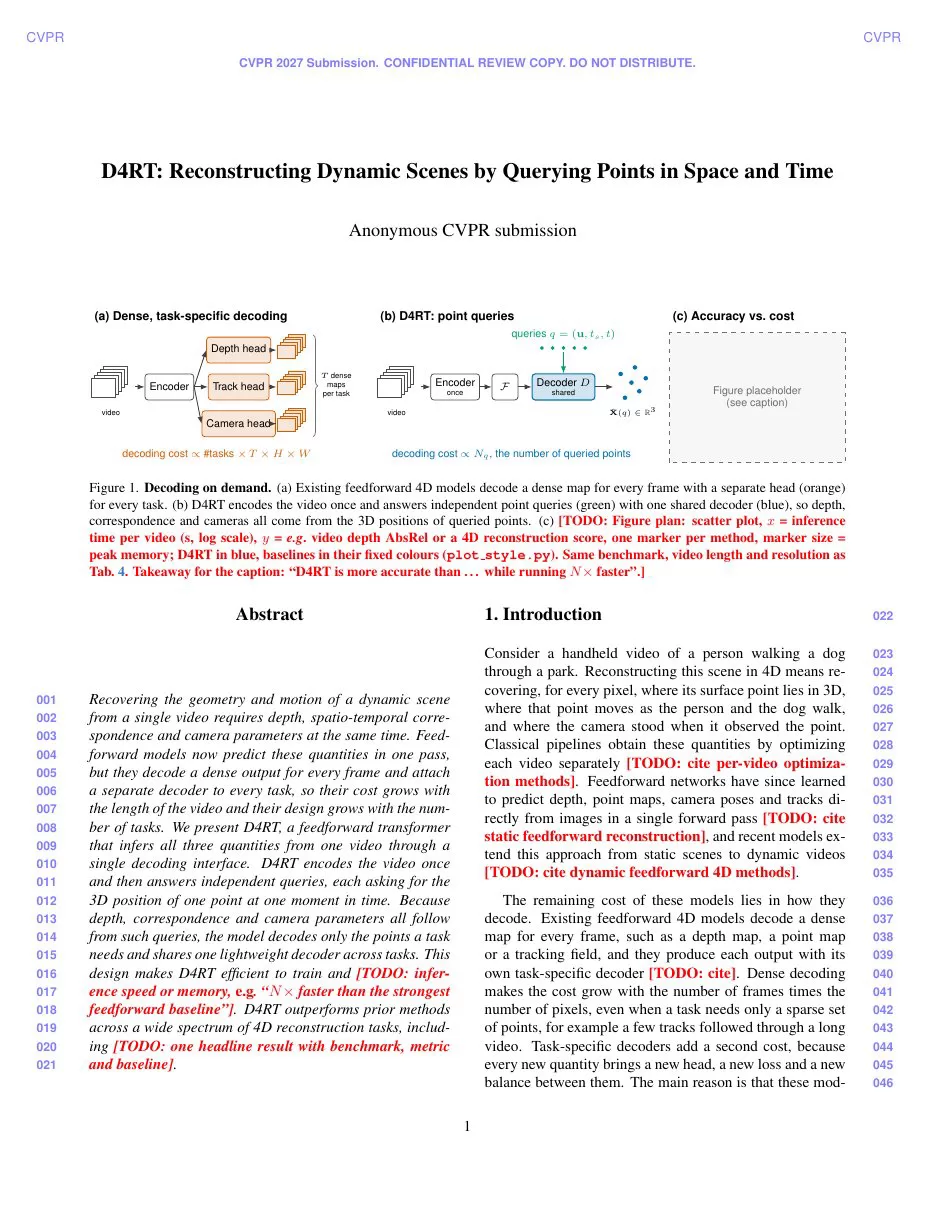
方法部分按「需要、机制、性质」展开每个组件,第二个组件解决第一个留下的问题,不并排罗列。写之前先逼你答四个问题:解决什么技术问题、为什么没有现成方案、贡献是什么、凭什么成立,全答完才动笔。
篇幅也卡在语料线上:摘要中位 174 词、七句左右,引言中位 613 词。配图能画就画,Figure 1、方法总览用 TikZ 直接出图。需要实验结果的图不瞎画,留白把规划写进图注。
跟通用 AI 写的差在哪
通用 AI 的稿子彼此相似:先铺背景,组件并排罗列,句尾总带一个 making X possible。获奖论文不是这么写的。check_draft 给每张草稿一个语料百分位。句尾分词短语,通用 AI 草稿约 32% 的句子这么写,获奖论文只有 8%。开头是具体场景而非泛泛背景,局限留到 Limitations 不进摘要。
逻辑连接词每百词 0.9 个,90% 的获奖论文不超过 1.4。句长均值 23 词,10% 到 90% 落在 20 到 29。这些阈值是从 55 篇里跑出来的。
项目结构
Best-Paper-Writing-Skill/
├── skills/bestpaper-writing/   skill 本体
├── data/                       语料:papers.csv、figure_stats.json
├── template/CVPR2027/          官方 LaTeX 模板
├── assets/                      logo 与配图样式
├── tools/                       语料配图统计脚本
├── PAPER_LIST.md               60 篇清单
├── install.sh                   一键安装
└── README.md                    双语文档
安装一条命令:
bash install.sh分 claude 和 codex 两个目标,装进各自的 skills 目录,同一份 SKILL.md 两边通用。没有现成材料时填那张离线表单,必填只 5 项,缺了 skill 先追问一次再动笔。
Github:https://github.com/gulucaptain/Best-Paper-Writing-Skill