构建研究 agent 需要协调模型响应、工具执行、权限和证据存储。
本文介绍 Claude Agent SDK,解释它负责的工作,并将其方法与 LangChain 和 LangGraph 进行比较。
随后我们将构建一个 Python 证据收集器,用于获取公开来源,通过自定义工具记录结构化声明,并保留检索响应和执行事件以供检查。
一、为什么需要 Agent SDK
考虑这样一个应用:它接收某人的姓名和雇主,然后生成该人士公开职业背景的档案。应用需要找到相关页面,确认这些页面描述的是同一个人,提取声明,并区分当前职位与过去的职务。
一次模型调用只处理该过程中的一次交互。应用提供指令和上下文,模型生成响应,其中可能包含文本,也可能包含使用工具的请求。对于自定义工具,该请求会标识一个操作及其参数;模型外部的软件执行该操作并返回结果。
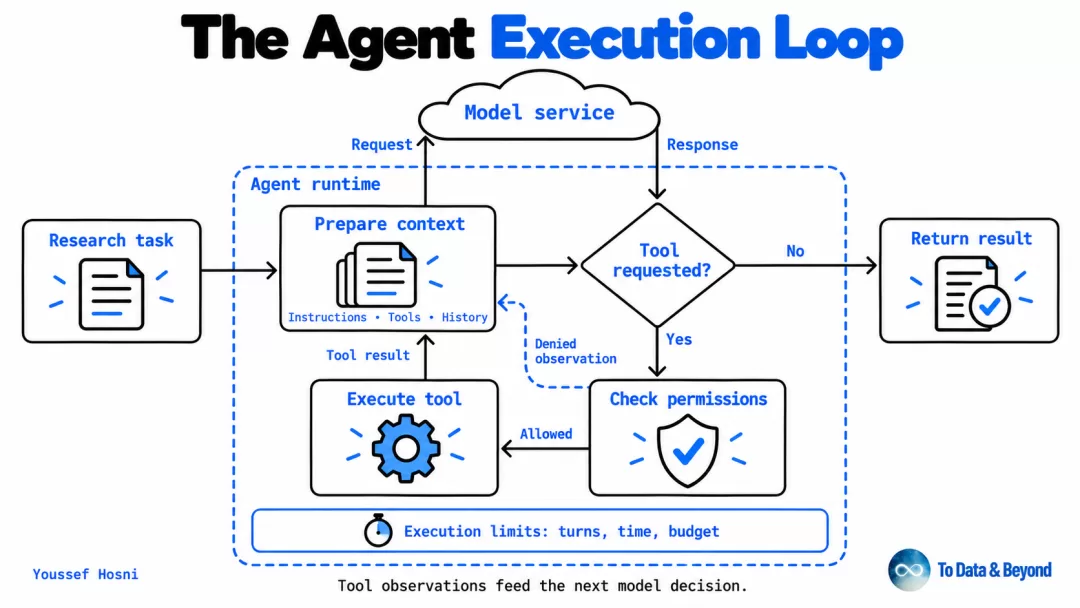
这种重复交互就是 agent loop:提供当前上下文,获取模型响应,执行获准的工具请求,纳入观察结果,然后继续执行。运行时还需要识别完成状态,并强制执行配置的执行限制。
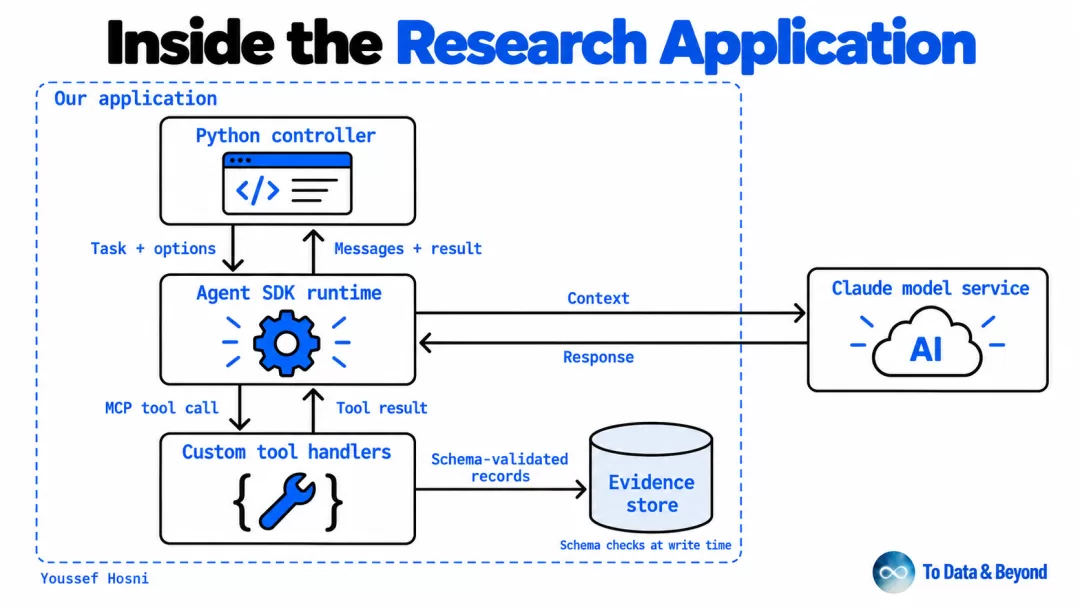
在 Claude Agent SDK 中,运行时负责管理这种交互,并以消息流的形式向应用程序公开,其中包括工具活动和最终结果。
二、Claude Agent SDK、LangChain 和 LangGraph
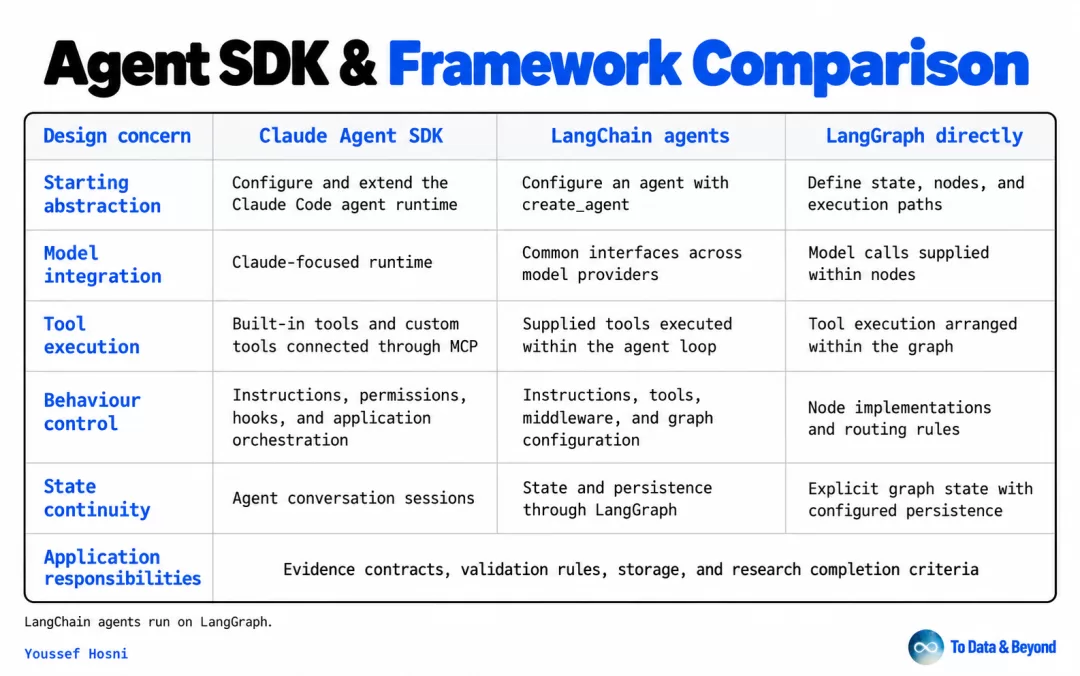
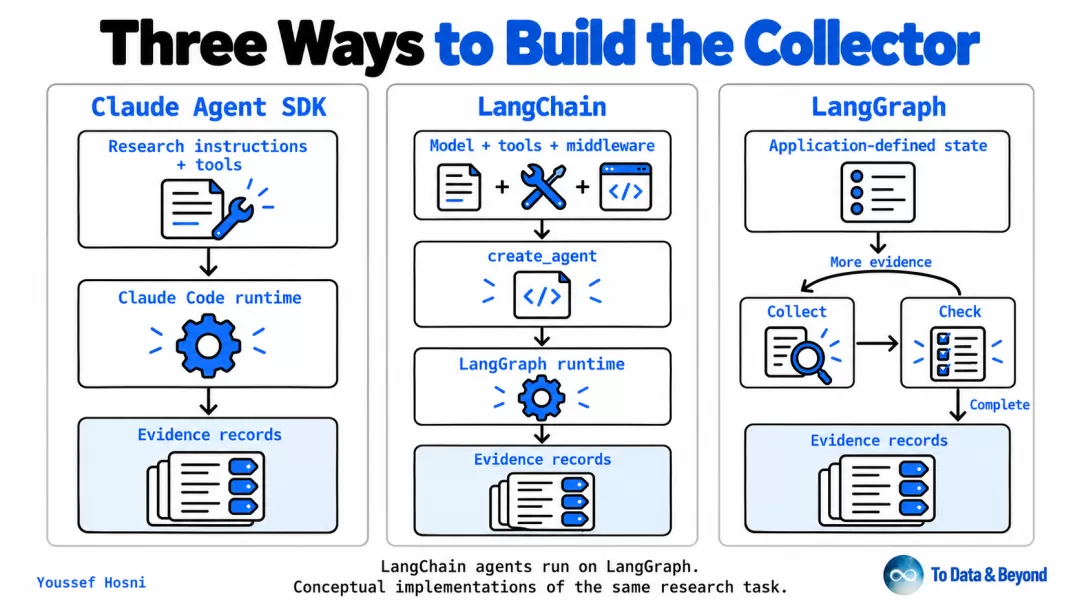
同一个人物研究应用可以使用 Claude Agent SDK、LangChain 或 LangGraph 实现。框架选择会影响我们表达这些职责的方式、继承哪些执行机制,以及对单个状态转换拥有多少控制权。
LangChain 提供模型集成、工具抽象,以及通过 create_agent 实现的可配置 agent。它的集成支持多个模型提供商,因此当应用需要跨提供商的通用接口时很有用。
LangGraph 提供了一个基于状态、节点以及节点之间连接的底层编排模型。节点执行某项操作并产生状态更新;路由逻辑决定下一步运行哪项操作。
Claude Agent SDK 通过 Python 和 TypeScript 公开 Claude Code 底层的执行运行时。它包含内置工具、工具权限、sessions、hooks 和 subagent delegation。
三、SDK 的主要组件
A. 配置和指令
Python SDK 将执行设置集中在 ClaudeAgentOptions 中。system prompt 定义 agent 的固定指令,而 task prompt 则提供某次运行的具体任务。
from claude_agent_sdk import ClaudeAgentOptions
options = ClaudeAgentOptions(
    model="sonnet",
    system_prompt="Collect public professional evidence...",
    tools=["WebSearch", "WebFetch"],
    allowed_tools=["WebSearch", "WebFetch"],
    permission_mode="dontAsk",
    setting_sources=[],
    max_turns=8,
    max_budget_usd=0.50,
)
这里的 "sonnet" 是一个模型别名。八轮设置限制工具使用轮数,而每一轮可能包含多次工具调用。USD 预算是根据运行时成本估算得出的近似停止阈值。
B. 工具和 MCP
工具提供模型可以请求的操作,例如获取页面或记录声明。在 Python 中,SDK 通过 @tool 暴露自定义函数,并使用 create_sdk_mcp_server 注册它们。生成的 server 在我们的 Python 进程内运行。
C. 权限和执行控制
allowed_tools 设置会预先批准匹配的调用,其他调用则遵循剩余的权限规则和活动模式。在 dontAsk 模式下,需要权限提示的调用会被拒绝。
D. 启动运行并读取消息
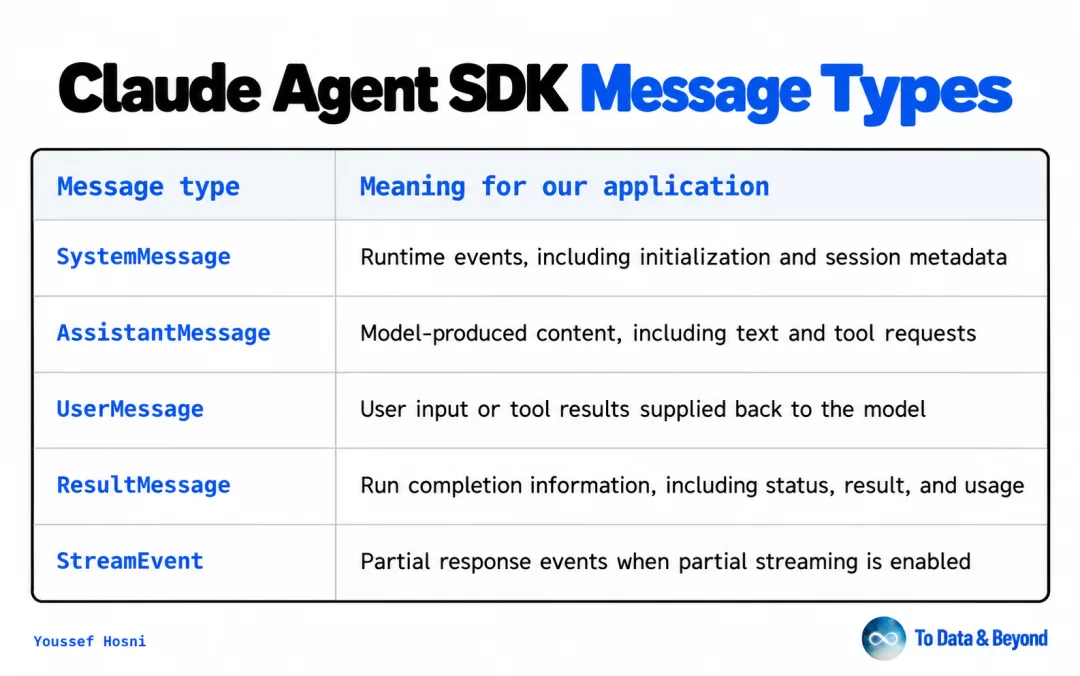
query() 接口接收任务和配置,然后随着运行进展生成消息。Python 的 async for 会消费这一异步流,而运行时负责协调模型请求和工具执行。
E. 结构化输出和应用契约
SDK 的 output_format 选项接受描述预期最终输出的 JSON Schema。在 Python 中,我们可以从 Pydantic model 推导该 schema,并使用同一个 model 验证返回的 structured_output。
F. Sessions、subagents 和 hooks
对于持续交互,ClaudeSDKClient 会在客户端连续提交任务时维护对话。专业 agent 通过 AgentDefinition 定义,其中指定其指令、描述、工具和可选的模型选择。
四、定义收集器并准备项目
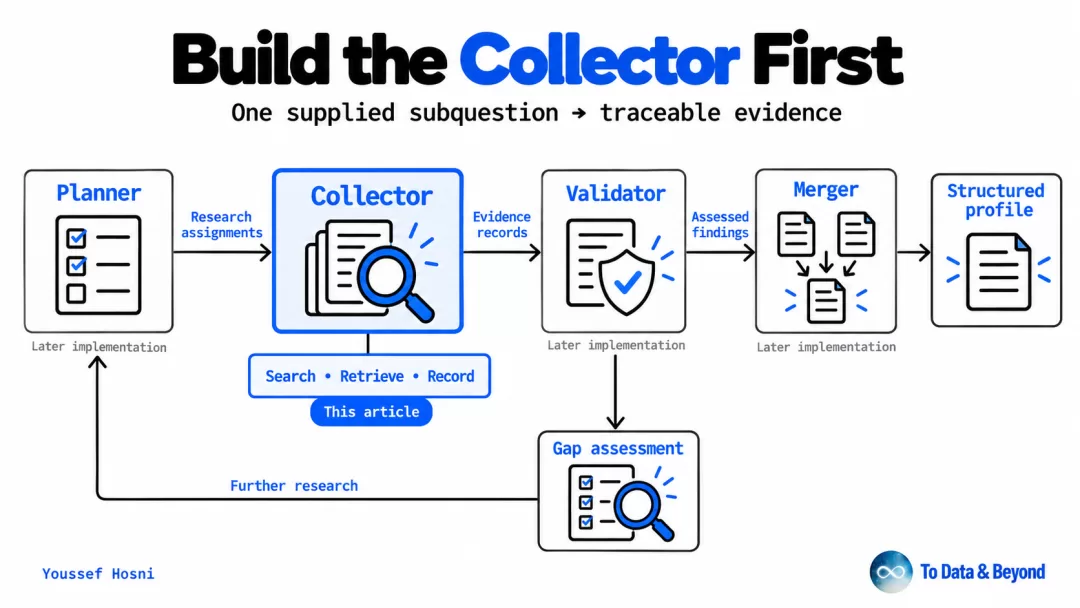
第一个实现将针对某人公开职业背景中的一个研究 subquestion 收集证据。其输入会标识研究对象,提供一个身份锚点,并指定要调查的信息。
五、实现并检查证据收集 Agent
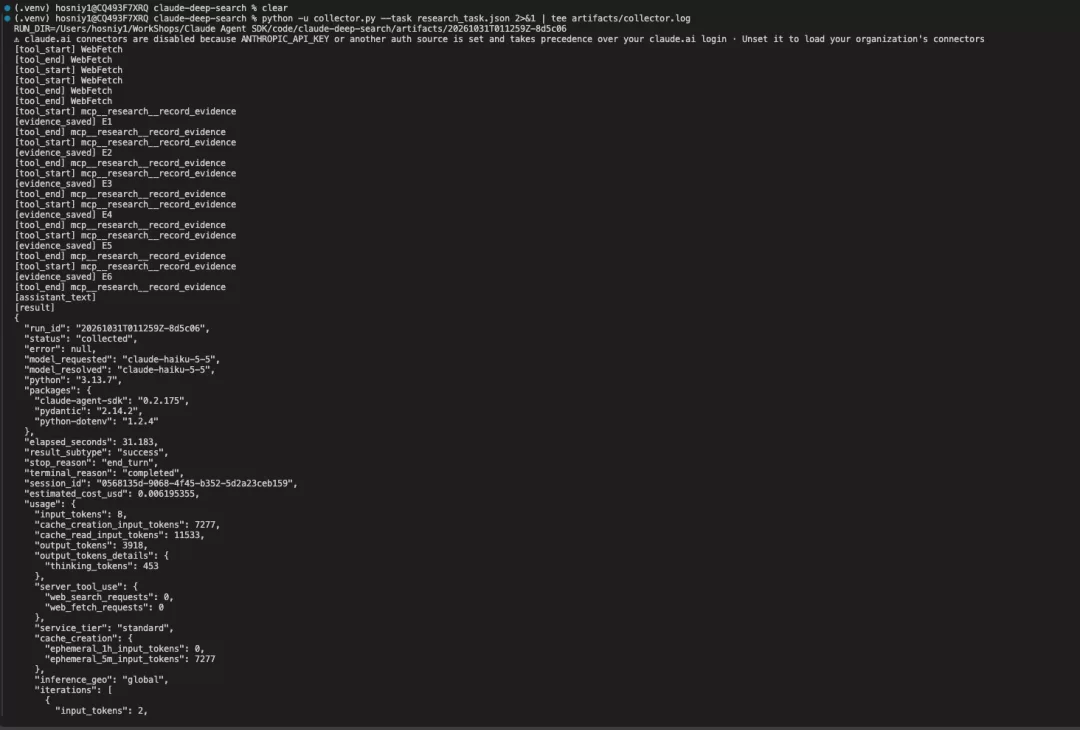
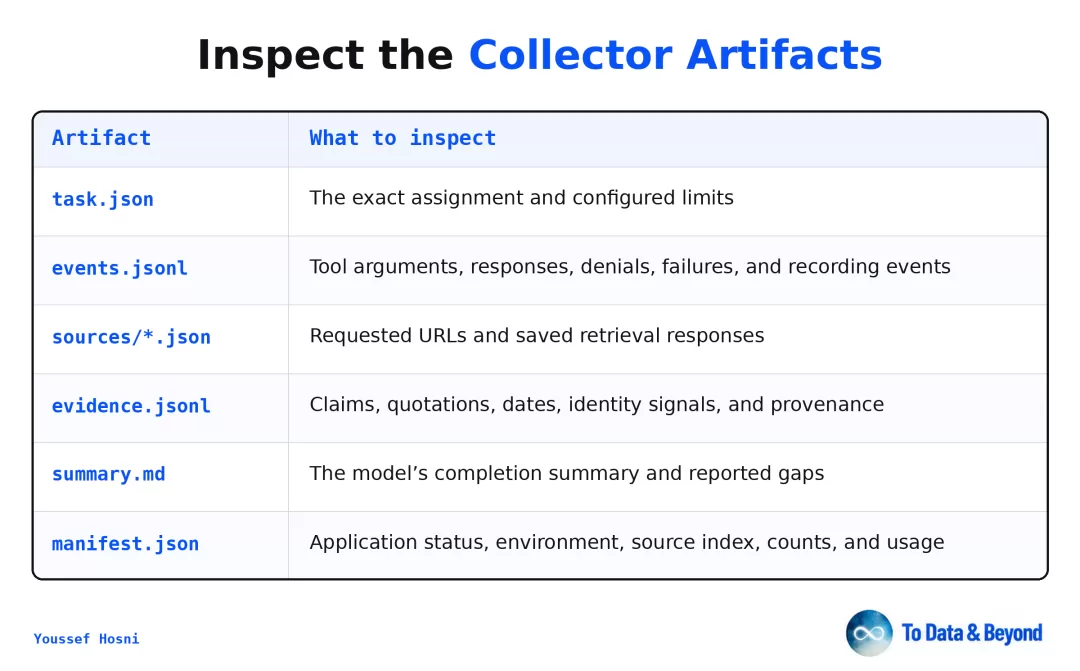
收集器将接收 research_task.json 中定义的任务,检查一组有界的来源,并通过自定义工具持久化证据。每次执行都会创建独立目录,其中包含任务、工具事件、检索响应、证据记录和完成信息。
A. 定义证据契约和接纳检查
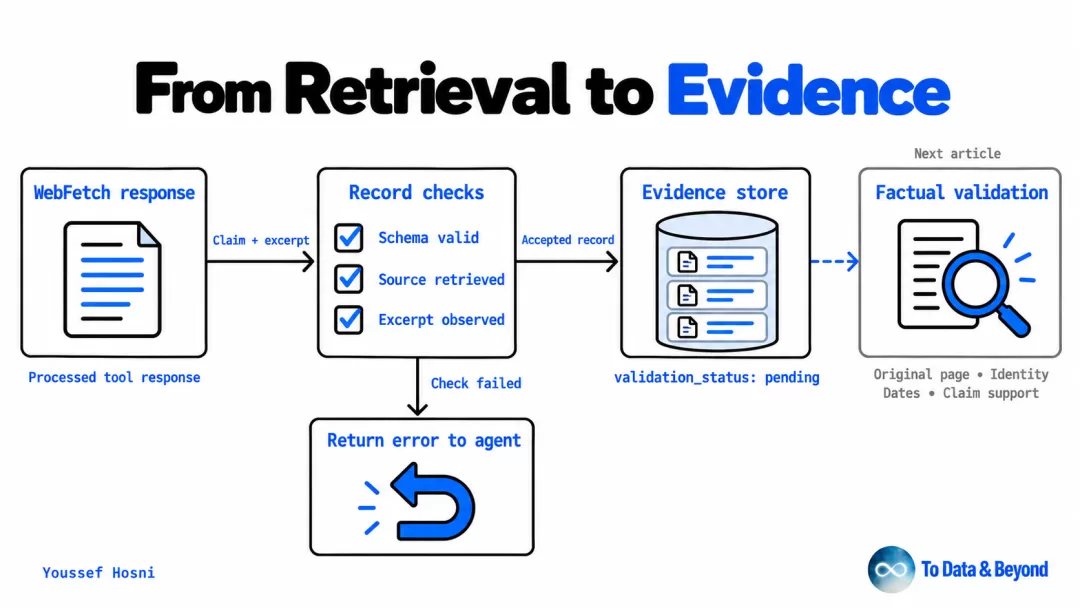
该实现使用两个 Pydantic models:ResearchTask 验证任务,EvidenceInput 验证提交给记录工具的参数。证据 schema 要求提供声明、来源 URL、来源分类、标题、支持性摘录和身份信号。
B. 控制执行并保留 trace
我们将使用 PreToolUse hook,只允许该收集器所需的三个操作,并在向 WebFetch 提交新 URL 前预留来源名额。检索完成后,第二个 hook 会保存工具响应并注册可用来源。
C. 运行收集器并捕获 artifacts
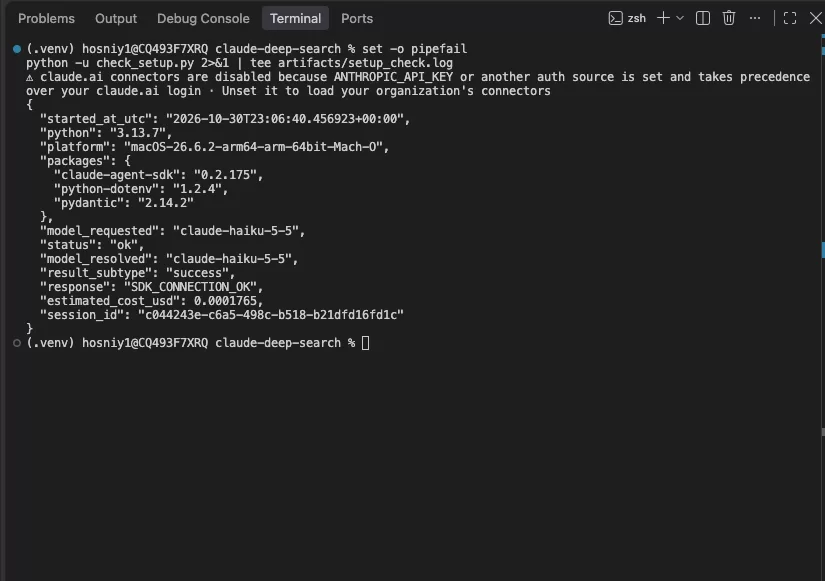
激活环境并安装依赖:claude-agent-sdk==0.2.175、python-dotenv==1.2.4 和 pydantic==2.14.2。每次运行都会写入独立的 artifacts 目录,source files 保存处理后的检索响应,而证据记录则引用接受它们时所使用的具体响应。
总结
第一次实时运行在 31.183 秒内完成,从两个不同的来源 URL 保存了六条证据记录,并报告约 $0.0062 的估计成本。
collected 状态确认执行成功并保存了证据,事实验证仍处于 pending 状态。
下一步架构工作是为 pending 证据提供明确的审查流程。
validator 必须评估每个来源是否涉及目标人物,其文本是否支持声明,以及日期是否足以证明某个职位可以描述为当前职位。