AI代码审查最难的,已经不是“能不能找到问题”,而是“不同工具的分数到底能不能信”。
GitHub刚发布ReviewBench:用1.039亿个真实Pull Request刻画工作负载,再用219个公开任务建立一套可复现的评测尺。
想象一个普通工作日:开发者提交了一个改动,AI审查器几秒钟后留下十几条评论。有人说它很细,有人说它太吵;换一个模型,评论数量少了,却可能漏掉真正影响线上稳定性的错误。问题是,团队很难回答:这次升级到底变好了,还是只是换了一种“看起来更聪明”的表达方式?
10月5日,GitHub发布研究预览版ReviewBench,正面解决这个测量问题。它不是又一个模型榜单,而是一套让代码审查Agent在同一批真实Pull Request上接受比较的公开基准。真正的新闻点不在于谁暂时排名第一,而在于AI代码审查开始从“厂商演示”走向“可复现的工程评估”。
一、ReviewBench到底测什么
ReviewBench把一次代码审查拆成三个问题:Agent找到了多少真正的问题?它说出的评论有多少是有效的?它有没有发现原始标注里没有提前写出的新问题?这对应精确率、召回率,以及对“新发现”的增强指标。
关键事实卡
• 1.039亿:GitHub用于刻画语言、仓库规模和改动形态的Pull Request样本量
• 219个:ReviewBench完整评测任务,来自187个公开开源仓库
• 19种:覆盖的编程语言数量;任务分布尽量贴近GitHub整体
• 96.6%:独立高级工程师对黄金标注真伪判断的一致率
这里有一个容易被忽略的设计:语言和仓库规模尽量按真实分布抽样,但Pull Request大小会向更值得审查的中大型改动倾斜,减少大量“一行改动”把结果冲淡。换句话说,ReviewBench不是随机抓一批代码,而是在尽量保留生产感的同时,保证每个任务真的有审查价值。
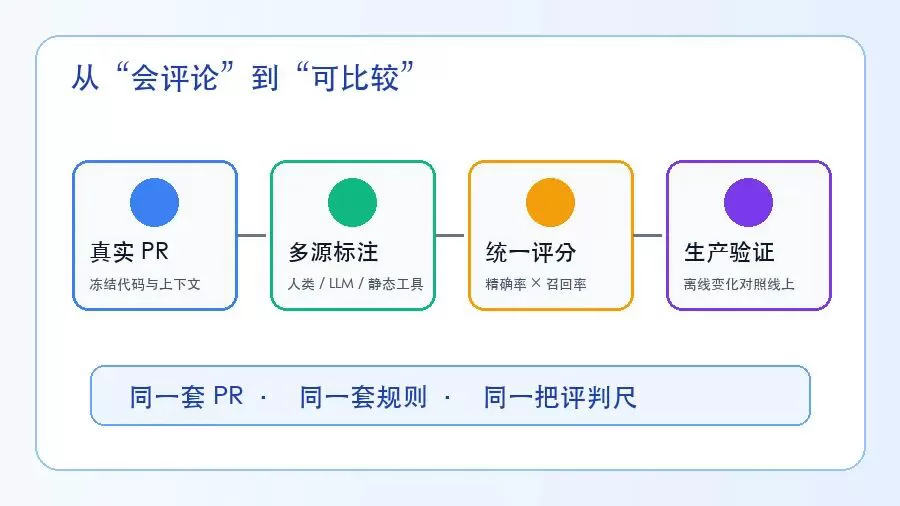
ReviewBench的基本链路:真实PR → 多源标注 → 统一评分 → 对照生产效果。
二、它为什么比普通Benchmark更接近真实工作
传统代码审查评测常见两种问题:要么样本像考试题,和日常PR差距很大;要么只依赖一位专家或一组固定标签,覆盖范围有限。ReviewBench的做法是把多种来源放在同一条流水线上:真实人工评论、作者后续修复暗示的问题、静态分析工具,以及多个前沿大模型的候选发现。
候选发现会先做语义去重,再按统一标准判断:问题必须真实、相关,而且值得在代码审查中提出。官方还公开了评测规则、数据集、判定器和运行方式,并用没有参与构建数据集的高级工程师做独立复核。这让团队可以检查“为什么得分”,而不是只看到一条不可解释的榜单。
一个可复现的真实任务链
1. 把自己的代码审查Agent封装成容器,读取PR和diff。
2. 先跑25个测试任务,确认输出格式、路径和权限都正确。
3. 在完整219个任务上调Prompt、模型和工具链。
4. 通过官方流程进行三轮正式评测,再决定是否提交排行榜。
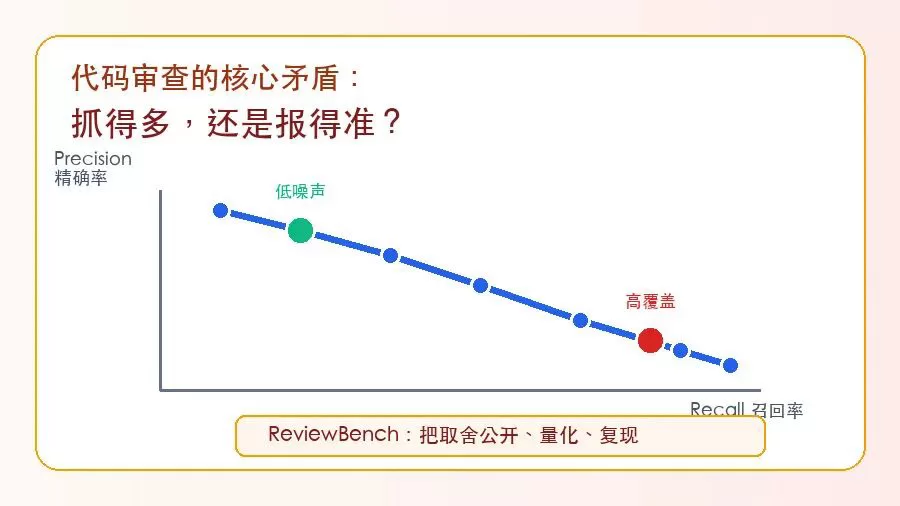
代码审查的核心取舍:更高召回率可能带来更多噪声,低噪声也可能意味着漏报。
三、第一批结果说明了什么
ReviewBench官网当前排行榜显示,Copilot Code Review的Balanced配置位列第一,官方记录的已知问题精确率约87.8%,已知问题召回率约26.0%;Devin位列第二,已知问题精确率约84.0%,召回率约23.8%。这些数字至少说明:高精确率和高召回率并没有自动同时出现,代码审查依然是一个取舍问题。
但不要把这张榜单理解成“谁的模型最强”。官网明确提醒,初始结果由ReviewBench团队按当时公开产品配置运行,厂商没有逐项核验,结果只代表这套基准和当时的版本。它更适合回答“在共同条件下,这些审查器的行为差异是什么”,不适合替代你自己的代码库测试。
LangChain对自己的ReviewBench任务做了另一组实验,也给出了重要的反面提醒:在基础Agent框架下,最强运行大约只能找回30%的基线问题;当Prompt明确要求先梳理改动、追踪调用方、检查测试和相关实现后,同一个模型的20任务切片得分升到0.32。也就是说,评测结果不仅由模型决定,审查策略和Harness同样关键。
需要冷静看待的边界
• 219个任务对工程评测已经有价值,但相对GitHub海量PR仍然有限。
• 统一判定器是Claude Sonnet 5,LLM-as-judge经过校准和专家审计,但仍不是人类判断的完全替代品。
• 公开仓库样本不等于你的私有业务;安全、合规和领域知识仍需单独验证。
四、普通团队现在该怎么用先建自己的小基准:挑选20—50个历史PR,标出真正造成返工、线上事故或安全风险的问题,形成团队黄金集。同时看四个指标:高严重度召回率、有效评论精确率、每个PR的评论数量、从提交到结果的耗时。升级不要只换模型:把审查顺序、上下文范围、工具权限、失败重试和人工确认一起作为变量。
ReviewBench真正测量的,不是AI会不会挑错
而是它能否在真实工程里,稳定地发现值得人类采取行动的问题。
数据来源
1. GitHub官方发布:https://github.blog/ai-and-ml/github-copilot/reviewbench-an-open-benchmark-for-ai-code-review/
2. ReviewBench官方站点与排行榜:https://review-bench.ai/
3. ReviewBench开源仓库与方法文档:https://github.com/review-bench/ReviewBench
4. ReviewBench官方API排行榜:https://review-bench.ai/api/leaderboard
5. LangChain独立实验:https://www.langchain.com/blog/evaluating-code-review-agents-with-reviewbench
6. Tech Report交叉分析:https://techreport.ngo/ai-ml/reviewbench-an-open-benchmark-for-ai-code-review/
7. GitHub ReviewBench项目数据:https://api.github.com/repos/review-bench/ReviewBench