10 月 2 日,OpenAI 发布了 GPT-6 系列的选用指南。它面向的是准备把模型接进生产系统的工程与产品团队。整份指南的核心判断只有一句:选模型不是「上最强的那个」,而是在智能、价格、延迟三者之间找平衡点。
先把三档模型对上你的活
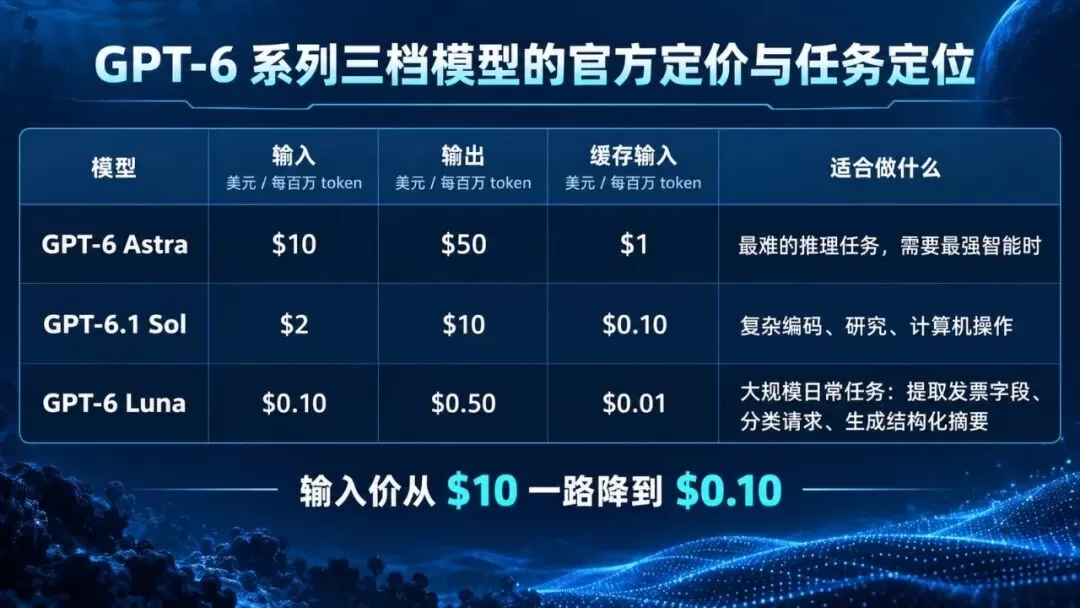
GPT-6 系列目前分三档。GPT-6 Astra($10/$50 每百万 token 输入/输出)用于最难的推理任务,需要最强智能时使用。GPT-6.1 Sol($2/$10)适合复杂编码、研究、计算机操作。GPT-6 Luna($0.10/$0.50)适合大规模日常任务,如提取发票字段、分类请求、生成结构化摘要。输入价从 $10 一路降到 $0.10,缓存输入价更是拉开到 1/10 的量级。同一个任务落在哪一档,账单可以差出两个数量级——这也是为什么「默认最强」几乎总是错的起点。
推理档位:不是越高越好
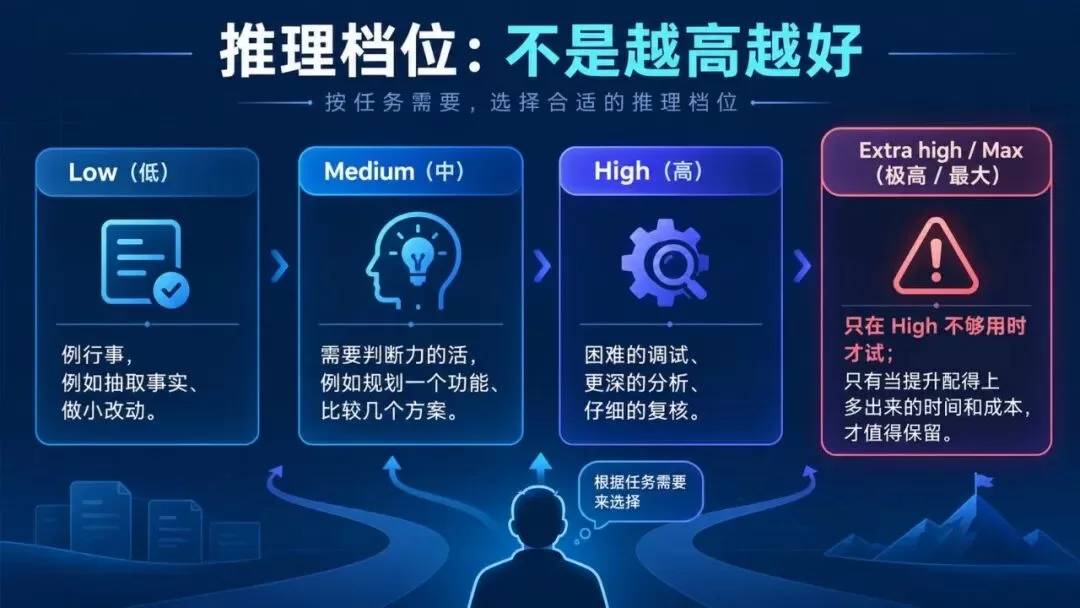
在 API 里可以单独指定模型为一次任务投入多少推理强度。Low(低)用于例行事,如抽取事实、做小改动。Medium(中)用于需要判断力的活,如规划功能、比较方案。High(高)用于困难调试、更深分析、仔细复核。Extra high / Max(极高/最大)只在 High 不够用时才试,而且只有当提升配得上多出来的时间和成本,才值得保留。升档没有门槛,但「保留」有条件。收益没跑出来之前,别默认长期挂在最高档。会话中途可以调整推理强度,且不会破坏缓存。
速度也是可调项
响应时间是第三角。聊天应用或编码工具这类对延迟敏感的场景,可以用 Fast mode(快速模式):响应更快、更稳定,代价是每 token 单价高于标准处理。如果只想加快生成速度、不想动推理强度,还有 Ultrafast(超快模式)——它独立于推理强度加速 token 生成,目前适用于 GPT-6 Astra。
长任务怎么把成本压住
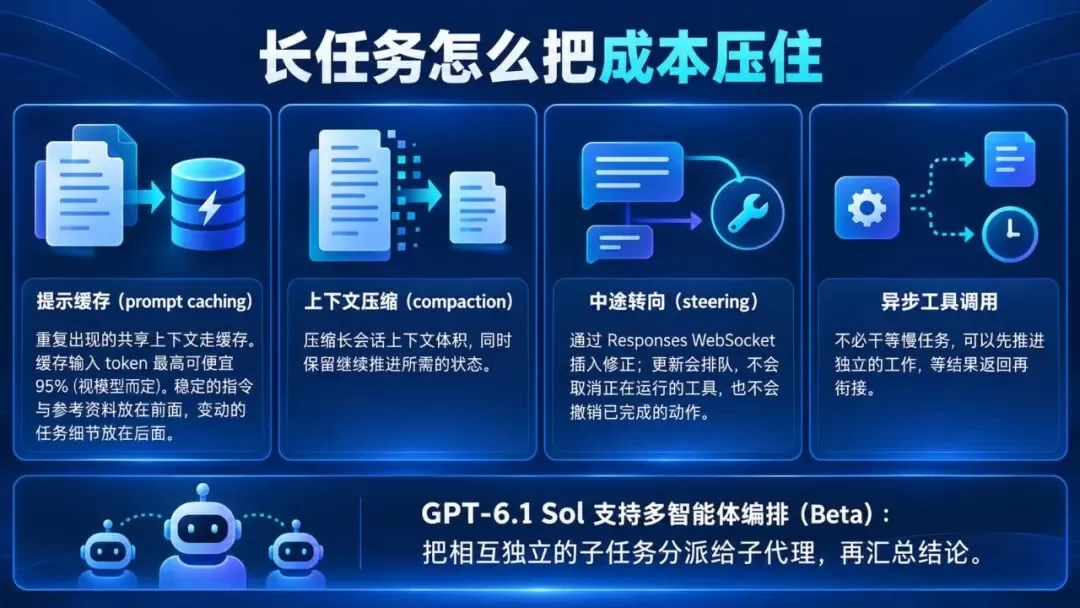
任务跨度一旦拉到几小时甚至几天,成本主要烧在上下文上。指南给了四类手段:提示缓存(prompt caching),重复出现的共享上下文走缓存,缓存输入 token 相比未缓存最高可便宜 95%。上下文压缩(compaction),长会话中压缩上下文体积,同时保留继续推进所需的状态。中途转向(steering),通过 Responses WebSocket 接口在模型工作过程中插入修正。异步工具调用,模型不必干等慢任务,可以先推进独立的工作,等应用把结果返回再衔接。此外,GPT-6.1 Sol 支持在 Responses 接口里做多智能体编排,把相互独立的子任务分派给子代理,再把结论汇总成最终回复。
上线前,先把这几件事量化
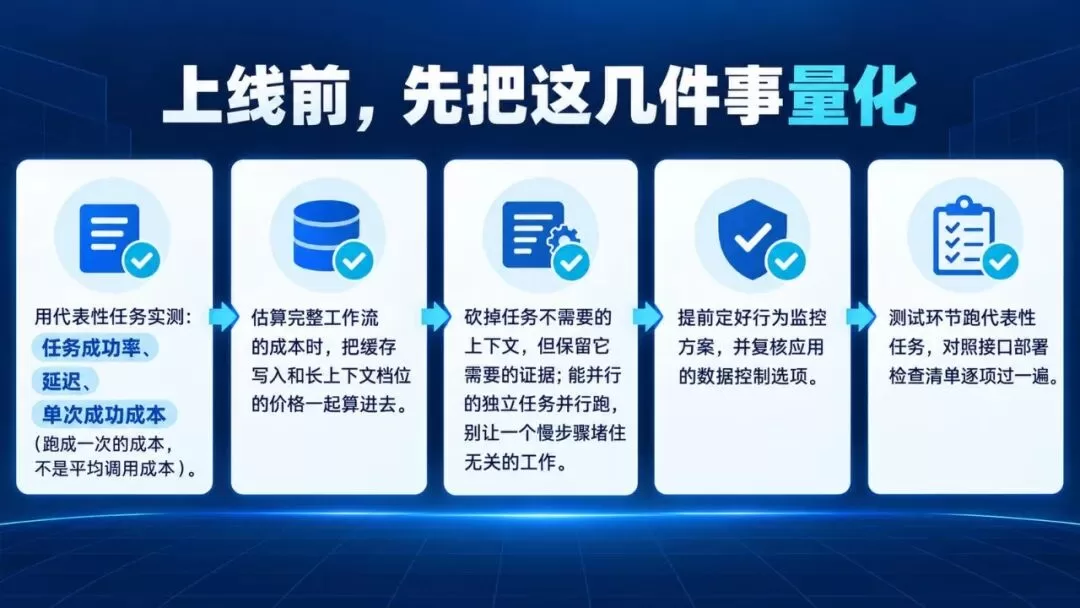
部署之前,指南要求把指标落到数字上:用代表性任务实测任务成功率、延迟、单次成功成本——注意是「跑成一次」的成本,不是平均调用成本。估算完整工作流的成本时,把缓存写入和长上下文档位的价格一起算进去。砍掉任务不需要的上下文,但保留它需要的证据。能并行的独立任务并行跑,别让一个慢步骤堵住无关的工作。提前定好行为监控方案,并复核应用的数据控制选项。
三档都能操作电脑
计算机操作(computer use)能力对 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 三档都开放,可以与网站和桌面应用直接交互,包括那些没有接口的软件。原则是选最简单可靠的路径:能用接口或已接入的工具就别上屏幕操作,需要读屏、点按钮、填表单时才用它。自己集成时,浏览器侧可以用 Playwright,桌面侧可以用 PyAutoGUI。