很多 Buddy 们在使用 WorkBuddy 时,都可能遇到过:对话一长就开始出错;只想聊思路,但直接生成了文件;技能装了不少,真正要用时反而不知道怎么选...
7 月 30 日晚的直播中, WorkBuddy 产品经理 Anne 集中回答了这些问题。想看完整的直播内容,可以移步至👉[从模型到Harness:WorkBuddy如何把Agent做成可用产品](https://mp.weixin.qq.com/s?__biz=MzYzODgxODMzNQ==&mid=2247489478&idx=1&sn=d3e025d2b32eb8b5b79519df735ac9d2&scene=21#wechat_redirect)
我们将其中一些高频提问整理了出来,形成了对应的操作技巧,帮助 Buddy 们的 WorkBuddy 越用越顺手,也越来越懂你!
技巧 1 · 对话框右下角的“上下文用量”
> Q:对话聊久后, Agent 开始遗漏要求、反复出错,怎么判断是模型能力问题,还是上下文快满了?
WorkBuddy 对话框右下角有一个灰色的小圈,很多人经常用但没点开过。
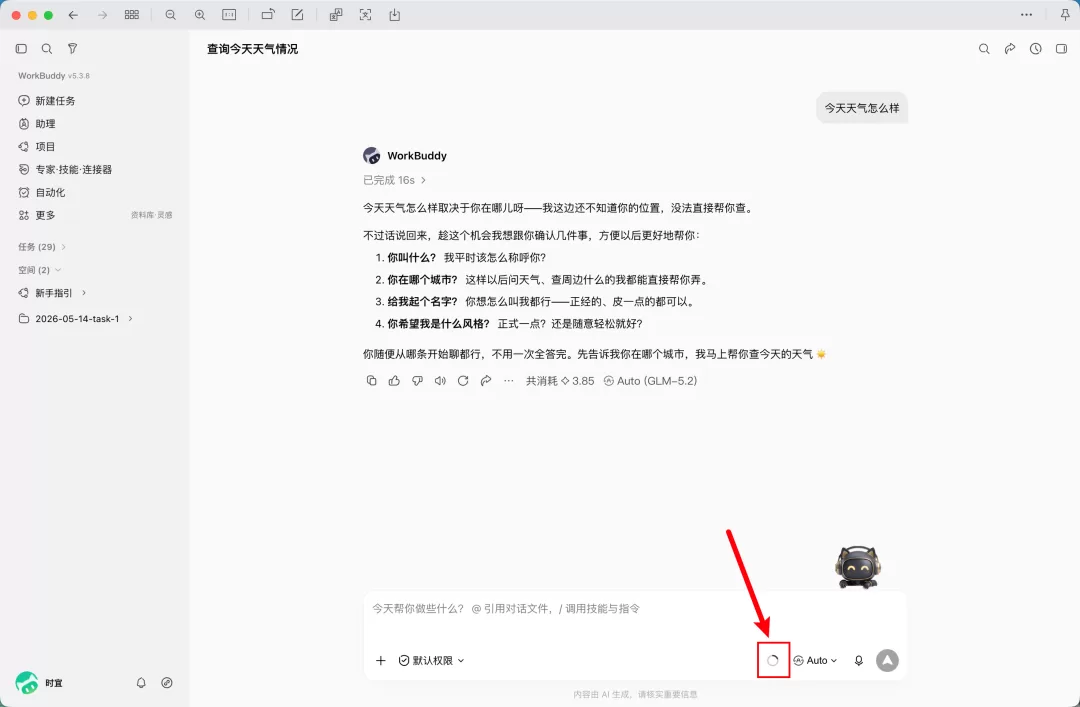
上下文圈圈的位置:对话框右下角
点开后,你会看到当前会话的上下文用量,包括:
• 当前上下文的使用比例;
• 已使用量和模型窗口上限;
• 系统提示词占用;
• 工具及子智能体占用;
• 对话消息占用;
• 连接器、 MCP 及技能占用;
例如,页面显示“4.9% · 49.4K/1000K”,意味着当前会话已经使用约 49.4K token,模型的上下文窗口上限为 1000K。
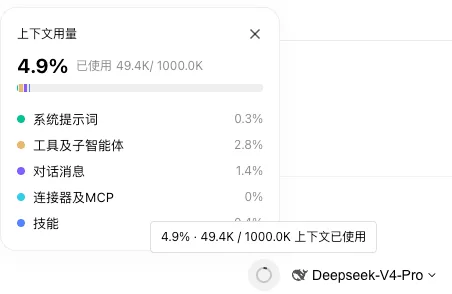
Anne 在直播中给的建议:"模型最好的状态是圈圈用量在一半左右。"
超过一半,就该考虑压缩上下文或新开任务。
技巧 2 · “增强提示词”功能
> Q:一个清晰、无干扰且节省 token 的提示词应该怎么写?哪些可能是属于废话会消耗 token 的?
对话框右下角的小闪光图标,是 WorkBuddy 的“增强提示词”功能。
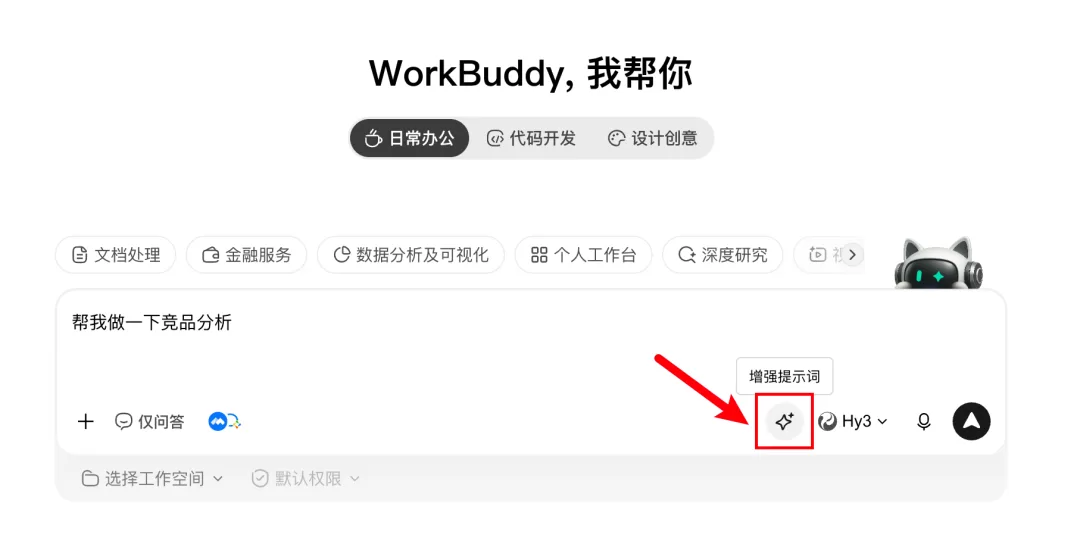
作用很直接:如果你担心指令写不清楚、有废话、有歧义,可以让 AI 帮你改写一遍。真的觉得写不清楚?直接点"增强提示词",AI 会把你的原始诉求改写得更干净、更聚焦、更少废话。这条技巧让你从纠结遣词造句里解脱出来,把注意力放回真正重要的事上:你要 AI 帮你完成什么。
技巧 3 · 只是讨论思路,就切到“仅问答模式”
> Q:我只是想跟 AI 聊聊思路,它会直接改我的文件
有时候你并不准备让 Agent 立刻修改文件或执行任务,只是想先聊一聊思路。
这时可以打开“仅问答模式”。
Plan 模式和仅问答模式——都在对话框「+」旁边的模式入口里。
仅问答 Ask 开关:适合问问题、找思路,无法做执行
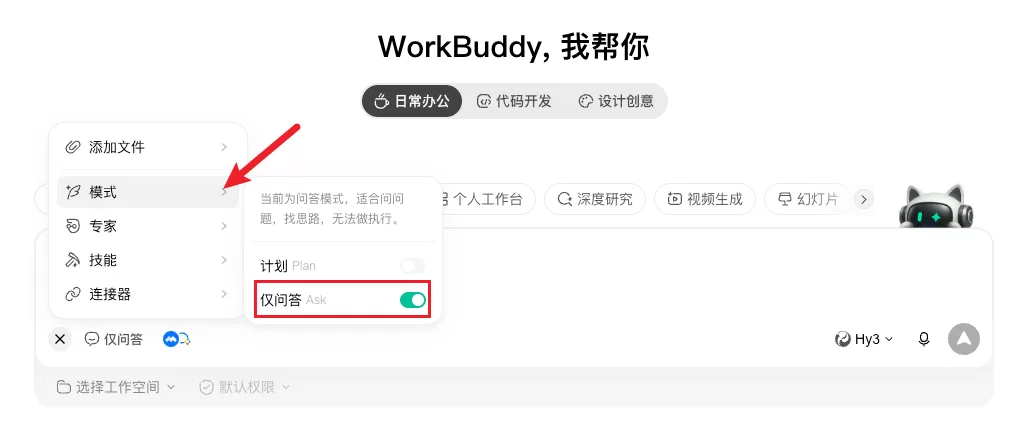
仅问答模式不会加载部分执行和编辑相关的工具,因此可以减少工具定义带来的固定上下文开销,也能让模型更专注于分析和讨论。
适合使用的场景包括:
• 梳理选题;
• 讨论方案;
• 分析问题;
• 找灵感;
• 在正式执行前明确需求。
技巧 4 · 别装太多技能,每个都在悄悄吃你的上下文
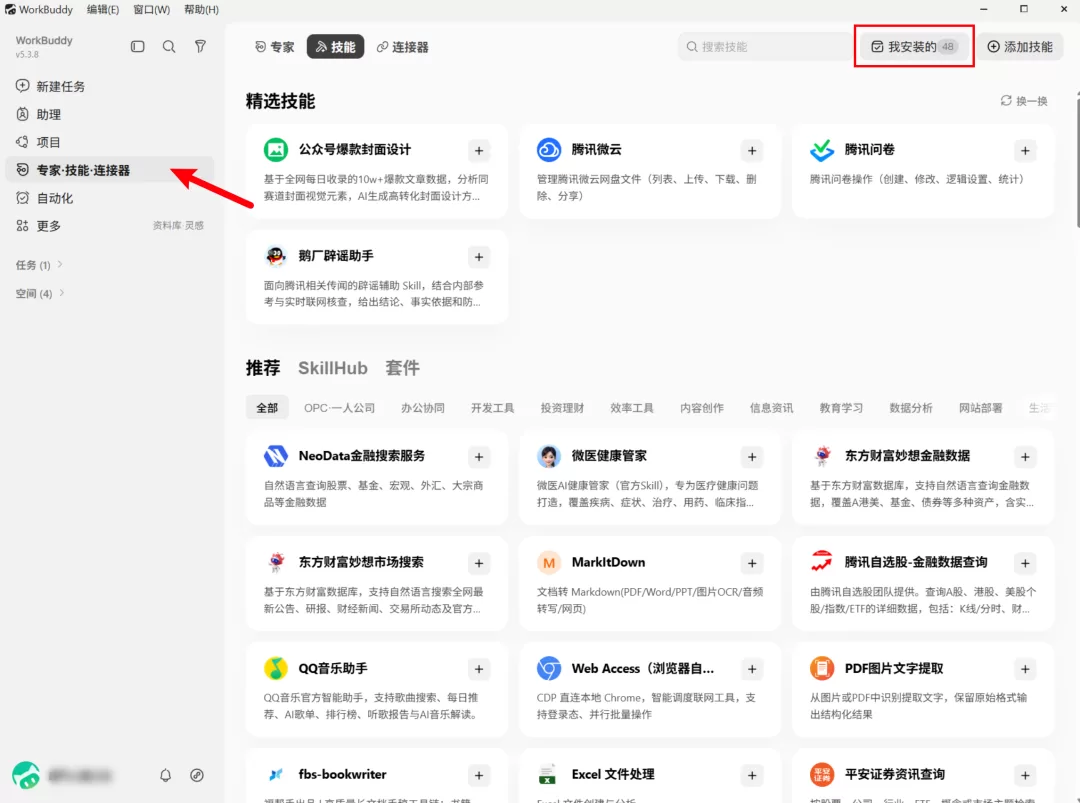
Q:技能库里有很多技能,几个功能相似的技能应该怎么选?Anne 在直播中建议:"把长期用不到的技能先关掉,需要时再打开。"背后的机制是——每个技能的定义本身,都要被发给模型看。模型要理解你装了什么技能、每个技能干什么、什么时候该调用。技能装得越多,光是"介绍这些技能"这件事就要吃掉一大块窗口。而且技能越多,模型判断"这次任务该用哪个"的干扰也越大。它可能选错,也可能纠结。实用做法:- 打开技能管理页,把长期不用的技能关掉(不用删,关掉即可)
• 只保留你当前工作场景真正需要的
• 需要用的时候再打开——技能是可以随时开关的
技巧 5: Max 模式
> Q:Max 模式到底是干嘛的?开着好还是关着好?
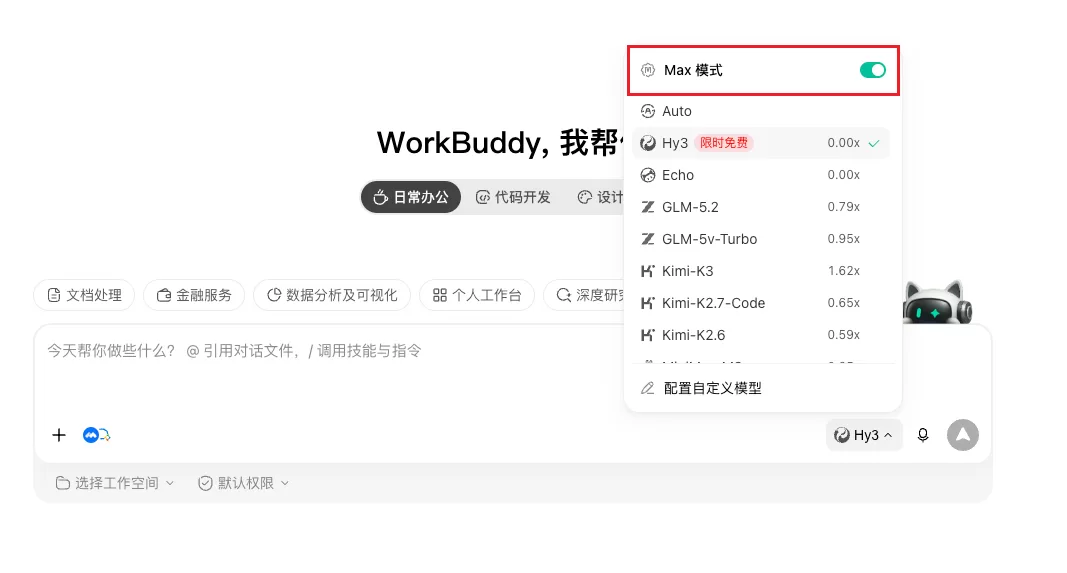
Max 模式开关在模型选择下拉的顶部- 打开 Max:不压缩,保留完整上下文,适合需要长期记忆的复杂任务。
• 关闭 Max:WorkBuddy 会在某个时机自动帮你压缩上下文,降低窗口使用
如果任务需要频繁引用之前的讨论、文件状态和复杂约束,打开 Max 可以保留更多信息,但可能增加积分消耗。
如果任务相对独立,或者已经积累了大量不再重要的讨论,关闭 Max 通常更合适。
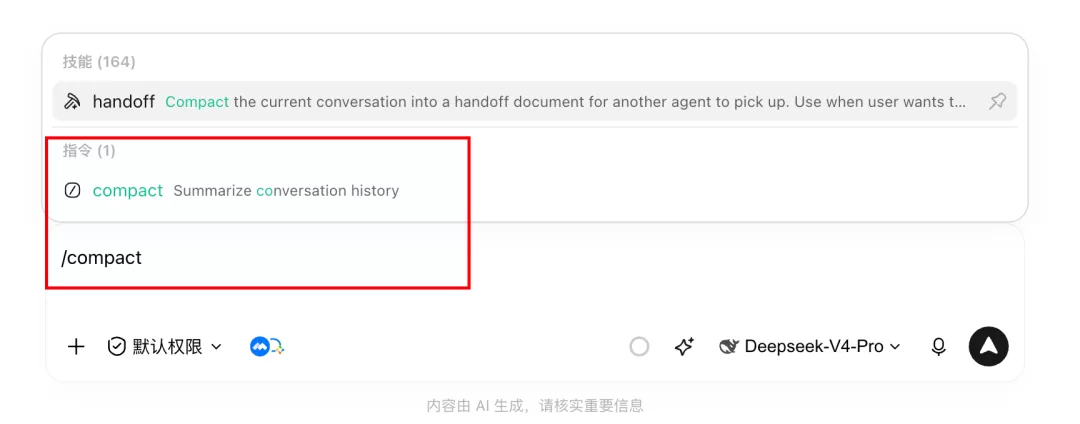
技巧 6 · /compact :一条指令手动压缩上下文
> Q:对话太长,Agent 开始变慢、遗漏要求,又不想开新会话,怎么办?
有时候会遇到这种情况:任务还没跑完,但对话已经很长,模型开始变慢或变笨。
可以不用新开会话,直接在对话框里发一条斜杠指令:/compact
WorkBuddy 会把当前上下文交给模型进行主动压缩——总结前面聊过的内容、替换掉原始对话记录、腾出窗口继续跑。
压缩通常比等到窗口接近上限后被动裁剪更可控,但压缩并不是完全无损的。部分细节、特殊约束和中间状态,仍然可能在总结过程中被弱化。
因此,复杂任务在压缩前,最好先让 Agent 整理一份“任务检查点”,包括:
• 当前目标;
• 已经完成的内容;
• 重要约束;
• 修改过的文件;
• 尚未解决的问题;
• 下一步动作。
如果这些信息很重要,还可以让 Agent 把它们写入工作空间里的文件,再执行 /compact。
这样即使摘要遗漏了部分细节,新一轮上下文也可以重新读取任务状态。
技巧 7 · 一个会话里,尽量别频繁切换模型
> Q:一个对话框可以频繁切换模型吗?想针对不同的内容切换低 token 或高token的模型进行输出。
这是很多人踩过坑但没意识到的反常识点。
同一对话里频繁切换模型,性能会下降,还可能造成信息丢失。
原因有两个:
一是提示词缓存。 模型可能会缓存之前处理过的部分内容,从而降低重复处理成本。但缓存通常与具体模型及服务机制有关。切换模型后,原有缓存不一定能够继续复用。
二是上下文窗口不同。不同模型支持的上下文长度并不一致。例如,你已经在一个较大窗口的模型中积累了大量内容,再切换到窗口更小的模型,就可能触发压缩或裁剪。
推荐做法:
• 同一任务尽量用同一个模型跑完
• 一定要切模型?先 /compact 压缩一遍再切,成本消耗会降低
• 想尝试不同模型的效果?在同一工作空间开新的会话,别在原会话里切
技巧 8 · 什么时候该开新会话,什么时候留在原会话
> Q:一个任务跑了很多轮的对话,token 会消耗越来越多。有没有说超过多少轮,就建议起一个新的对话?
Anne 给了两条清晰的判断标准:
该开新会话的信号:
• 上下文圈圈快满了(比如显示 900K/1000K)
• 模型陷入某种循环,反复出错、任务再也完不成
• 两件事之间没有关联——比如刚刚在做调研,突然想聊环境保护,直接开新会话
留在原会话的信号:
• 同一个任务的连续追问
• 前面的历史文件、状态需要延续
有一个前提要记住:新会话最好开在同一个工作空间里。这样仍然可以读取项目文件和背景资料,相当于“工作台没变,但给任务换了一个更清醒的脑子”。
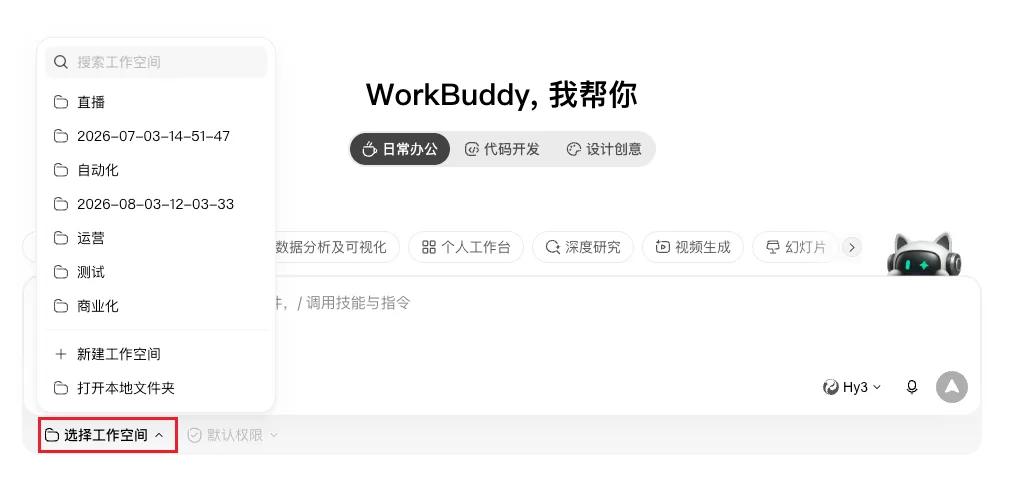
对话框左下角的「选择工作空间」下拉,能切换到任意已有空间
技巧 9:分清“记忆”和“个性化”
> Q:设置里的"记忆"和"个性化"有什么区别?
WorkBuddy 设置中有两个容易混淆的入口:记忆和个性化。
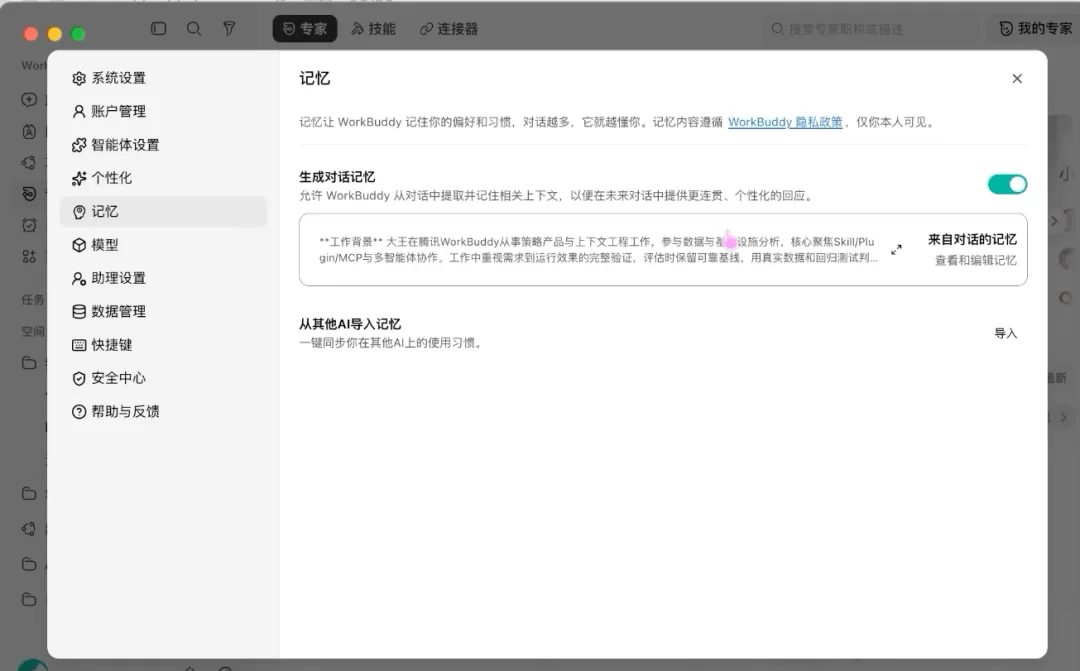
记忆是 WorkBuddy 从历史互动中积累的信息,例如你的专业背景、工作习惯和表达偏好。
个性化是你主动设置的内容,例如称呼、语气、人设和性格。
设置 → 记忆
这里存的是 WorkBuddy 自动帮你提取的长期偏好。
Anne 提到, WorkBuddy 每天晚上会从你当天的对话历史里提取有价值的信息,进入你的个人记忆库——比如"用户熟悉上下文工程""用户表达偏好总分总结论"这一类。你不用手动做任何事,它自己在攒。
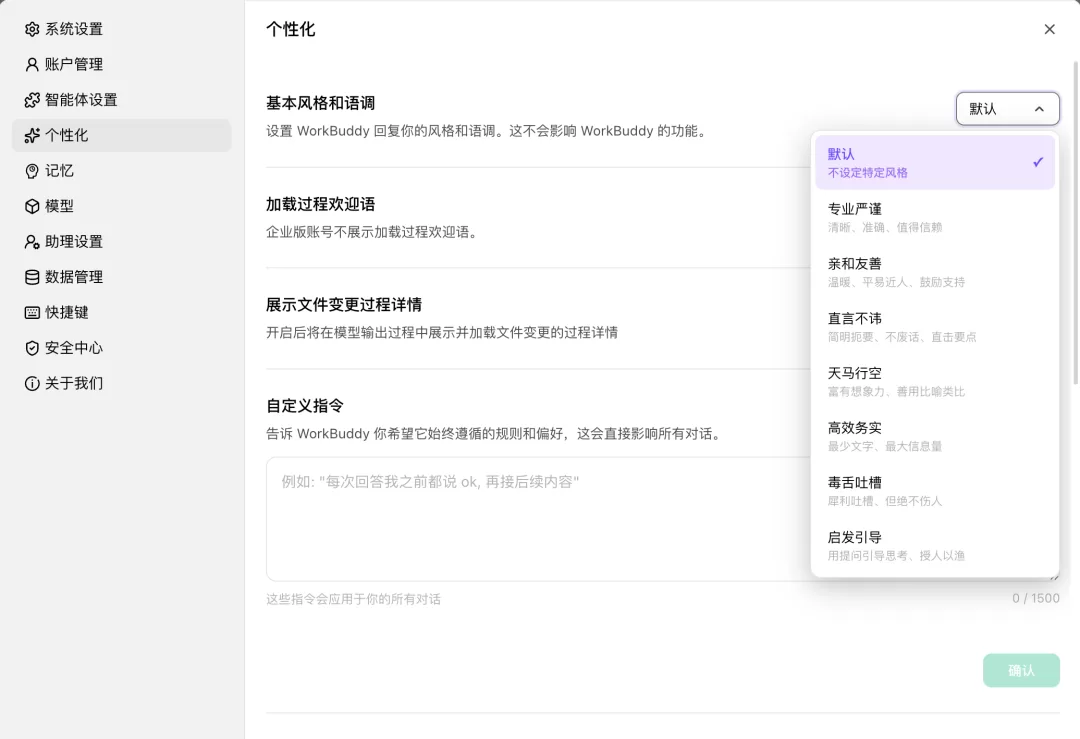
设置 → 个性化
这里存的是你手动指定的东西——
• 选择回复风格和语调,例如专业严谨、亲和友善、直言不讳或高效务实;
• 设置是否显示加载过程欢迎语;
• 设置是否展示文件变更的过程详情;
• 添加应用于所有对话的自定义指令。
一个是自动攒的画像,一个是手动设的偏好。搞混了会用得很别扭。
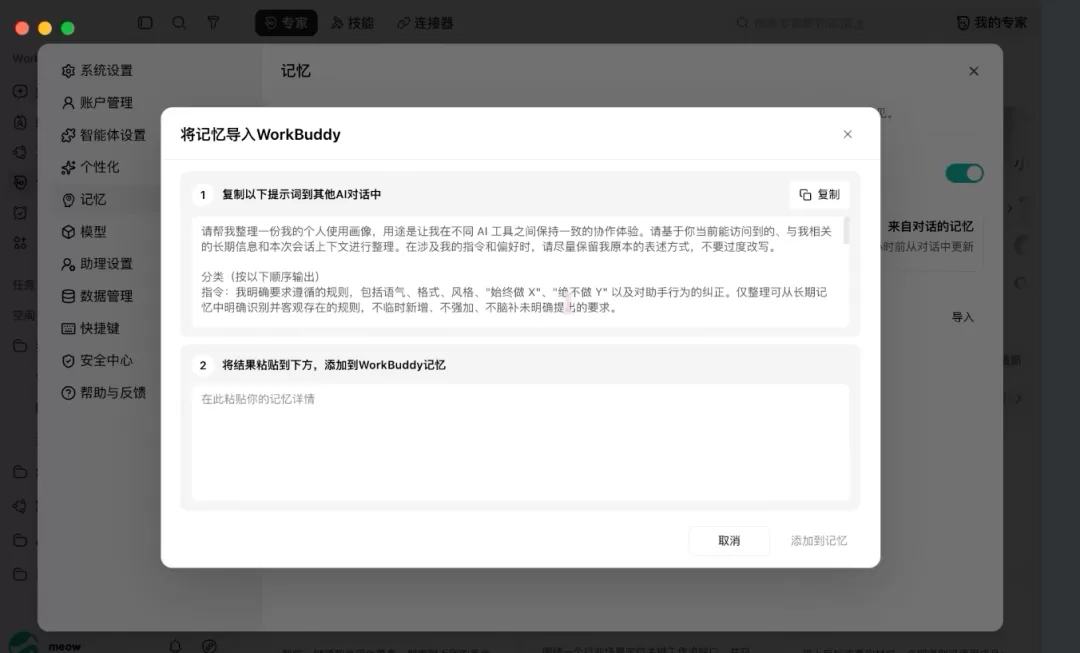
技巧 10:把其他 AI 产品的记忆迁移进来
> Q:以前在其他 AI 里积累的偏好,可以迁移到 WorkBuddy 吗?
如果你长期使用其他 AI 产品,不必在 WorkBuddy 里从头建立个人偏好。
复制 WorkBuddy 提供的迁移提示词,让原来的 AI 整理一份“关于你的记忆总结”,检查无误后,再导入 WorkBuddy 即可。
原本需要长期磨合的用户画像,可以通过两次复制粘贴完成初步迁移。
WorkBuddy:https://www.workbuddy.ai