Anthropic 正式发布 Claude Sonnet 5.5,这是 Claude 5.5 家族的第二个模型,定位为 Opus 5.5 的低成本、高速度搭档。速度比 Sonnet 5 快 30% 以上,大部分工作的成本最多降低 30%。
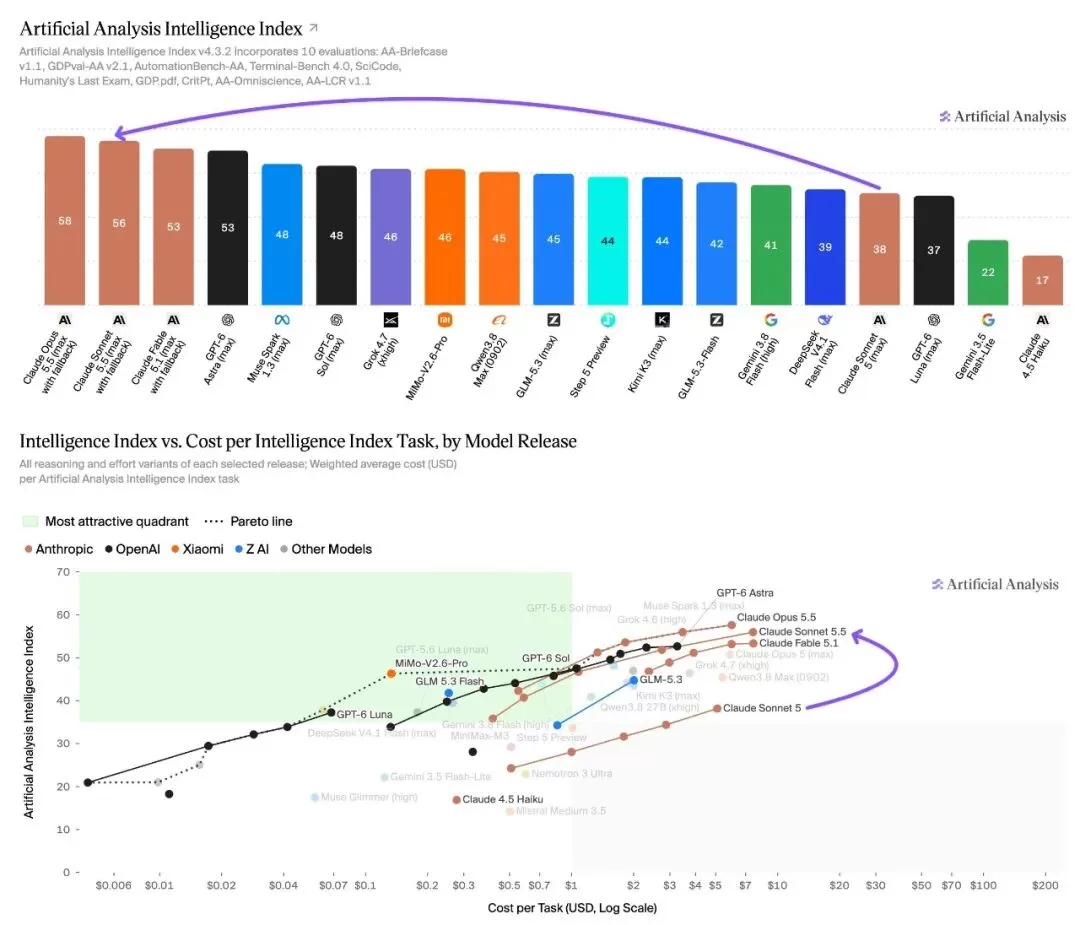
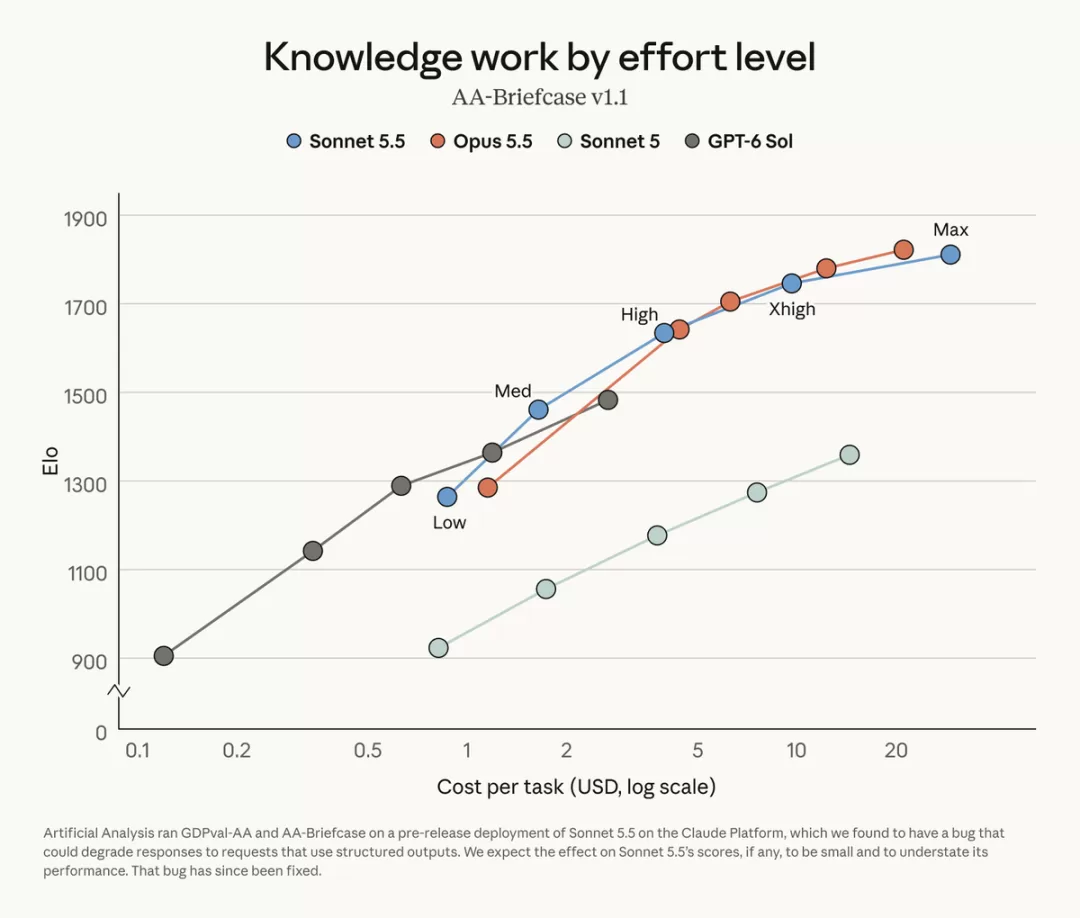
Sonnet 5.5 擅长边界清晰的日常任务、修 bug,以及制作文档、幻灯片和电子表格。在设计审美和品味上接近 Opus 5.5,相比 Sonnet 5 有巨大提升。第三方 Artificial Analysis 测试中,Max 档位直接超越 Fable 5.1 和 GPT-6 Astra。
Claude Haiku 5.5 面向大批量、成本敏感的应用,将在未来几周加入该家族。
性能表现
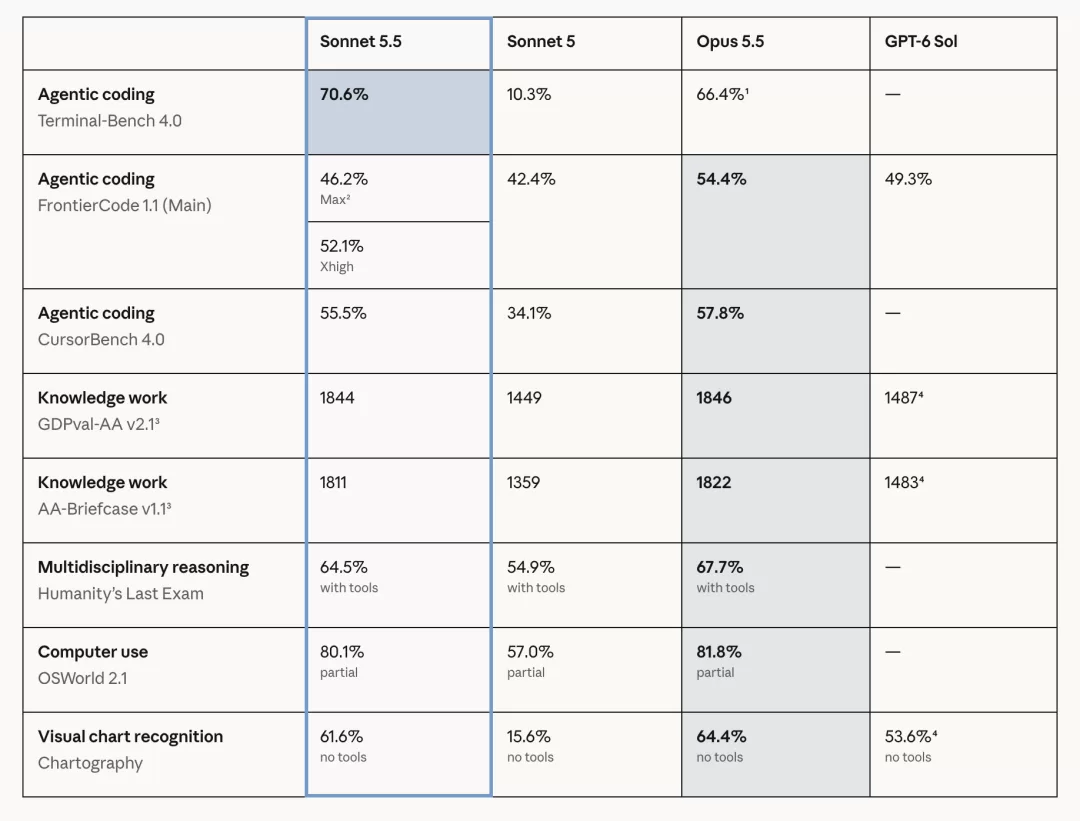
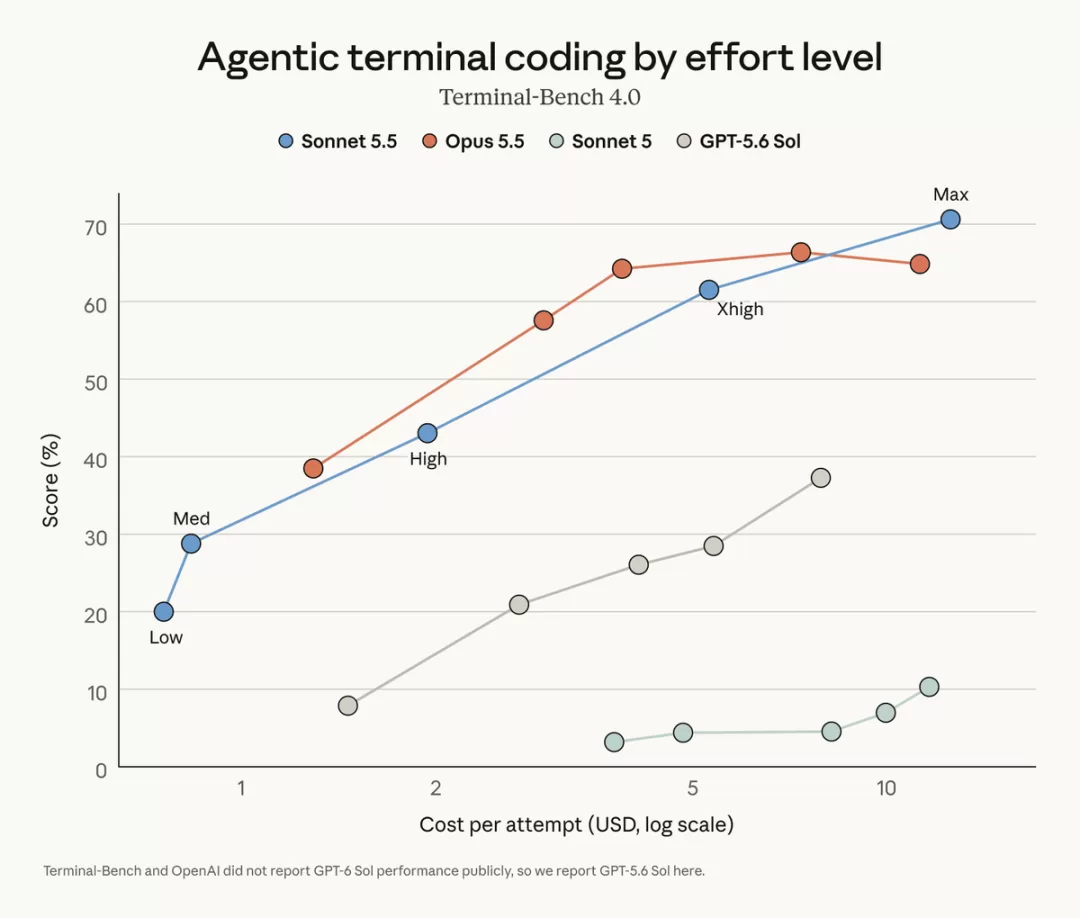
Sonnet 5.5 在 Terminal-Bench 4.0(智能体编程评测)上得分 70.6%,远超 Sonnet 5 的 10.3%。它在长程任务和图像理解上表现也不错,是第一个只看截图就通关《宝可梦 红》的 Sonnet 模型。
在若干评测中,Max 强度下的 Sonnet 5.5 表现与 Opus 5.5 相当。不过官方指出,面对需要持续判断的复杂开放式工作,Opus 5.5 依然明显更强。
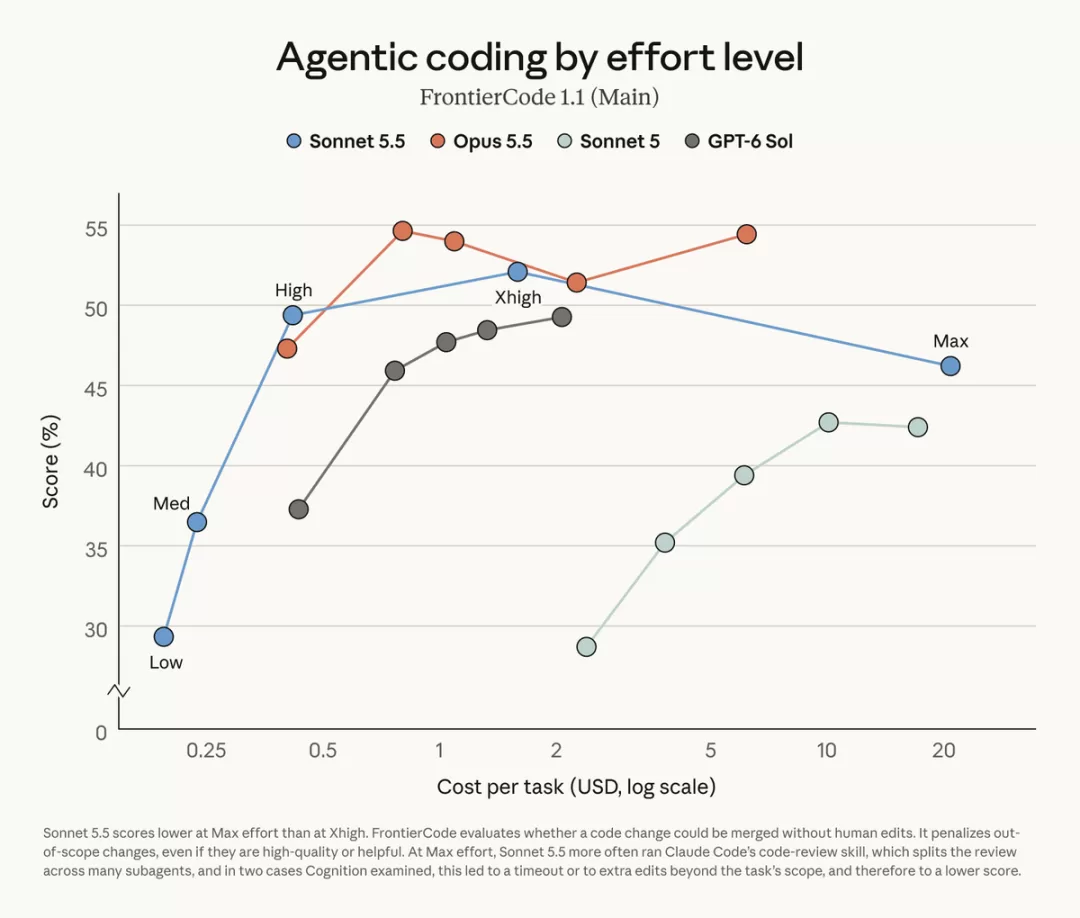
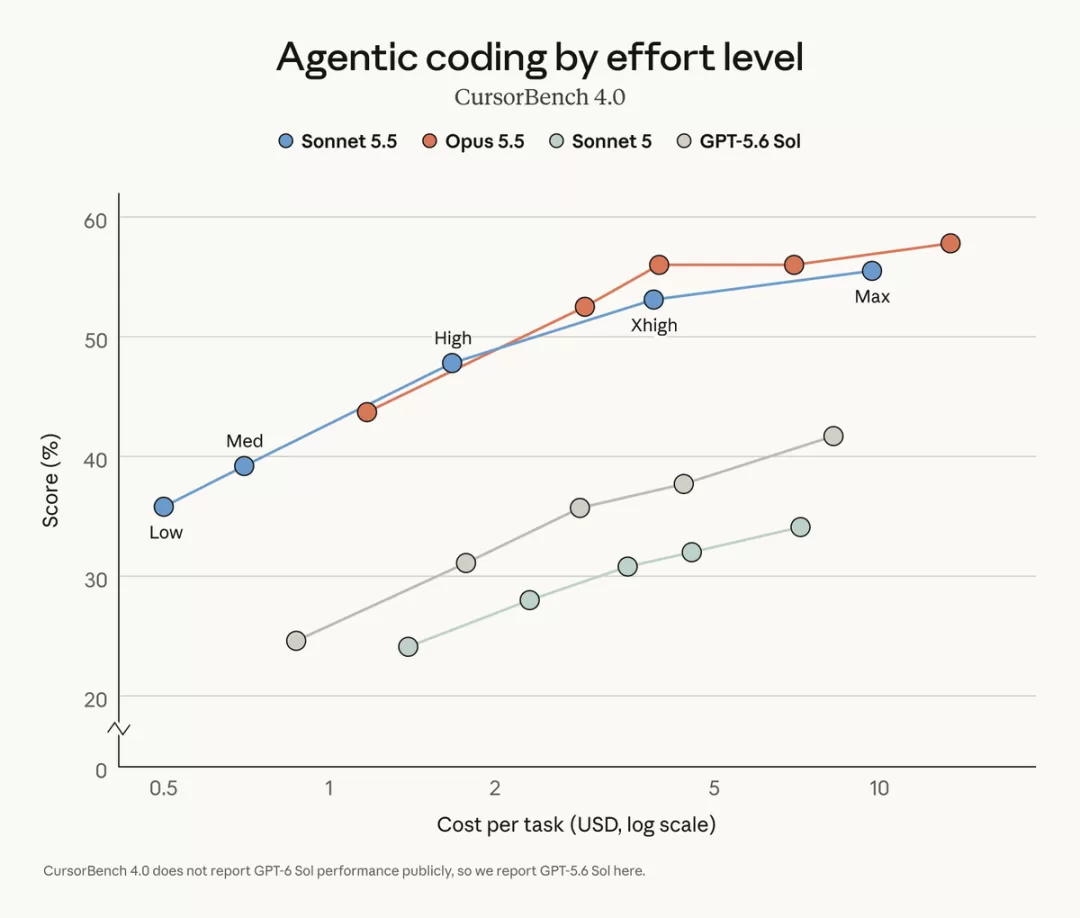
官方用图表展示了每个模型在各个强度档位下的得分和单任务成本。强度调高,模型工作更久、成本更高、分数也更高。点越靠近左上角,每一美元换来的能力越多。
在多项基准上,Sonnet 5.5 在 Low 或 Medium 强度下就超过了 Sonnet 5 的最高分,单任务成本仅为后者的十分之一左右。它和 Opus 5.5 搭配最合适的是低强度档位(成本更低),在更高档位两者表现相当、成本相近。
编程能力
Sonnet 5.5 在编程上的进步最为明显。在 FrontierCode 上,High 强度下比同档位 Sonnet 5 高 10 分,单任务成本约为后者的十五分之一。
CursorBench 测试 Cursor 真实编程会话中的任务,Sonnet 5.5 的最佳成绩与 Opus 5.5 相差约两分。在正面对比中,它比 Sonnet 5 更常合并多个工具调用,步骤更少,成本更低。
知识工作
GDPval-AA 测试模型在 9 个主要行业、44 种职业中的真实任务表现。Sonnet 5.5 在此项评测中展现出强大的通用能力。
总体来看,Claude Sonnet 5.5 以 Opus 5.5 的低成本搭档定位,在大部分日常任务和编程场景中提供了接近旗舰的性能表现。对于需要大量调用的用户来说,Sonnet 5.5 的性价比极具吸引力。