对于微信来说,最难的问题是什么?可能有人觉得是在 AI 时代,微信的 AI 化。比如大家寄予厚望的微信 AI 小微,到现在还在内测。
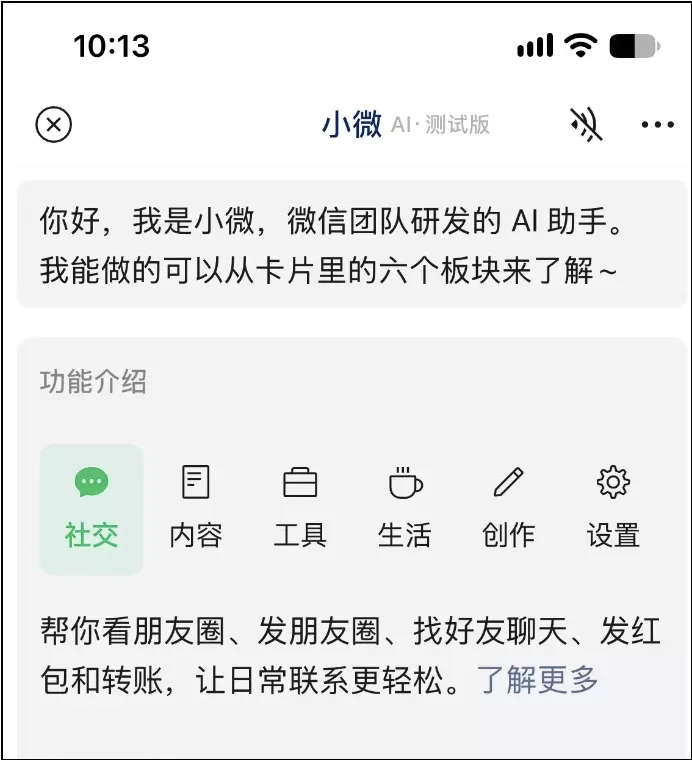
这个用户体量最大、功能最复杂的应用要进行 AI 化,几乎所有微信业务都需要融入 AI 助手小微,历史包袱很重、兼容性很多。这确实很难,但整体来说还是属于自主可控、可支配的。
我个人觉得,微信最新上线的一个功能「方言转文字」,可以说是最难啃的一个骨头。
方言转文字不在于功能复杂度,而在于分散、多样、不可控的方言要准确地识别出来。这太难了。为何这么说,看到后面就会知道。目前这个功能最近在灰度测试中,先来实操体验下。
一、方言转文字功能
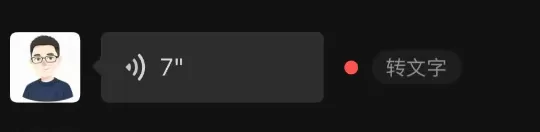
之前,在收到用户发的语音后,会出现「转文字」按钮。
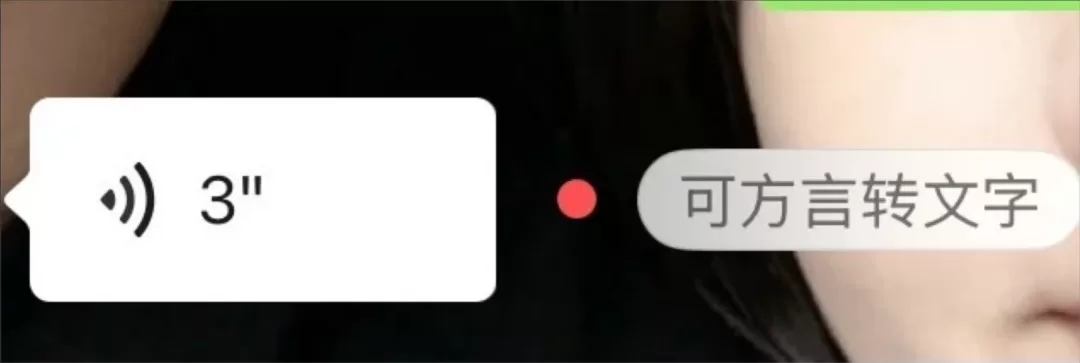
现在,微信如果识别到收到的语音是方言,后面会出现「可方言转文字」。
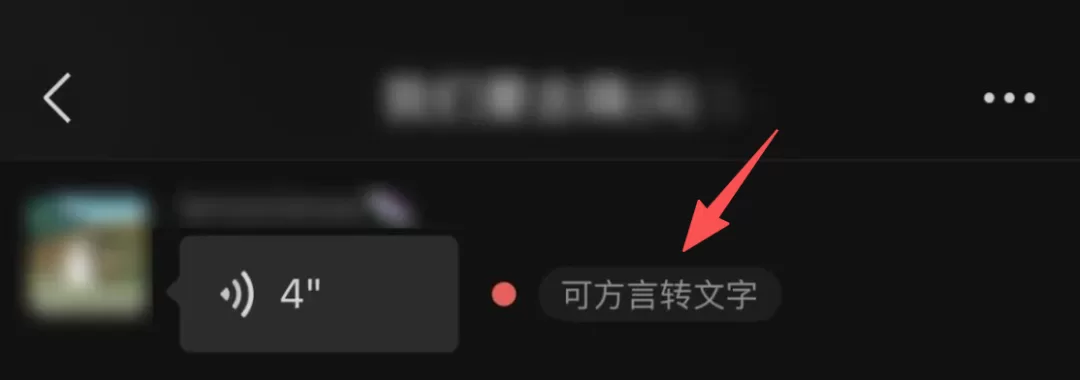
点击可将方言转成文字呈现。如果你觉得翻译的文字不准确,可以点击后面的「帮助改进」按钮进行纠正。
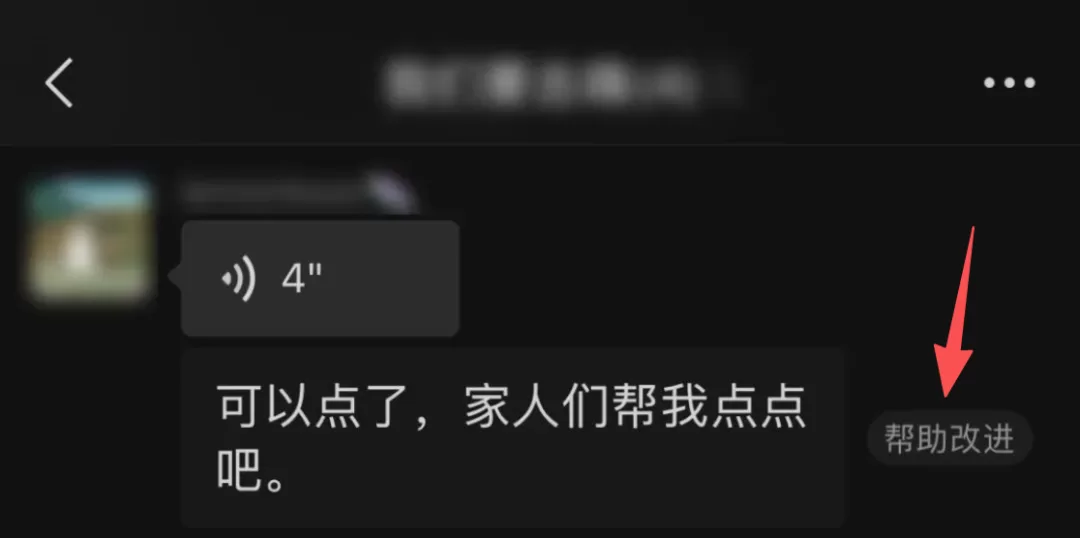
点击「帮助改进」会进入改进页面,可编辑、纠正转成的文字进行提交。
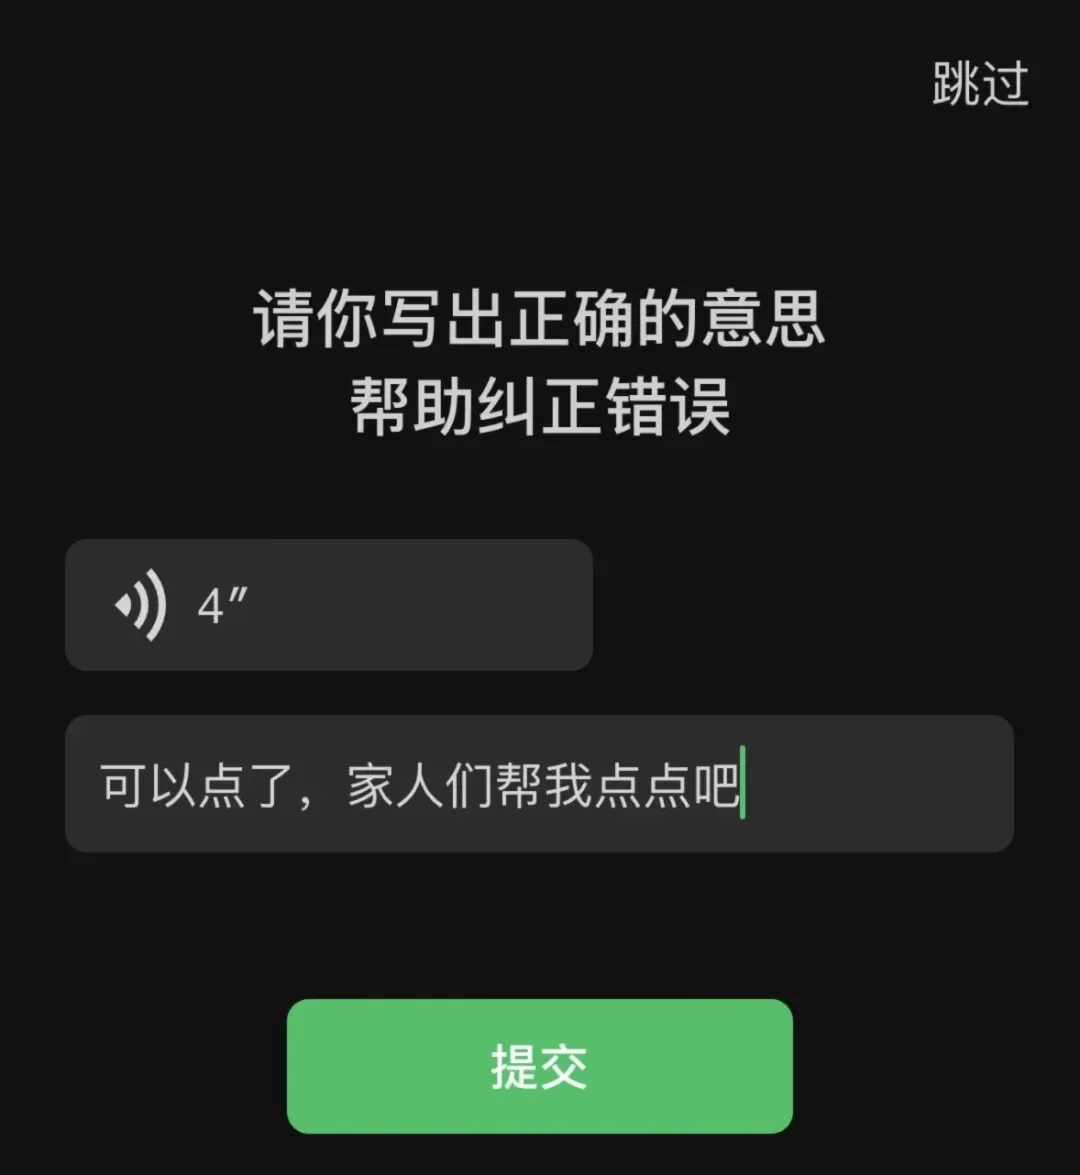
这样微信通过用户反馈行为来帮助微信读懂、准确转译方言。或者说,通过「帮助改进方言」来训练模型,提升方言转译成文字的准确率。
二、方言采集活动
在之前很长一段时间,微信一直在分批邀请用户参与方言采集活动。
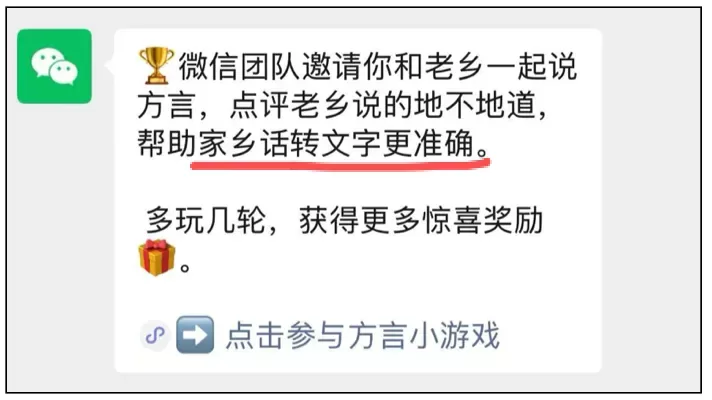
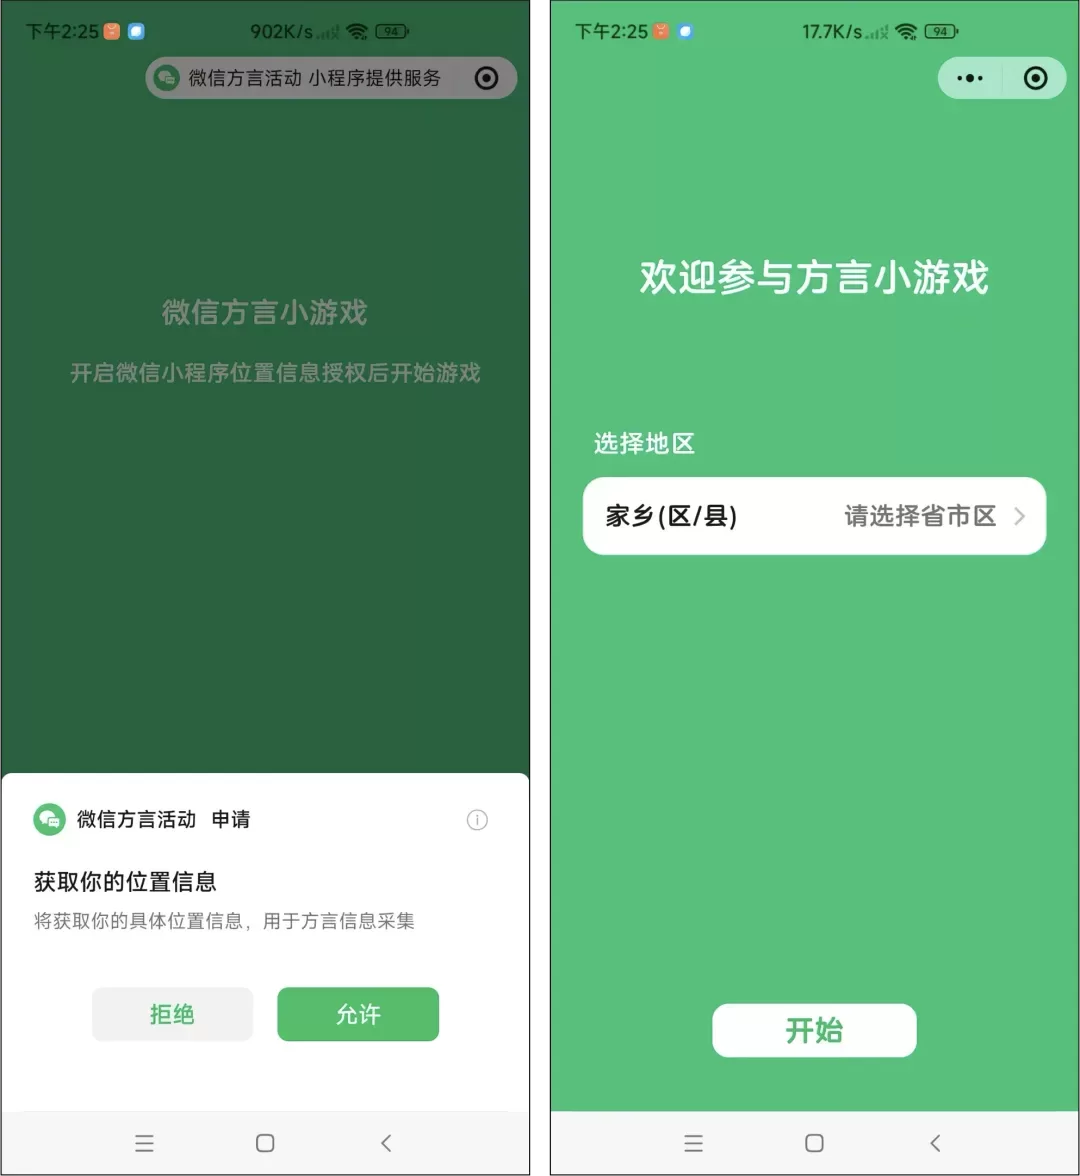
通过「微信方言活动」小程序来承载方言样本收集。
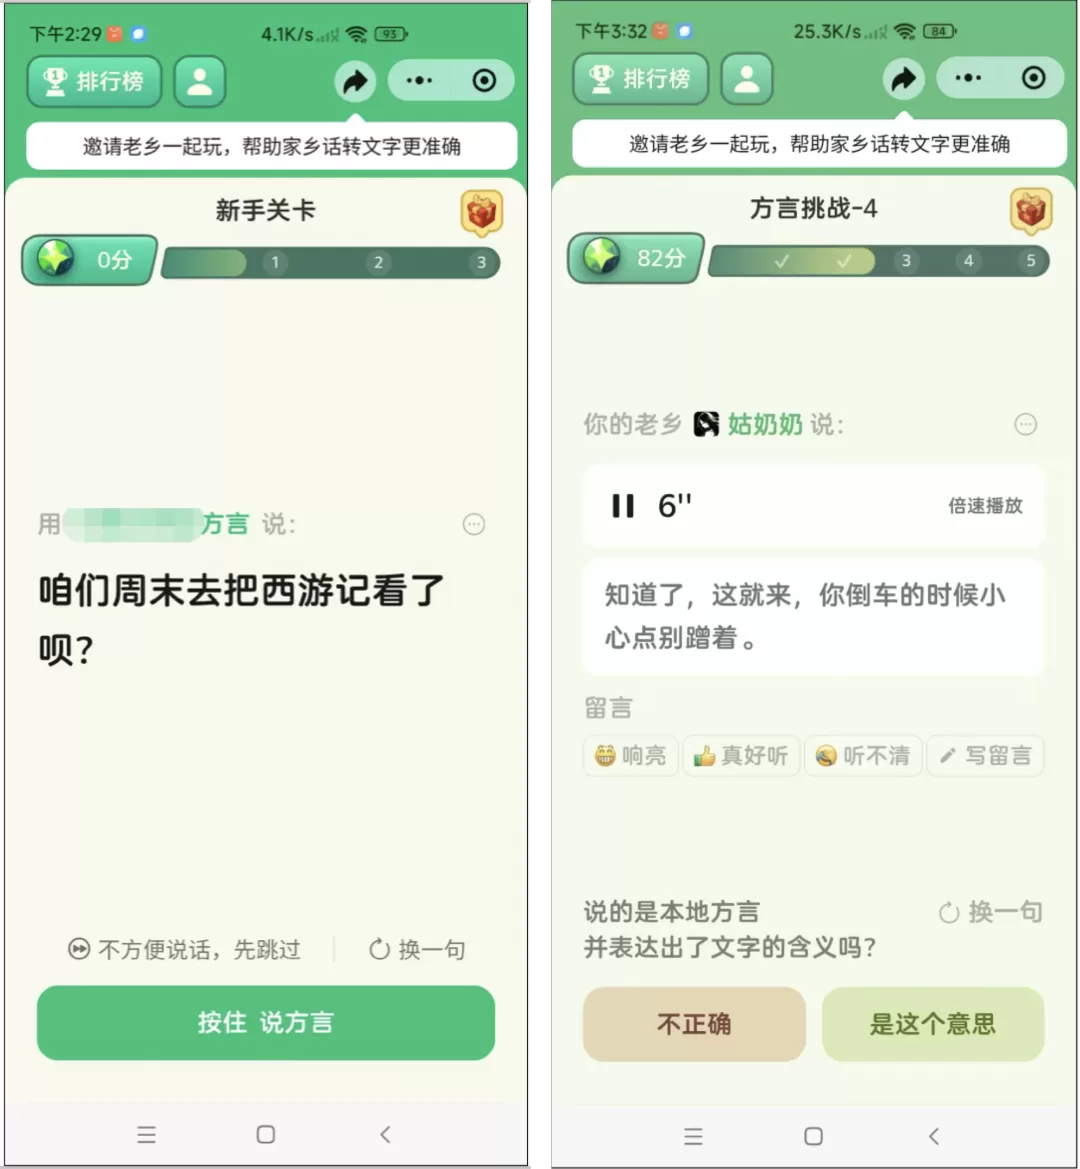
既可以说方言也可以点评方言。说方言是收集样本,点评方言是标注数据。
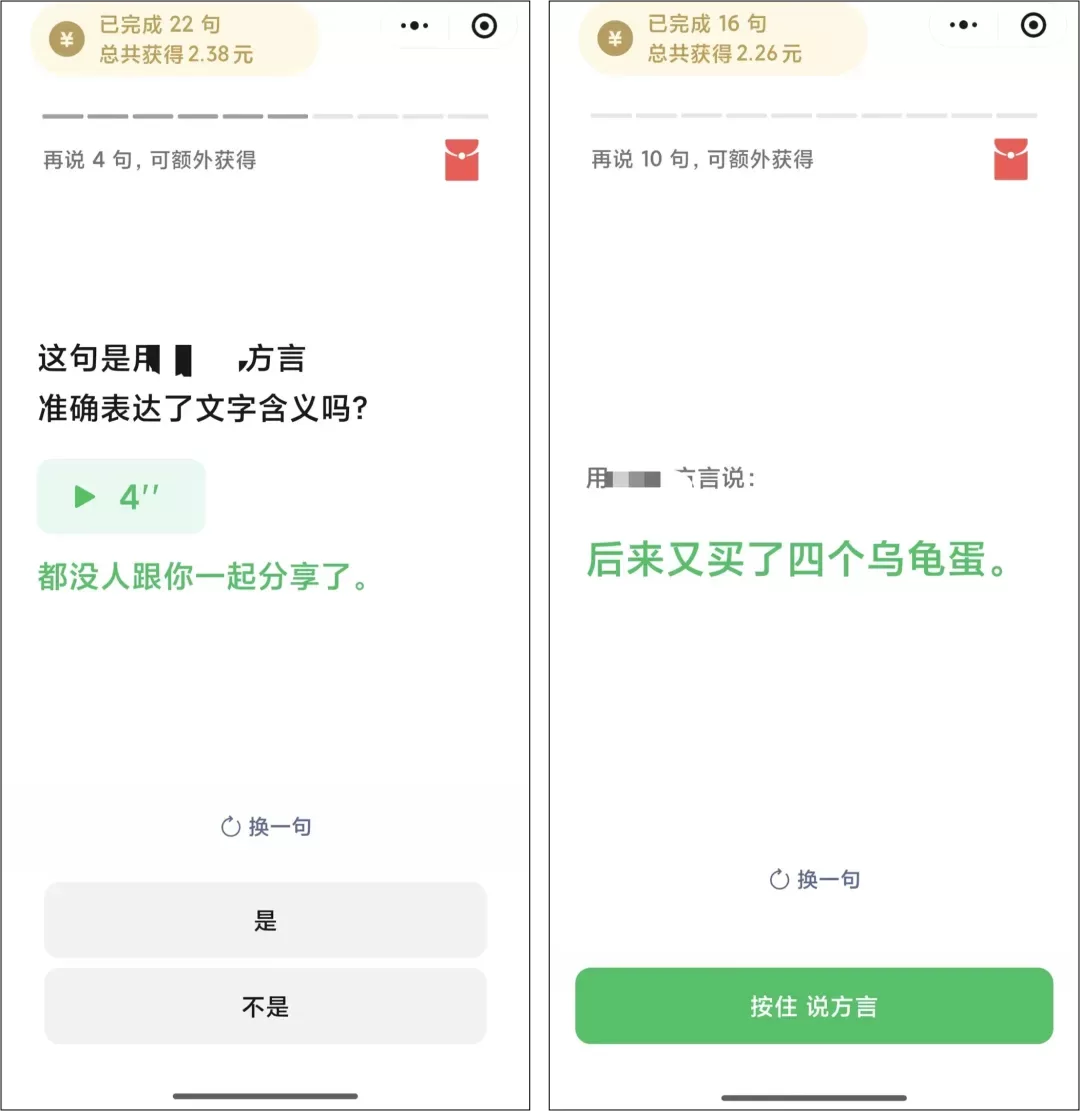
为了鼓励用户说方言、点评方言,微信一度还给出了不少的现金红包奖励,曾一度掀起邀好友说方言热潮。
三、为何要采集方言
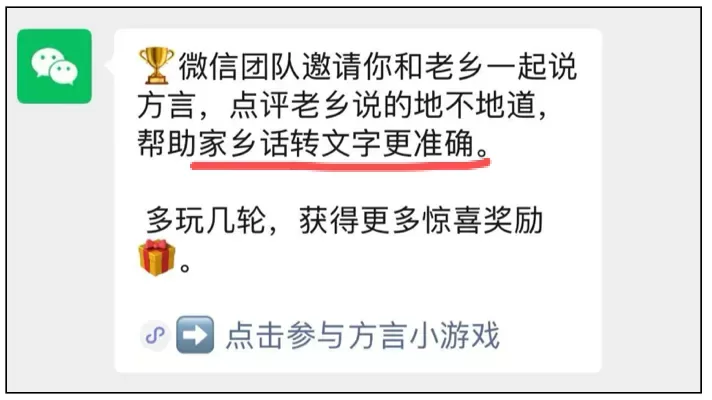
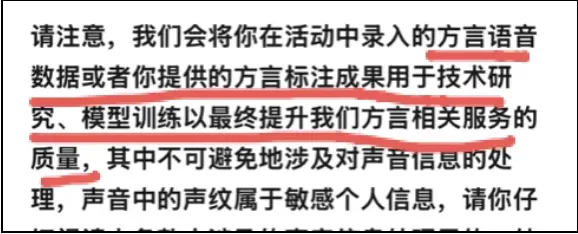
从邀请说明和隐私协议中可以看到,收集和标注的方言数据信息用来模型训练,提高方言转成文字的准确性。
因为微信经常收到用户反馈方言转文字不准确,用户希望微信官方尽快完善。这种需求非常普遍、非常大。
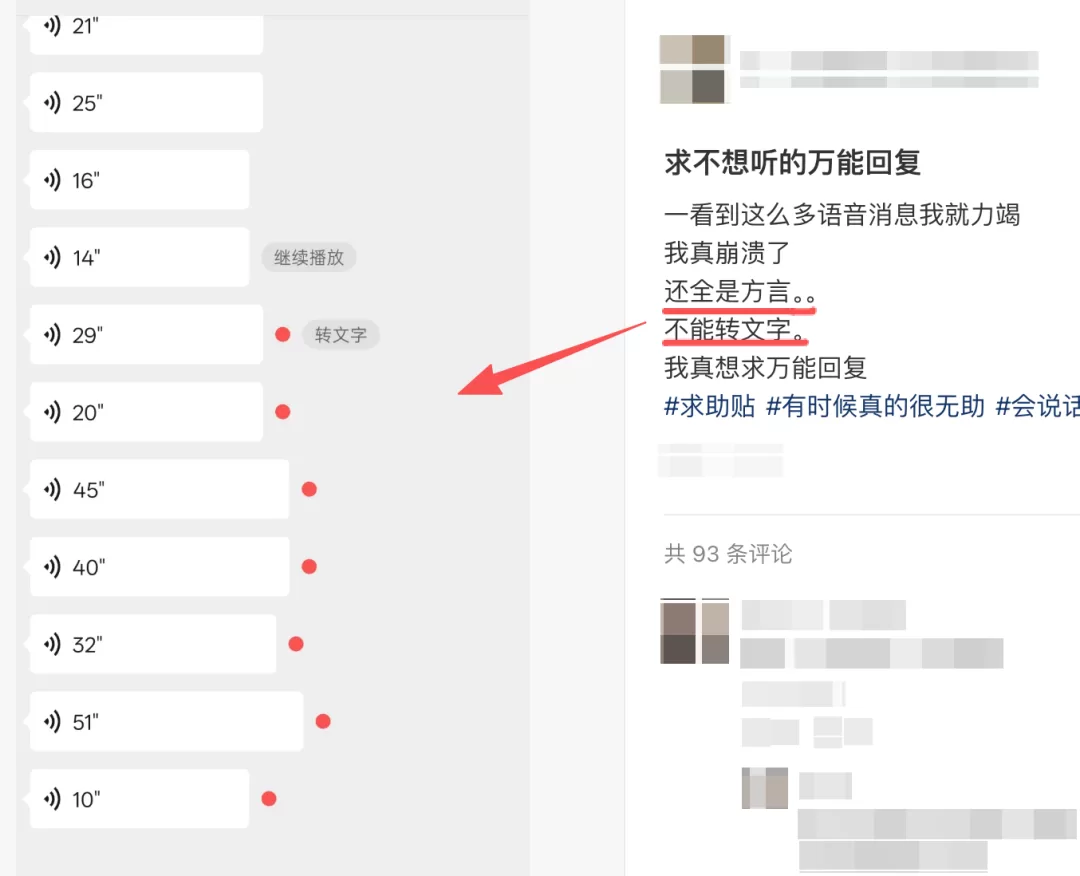
和其他软件不同,其他软件就算提供方言转文字也只提供有限的几种或最多十多种的热门方言。而微信要做的是支持全国所有方言转文字。
因为微信基本属于全民应用,每个人都可用普通话或家乡方言发送语音进行交流。只要有语音就有转文字的需求。
如果以县级行政区为单位统计方言种类的话,全国有超过 2800 个县级行政区,有 2800 多种方言要支持转文字。大量的方言处于缺语料、缺标注、要补齐基础数据的阶段。
这属于又脏又累、费力不讨好的事情。这也是为何方言转文字是最难啃的骨头了。但是用户需求一直在还很强烈。这也是为何微信过去半年一直分批邀请用户参与说方言、参与方言游戏的原因。
哪怕还被各种误解、各种指责。
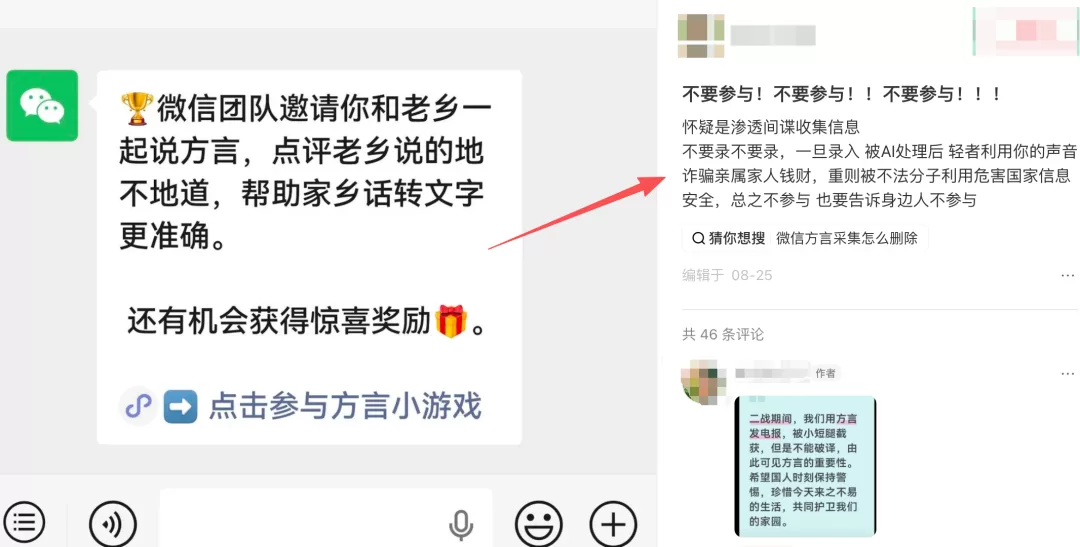
现在很少有平台有耐心做这种地方方言的样本采集然后来提升方言转文字准确率的事。因为太脏太累投入产出比还低,还容易招致误解和攻击。
四、啃下最硬骨头
微信通过定向邀请的方式积累了第一批覆盖全国各地方方言的初始样本数据,为方言转文字提供了一定的基础数据支持。
我老家所在的县是个小县城,全县城也就 50 多万人,但已有超过 5000 人参与方言游戏活动,1% 的渗透率。
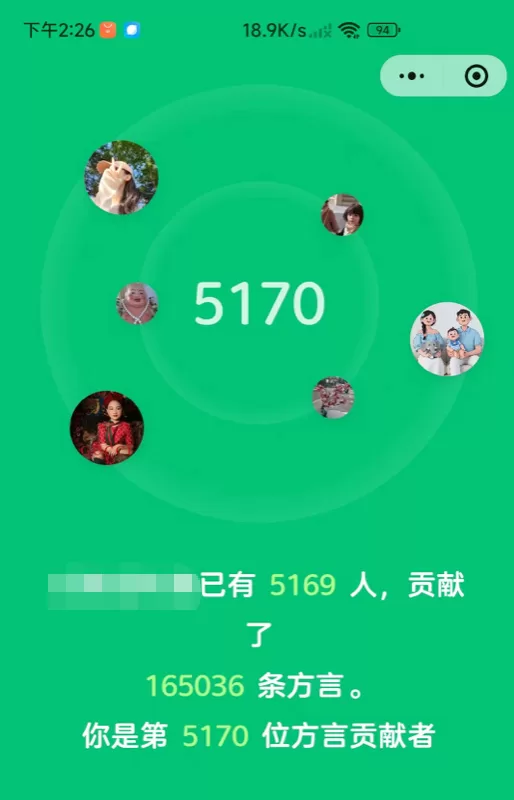
但是还不够。方言种类之多、差异之大、场景之不同,方言之间模型难以共享。十里不同音,百里不同俗。就算是同一个地方,城市口音和乡村口音不同,老派口音和新派口音不同,普通话夹杂程度不同。
虽然看似简单的一个方言转文字功能,但知道这背后的难度了吧。要使得极其分散、种类极多的各地方性方言转文字准确率提升到可接受的范围,还需要更多高质量、被标注的样本。
邀请用户太被动,参与率、转化率也不可控。微信就想了这个招:直接在语音聊天场景中来采集和标注方言数据。
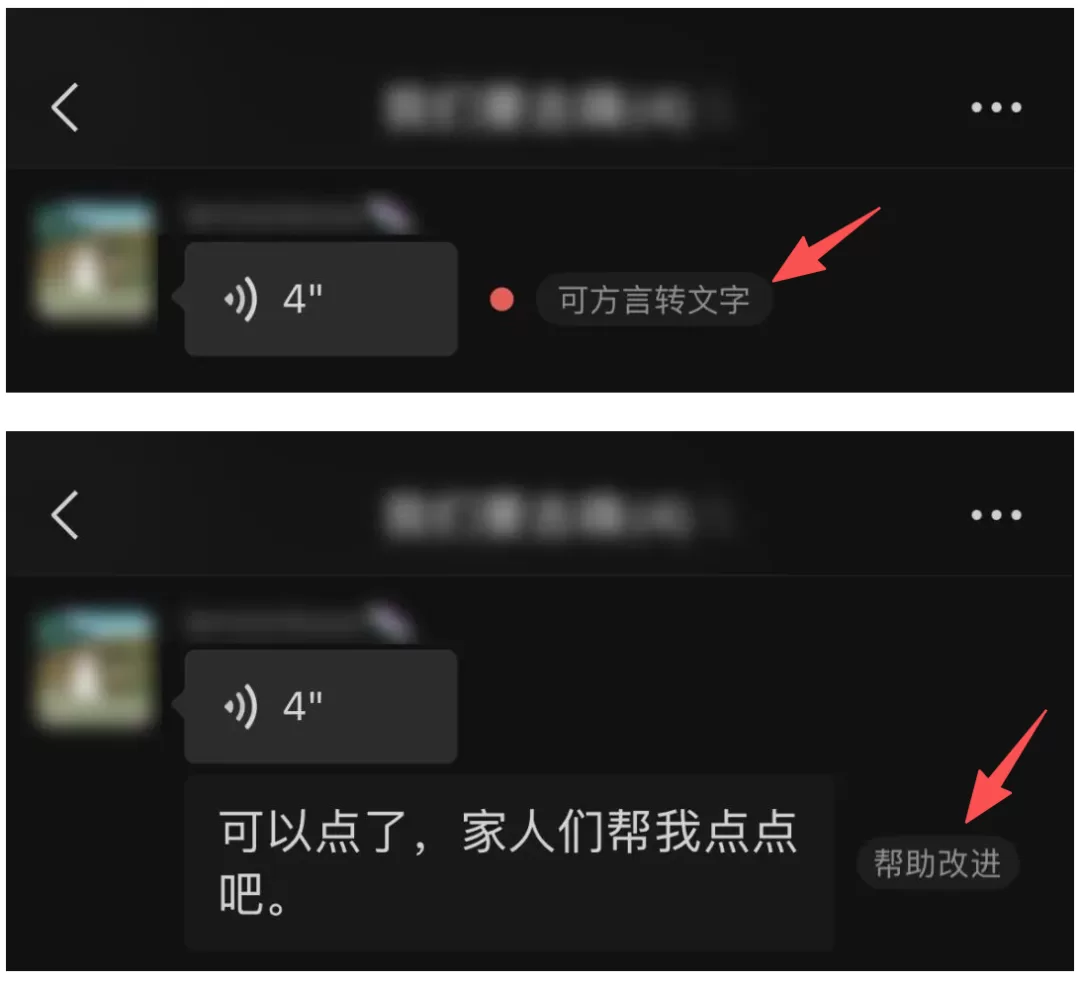
用户不是一直会发方言语音吗?直接告诉你「可方言转文字」,引导用户使用。如果转文字不准确,引导「帮助改进」。
直接把方言数据标注放在聊天流程中,场景中直接触发,高效、转化率高。
不管是邀请用户参与方言游戏,还是聊天主场景植入方言识别、方言改进,微信通过这种众包的力量,以一种相对低成本、广覆盖的方式,收集极其分散、极其多样的方言数据,训练模型来提升微信中方言转文字的准确率。
这是一个一点也不酷、不优雅、很脏、很累的持久战。
为何微信要啃方言转文字这块硬骨头呢?因为聊天、沟通、语音转文字属于微信最基础的 IM 功能,是微信的基础服务和核心。对于基础服务、核心功能,微信从来不含糊。
同时这个最全、覆盖面最广的方言语料库,或许就诞生在微信的语音输入框里。