Seedream 5.5 上线,AI 生图终于从一次性生成进入连续创作阶段。以前大家比较生图模型,基本都是看 OneShot 出来的效果,但在真实创作里,一张满意的图通常只是开始——后面还要换配饰、调光线、处理透明背景,甚至围绕同一个人物继续做一整套系列内容。
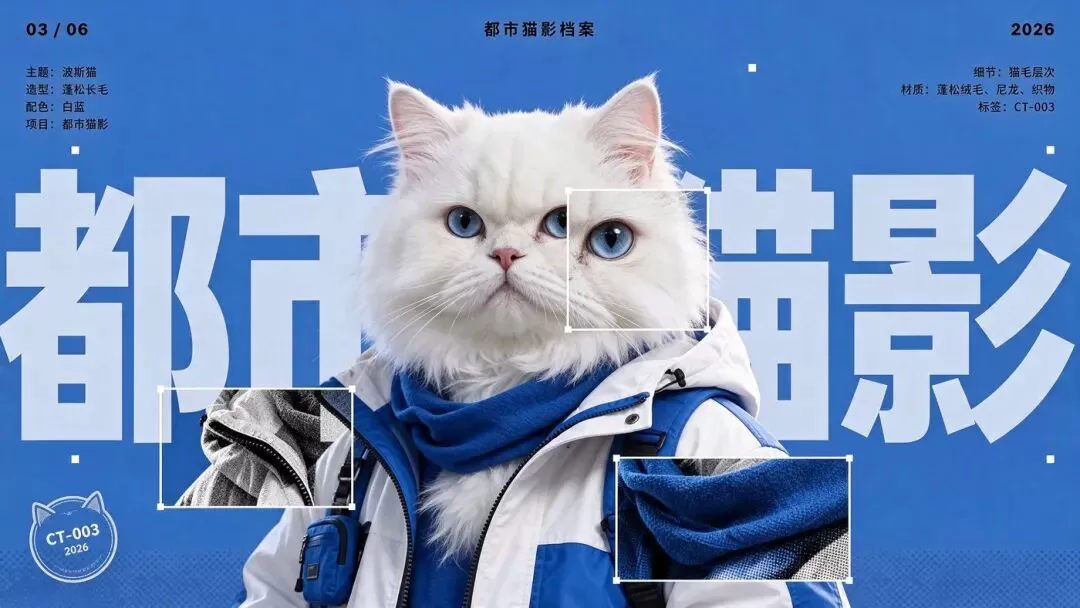
这些看起来只是小改动,实际操作起来却很容易翻车。Seedream 5.5 瞄准的正是这个痛点:让创作者保留已经满意的部分,围绕同一张图继续往下做。
多轮编辑:连续100轮不崩坏
官方展示了一组连续 100 轮的编辑实验,每一轮都以上一轮的结果为基础,继续修改同一个人物的服装、配饰和桌面物体。
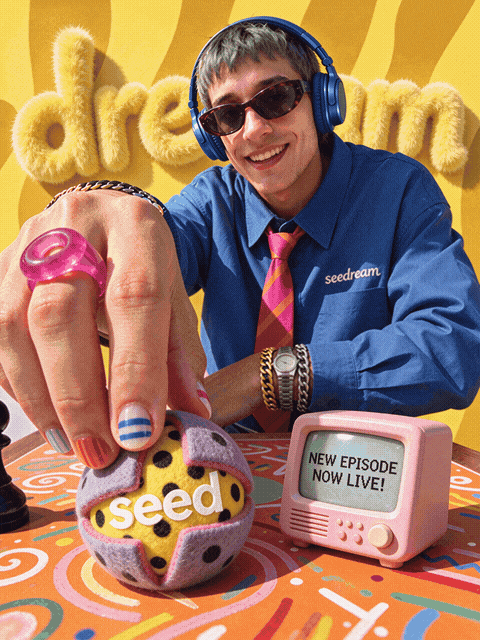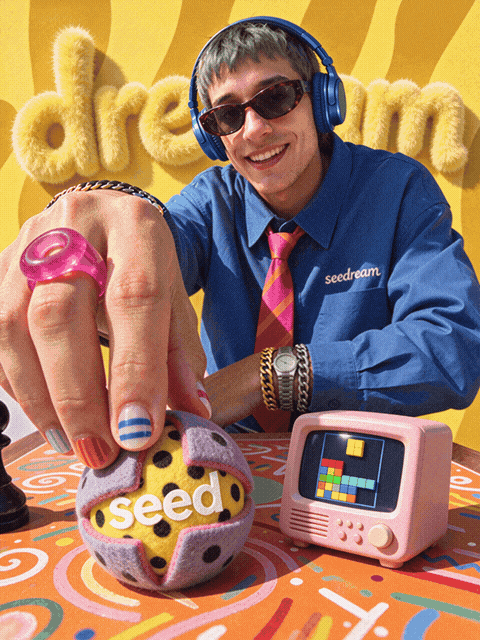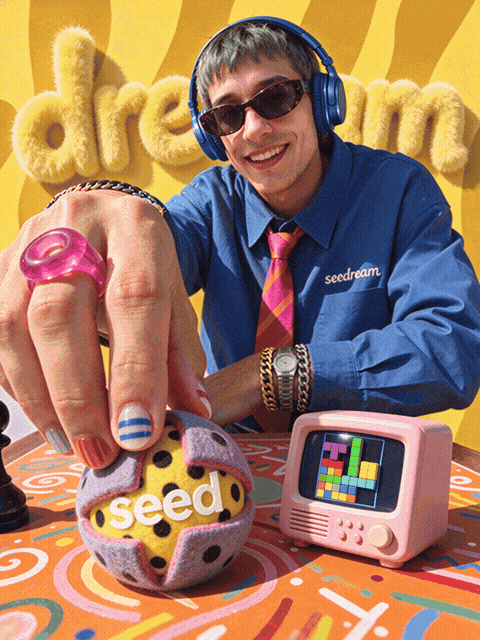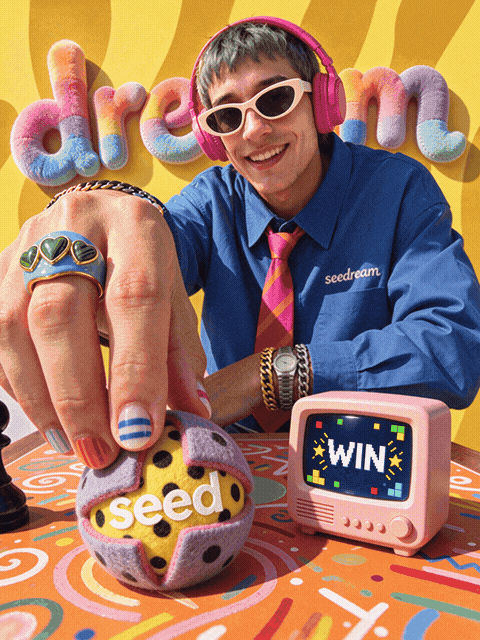
用同一张人像测试几组不同的眼镜,几轮生成下来,Seedream 5.5 确实保住了大部分已经确定的内容。不同结果中的人物依然是同一个人,脸型、眼睛、发型、服装、姿态和背景基本保持稳定,变化主要集中在眼镜附近。
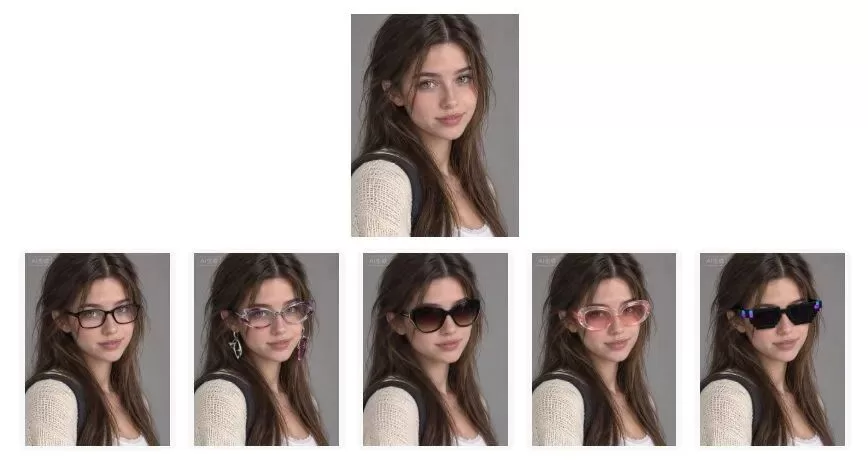
这件事看上去简单,其实很考验模型对画面的理解。它要判断这次应该改哪里,还要记住哪些部分已经被用户确认,最好别随便动。
再比如,把 9 个人的单人照片一起上传,又给了一张大合影的姿势参考,让 Seedream 5.5 把他们重新安排到同一张毕业合影里。
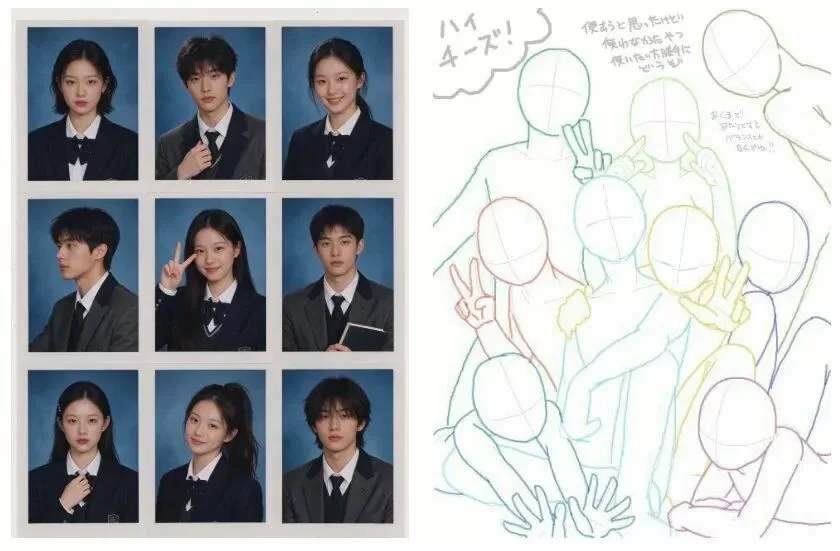
模型需要同时记住 9 个人的主要面部特征和校服设定,再根据姿势参考重新安排每个人的位置、动作和前后关系。从结果来看,9 个人都被完整放进了画面,主要外貌特征大体延续了下来,服装、蓝色背景和毕业照的整体氛围也比较统一。
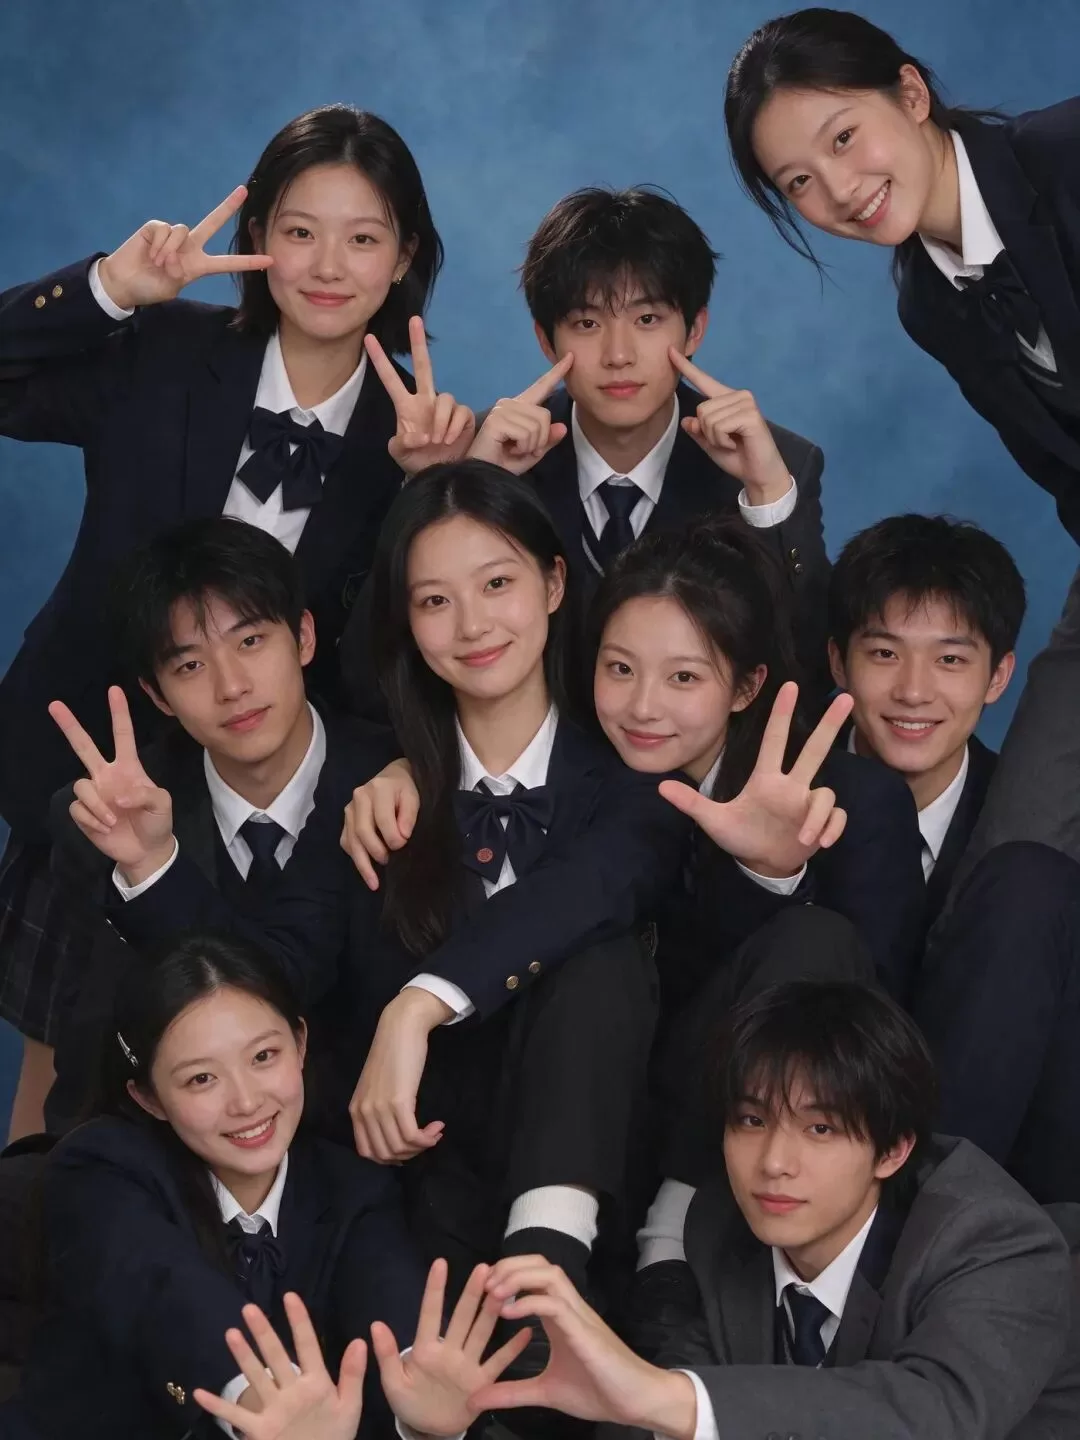
以后做团队合照、角色群像、品牌人物海报,可能都不需要先把每个人硬抠出来再手动排版了。
光线与材质:真实物理关系
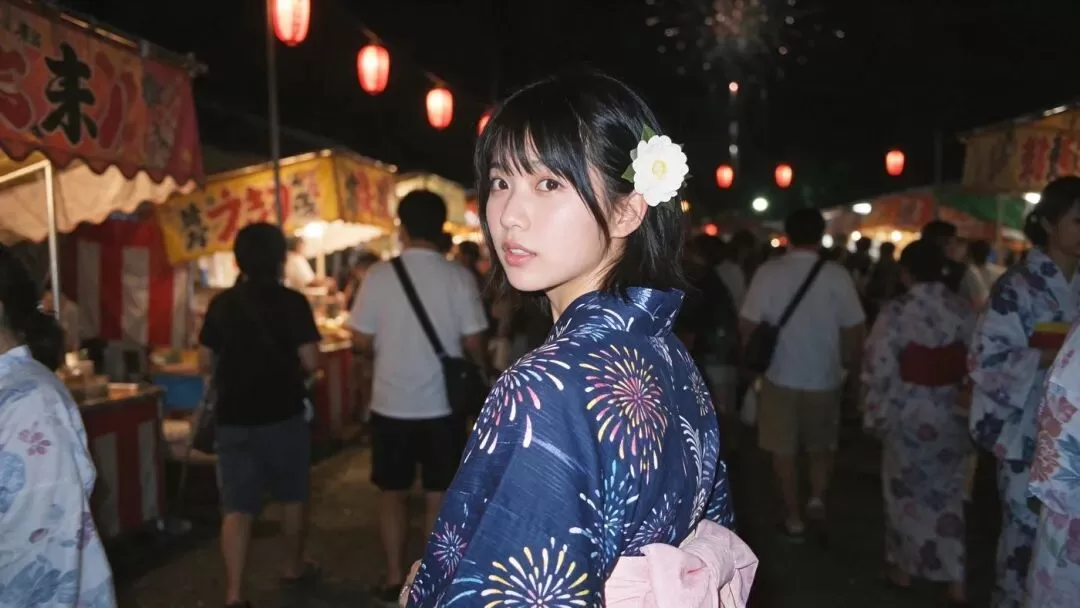
光稳定还不够,如果新增的光线、材质和物体无法融入原来的画面,最后依然很难使用。做了一组夏日祭典的系列画面,保留了同一个人物设定和浴衣造型,然后分别生成直接闪光灯、傍晚轮廓光、蓝调夜景和烟花照明下的画面。
直接闪光灯下,人物的面部和浴衣会被瞬间照亮,远处的人群与摊位则迅速沉入夜色。
烟花场景下,金色高光需要落到人物的发丝、脸颊和衣服上,同时保留暗部中的皮肤和织物细节。
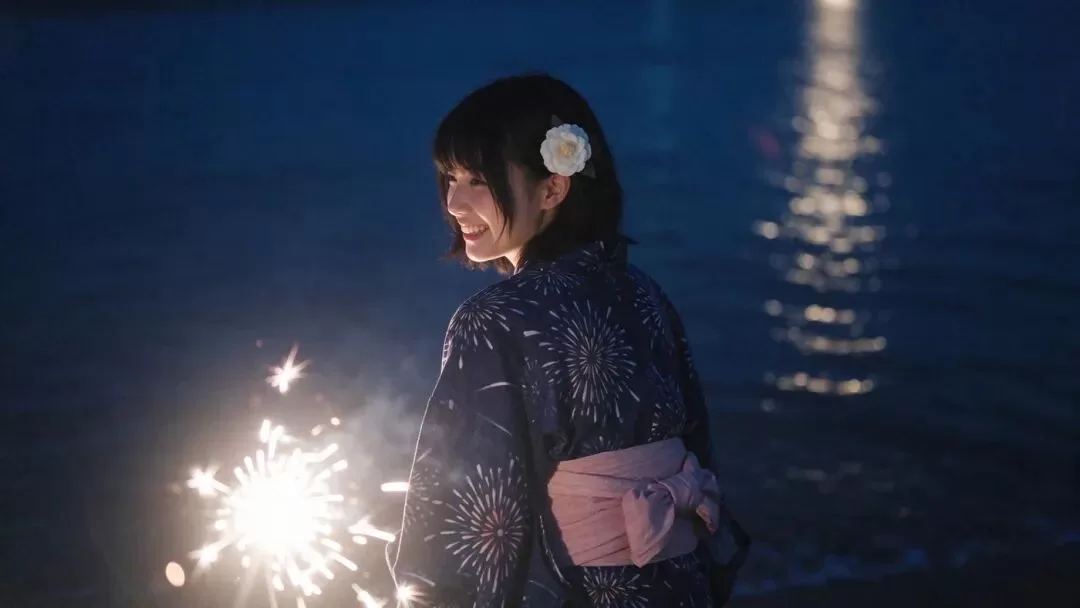
从结果来看,Seedream 5.5 对不同光源的表达已经比较自然。尤其是烟花、玻璃水缸和纸灯笼这些场景,不同材质对光线的反应存在明显区别。光线穿过玻璃与水体,会产生折射和焦散;落到和纸表面,则会变成柔和的漫反射,还要隐约露出纸张纤维。
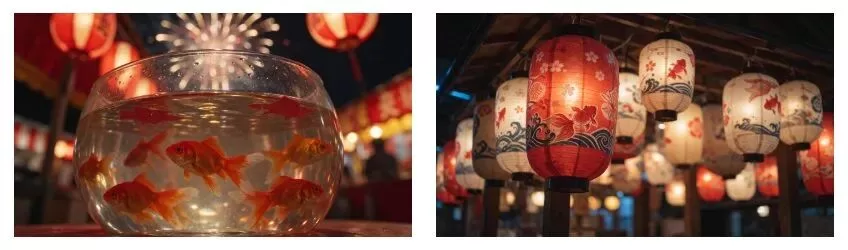
它开始进一步理解光从哪里来,以及这束光会怎样影响不同的物体。这对影视分镜、品牌视觉和系列内容很实用。
文字与透明素材
用饼干、奶油和毛绒等不同材质生成「西里森森」四个字。难点在于既要保留汉字结构,又要让笔画服从具体材质。从实际结果来看,四个中文字的主体结构基本都能保持,同时材质不是简单贴在字体表面,而是参与了笔画的立体塑形。
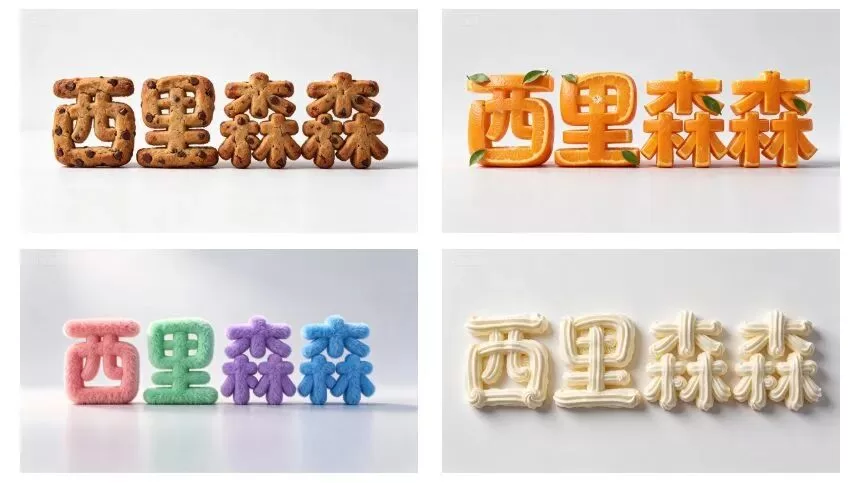
官方公布的评测中,Seedream 5.5 在中英文及密集小字任务上的严重文字崩坏率为 0.4%,轻微文字崩坏率为 1.7%。
之后生成了一组毛绒动物贴纸,测试透明背景输出。分别用了两种方法:一种是直接选择透明背景,另一种是在提示词里明确要求输出带 Alpha 通道的透明 PNG,最后得到的效果基本一致。
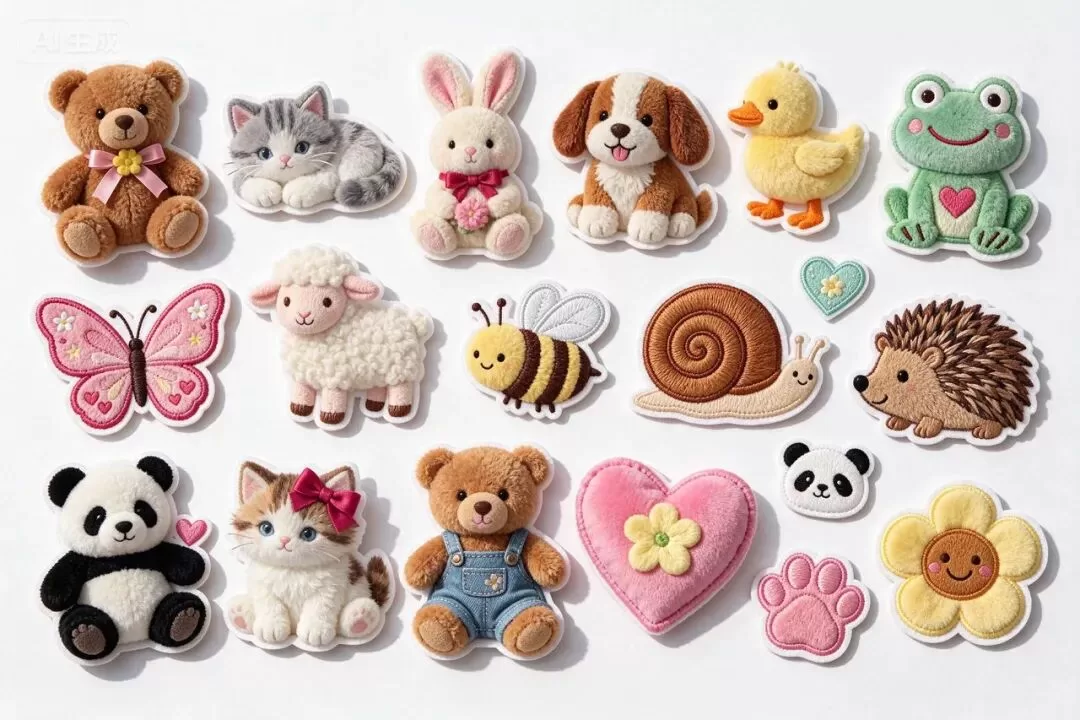
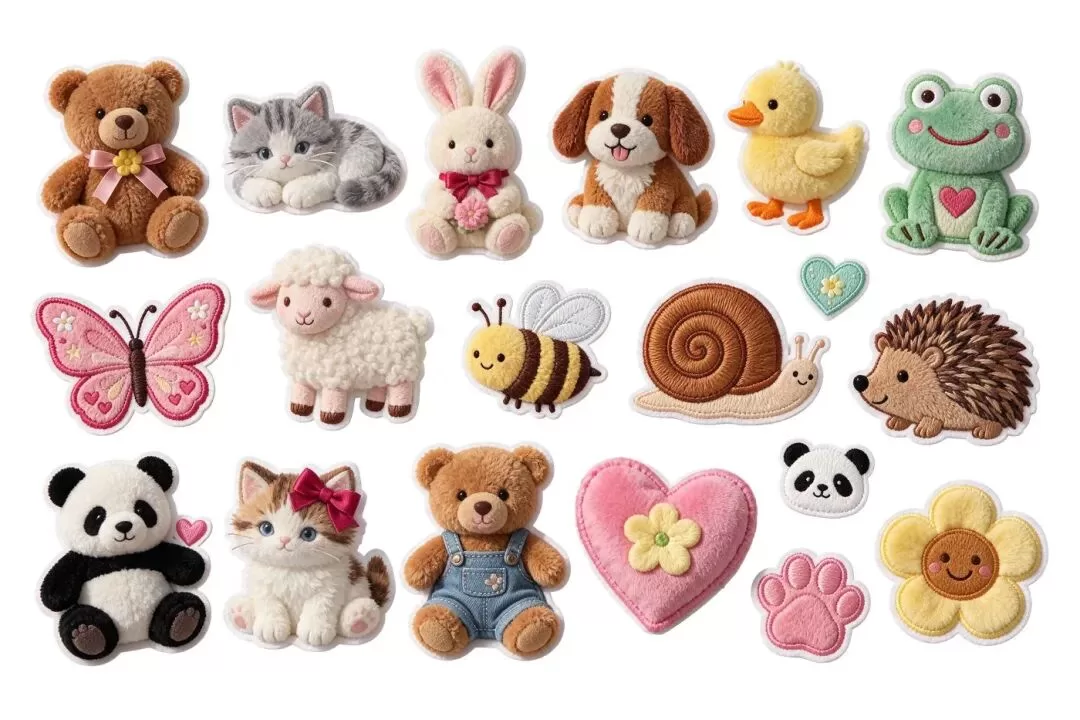
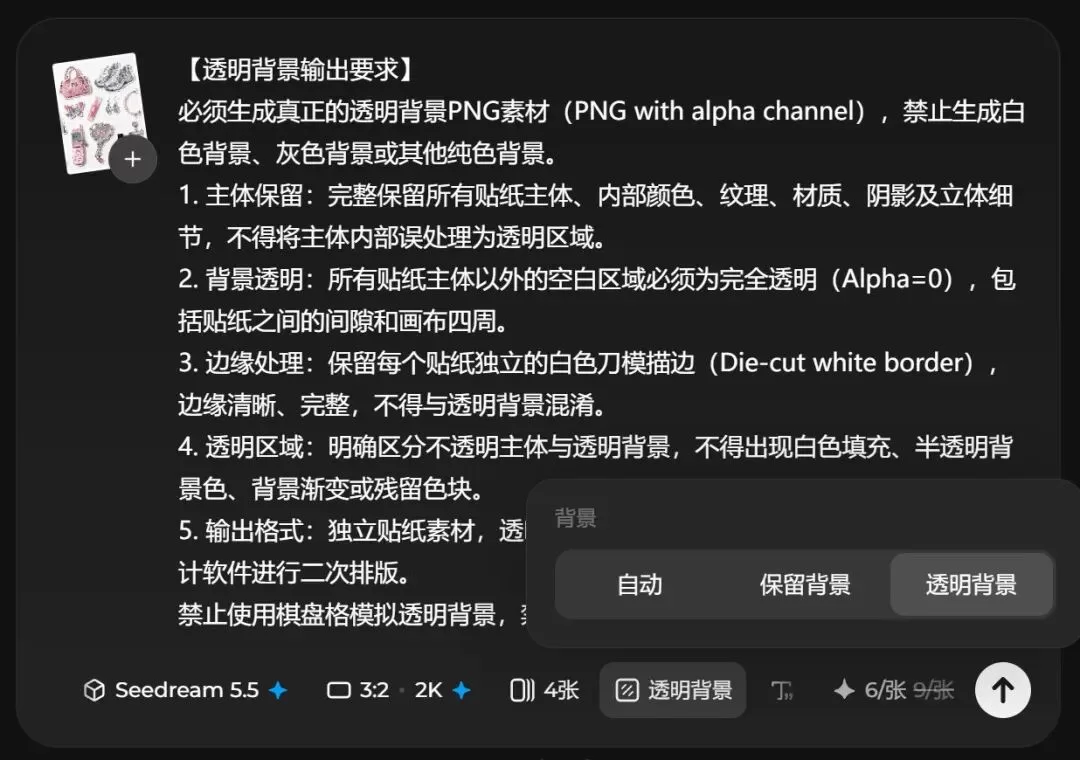
这些素材可以直接放进 PS、剪映或其他设计软件继续排版,不用再花时间抠图和清理白边。
创作工作流的变化
多轮编辑、一致性光影、透明图层……这些都在指向同一个终局:让 AI 生图变成可以接着改、拆开用、组合起来交付的创作资产。
电商视觉应该是非常直接的场景。同一个模特可以连续更换配饰和单品,不需要每次重新拍摄,也不用承担人物和构图全部变化的风险。
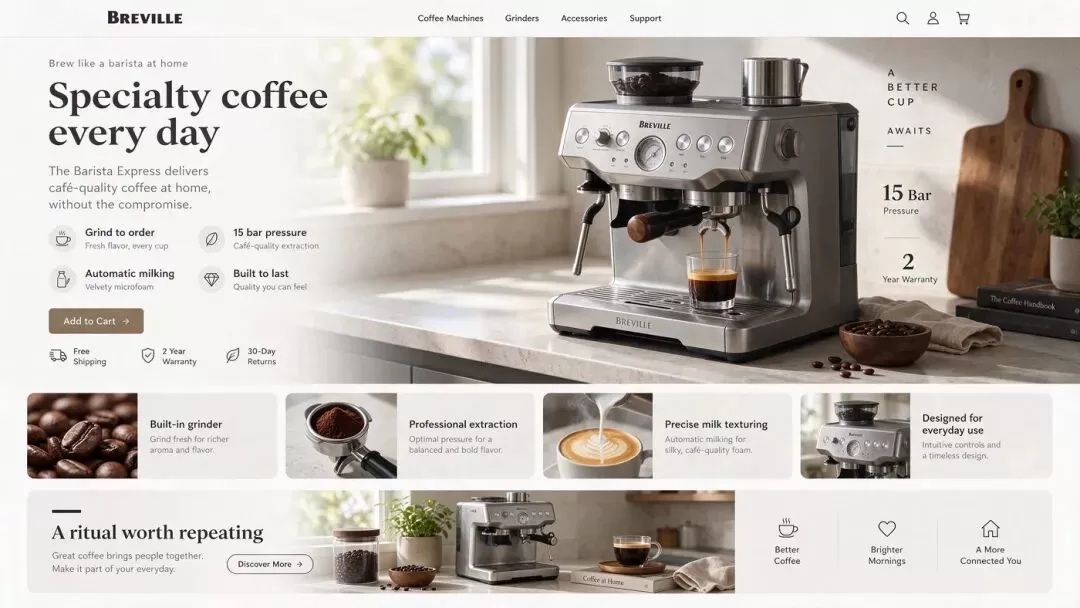
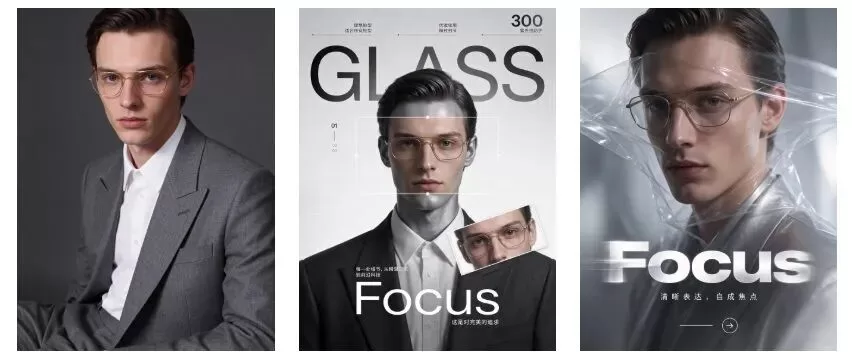
品牌与影视内容也很适合,很多创作者可以先确定人物、服装和视觉风格,再围绕同一套设定生成不同时间、光线和景别下的系列画面。透明素材则可以进入海报、电商详情页、短视频包装和社交媒体内容,减少重复抠图和修边。
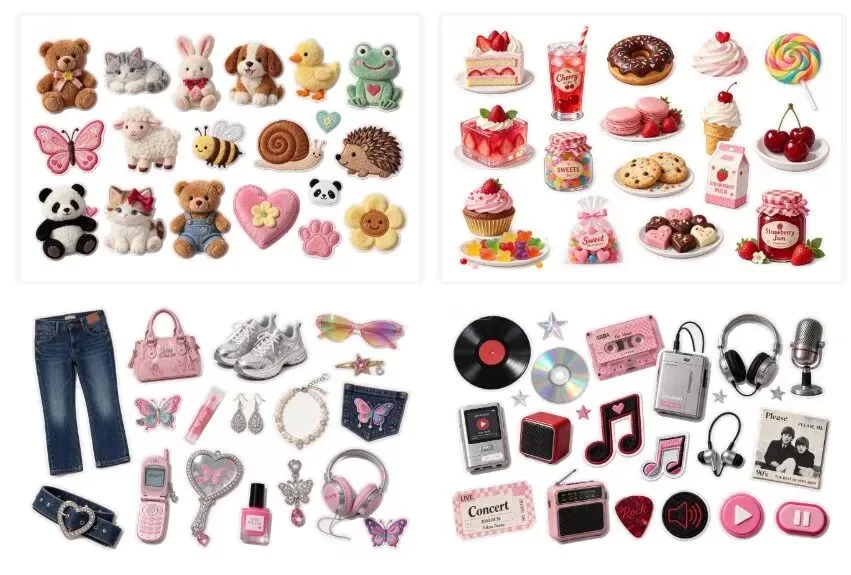
现阶段更现实的落地方式,是先让它处理系列视觉初稿、商品场景探索、影视概念图、透明素材制作和局部修改。
Seedream 5.5 还没有完全做到说什么就精确修改什么,但它已经让 AI 生图向前走了一步。当模型能够记住这些创作状态时,它才能真正参与第一张图之后的工作。