11 月 18 日,Google DeepMind 正式发布 Gemini 4 Neon。
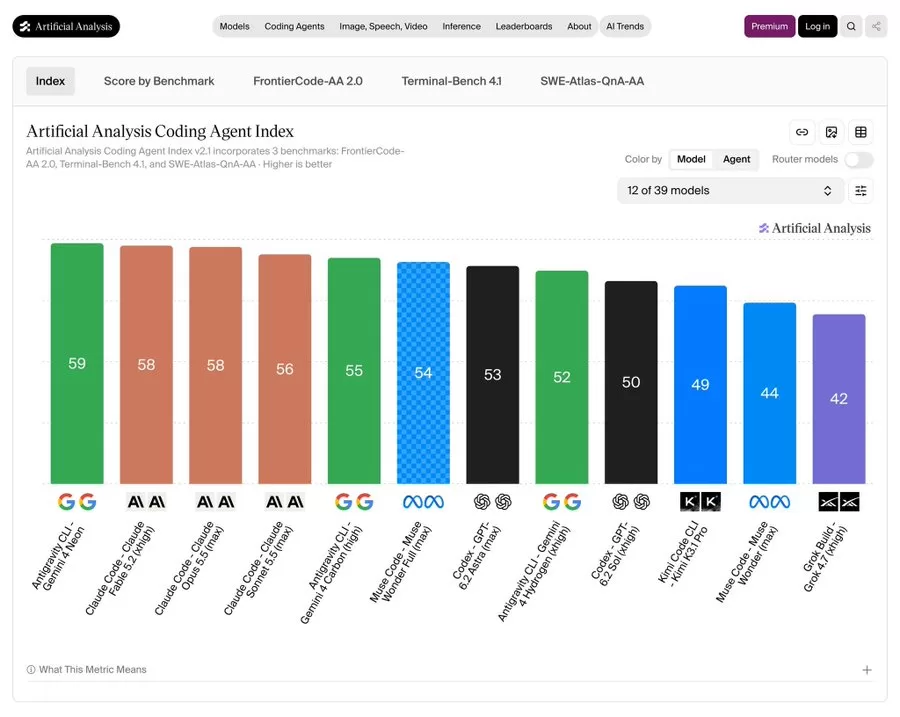
Artificial Analysis 的 Coding Agent 排行榜就换了第一名。
Neon 拿到 58.6 分,页面四舍五入显示为 59 分,Claude Fable 5.2 和 Opus 5.5 都在 58 分左右。
Fable 5.2 才发布九天,榜首的位置就被谷歌抢了。
Coding Agent Index 测量的是模型和 Agent 工具组合,Neon 使用 Antigravity CLI,Fable 使用 Claude Code。
评测覆盖代码修改、终端任务、仓库问答三个方向
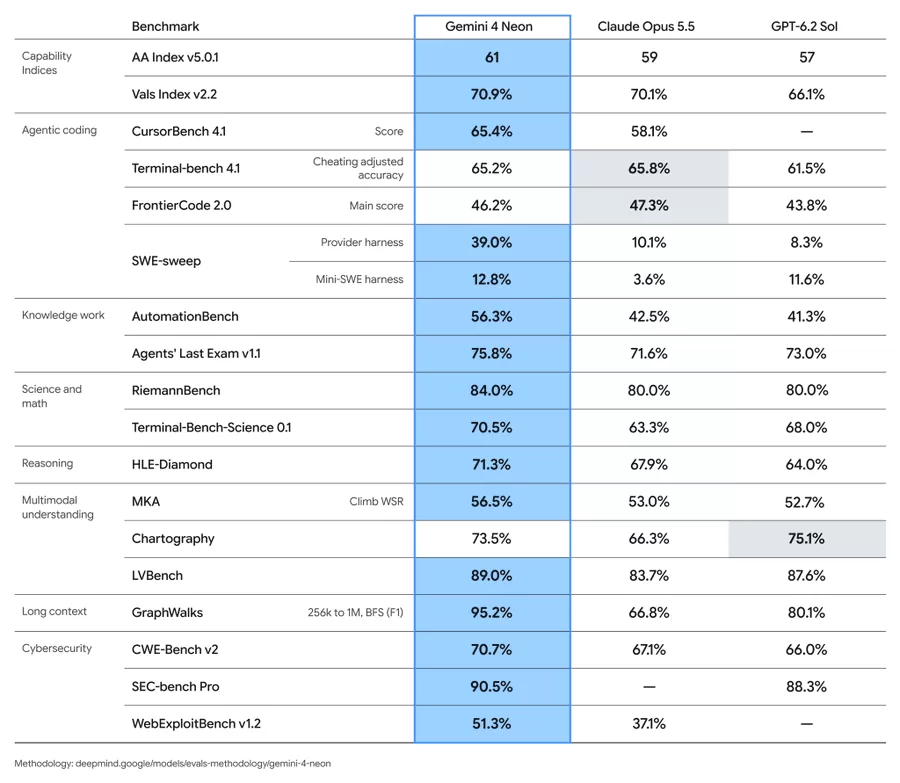
综合智能指数,Neon 得到 61 分,全球第三,超过 Opus 5.5,但仍落后于 Fable 5.2 和 GPT-6.2 Astra。
它在 CursorBench 4.1 拿到 65.4%,AutomationBench 达到 56.3%,长上下文 GraphWalks 高达 95.2%。
当然也有没赢的项目。
Terminal-Bench 4.1,Neon 是 65.2%,Opus 是 65.8%;FrontierCode 2.0,Neon 为 46.2%,Opus 为 47.3%。
谷歌对 Gemini 4 家族的安排也越来越清楚了。
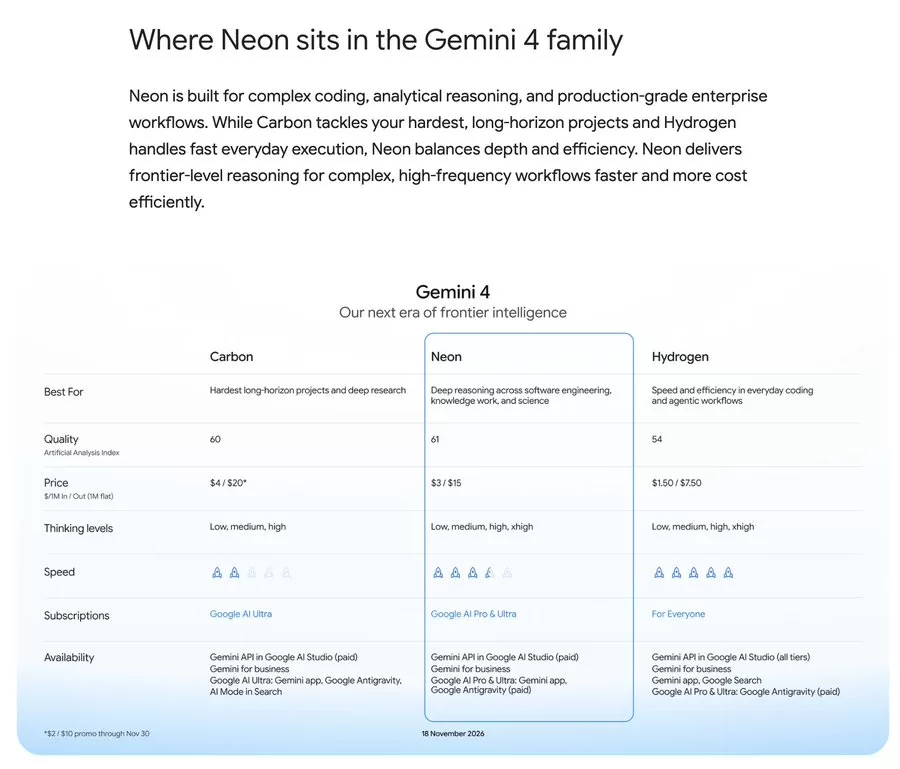
Carbon 的定位有点像 Claude Fable,专门啃那些特别难、特别长的任务。
慢是真的慢。可它处理长篇内容时的文笔、措辞和细节,又很有味道。
适合于做深度研究、写复杂稿件。
Hydrogen 则走轻量、快速的路线。
日常改代码、执行命令、批量处理一些明确的小任务,都更适合交给它。工作流里大量重复的动作,没必要每次都动用最重的模型。
Neon 的气质更接近 Opus。
推理能力强,Coding Agent 能打,还顾及响应速度和调用成本。
它在 Carbon 与 Hydrogen 的中间档位,多项能力指标甚至超过 Carbon。
不过谷歌并没有公布三者的参数规模。
Artificial Analysis 的数据还有个细节。
Neon 在综合任务中每秒输出约 110 Token,Carbon 约 57 Token。
Neon 每项任务仍可能花上二十多分钟,但和 Carbon 相比,整套任务的完成时间明显缩短。
价格上,百万输入 Token 3 美元,输出 15 美元。
没有 Carbon 那种限时首发价,不过缓存输入仍有 95% 折扣,只需 0.15 美元。它支持 100 万 Token 上下文,四档思考强度。
想追求质量可以开到 xhigh,日常工作用 high可能更合适。
可以通过 Google AI Studio 的付费 API 调用,Google AI Pro 和 Ultra 用户也能在 Antigravity 使用。
谷歌还提供 Neon 负责规划、Hydrogen 负责执行的编排思路。一个处理架构、难题和关键决策,一个负责日常修改和测试,路线很清晰。
今年谷歌这一轮大招,确实没让人失望。Carbon、Hydrogen、Neon 接连推出,能力、速度和价格都开始有明确分工。
Neon 尤其惊喜,拿到了 Coding Agent 第一名,价格又比 Carbon 的标准价低了四分之一。
现在最主要的问题是Antigravity 太差了,太差了。
整个功能完全没有跟上,仿佛是两年前的产品,模型都这么强了,工具却还拖着后腿,而且强绑定不支持反代。
如果你用不上 OPUS 5.5,我建议你直接上Gemini Pro 的 5X订阅。