用 AI Agent 干活的人,最近大概都有同一个感受:活是能干了,就是费钱又费时间。
智能体做一件事,要来回调用模型几十上百轮,每一轮都在消耗 Token。用大模型,质量好,但很贵;换便宜的小模型,又怕干到一半跑偏。
11 月 16 日,腾讯混元发布了 Hy4 flash,冲着的就是这个矛盾。
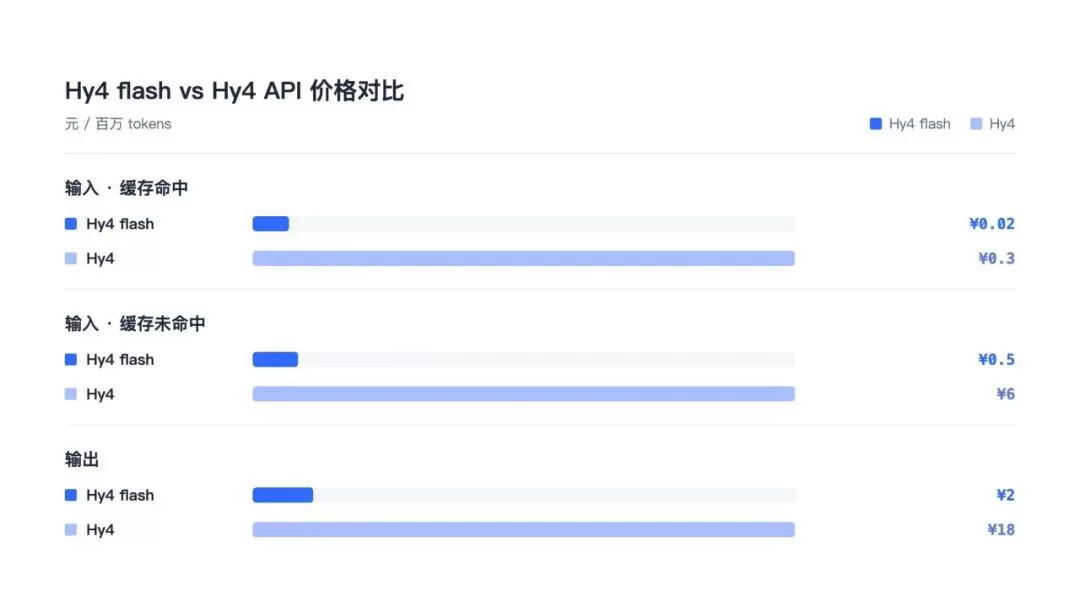
先说大家最关心的价格。每百万词元,输入 0.5 元,输出 2 元,命中缓存只要 0.02 元。
作为对比,同系列的 Hy4 分别是 6 元、18 元和 0.3 元。
如下图所示,为官方给出的 API(接口)价格对比:
官方说法是输出更精简、速度更快,同时保证智能体任务的完成质量。
这篇不讲观点,只做实测:同一批任务、同一套提示词,只换模型,用三把尺子量:活干没干成、花了多久、花了多少。
对照组选了两个:同门的 Hy4,和同档位的 DeepSeek-V4.1-Flash(1017,价格取忙时)。
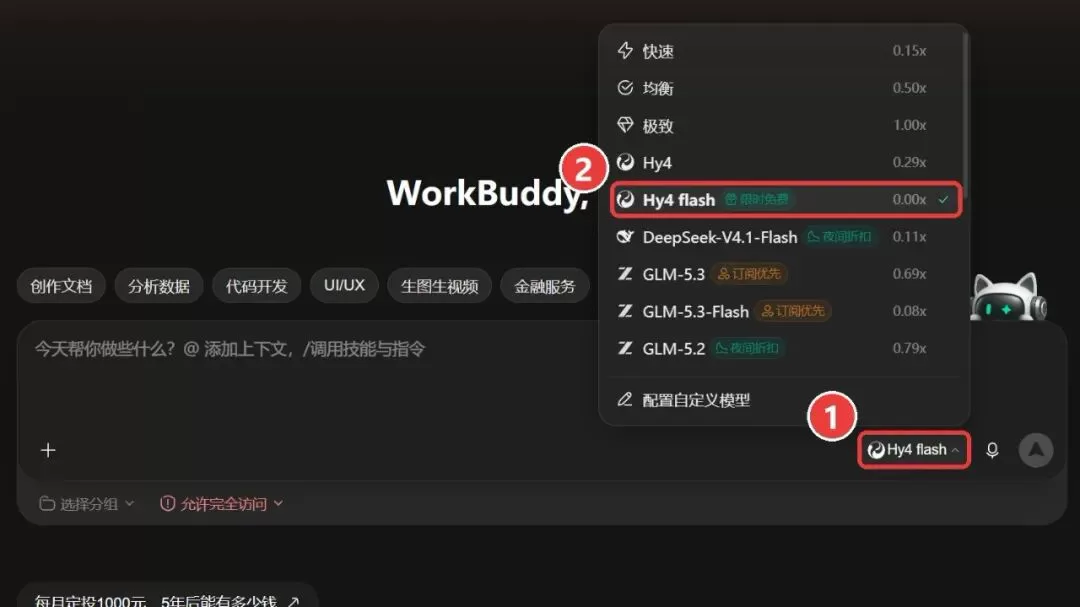
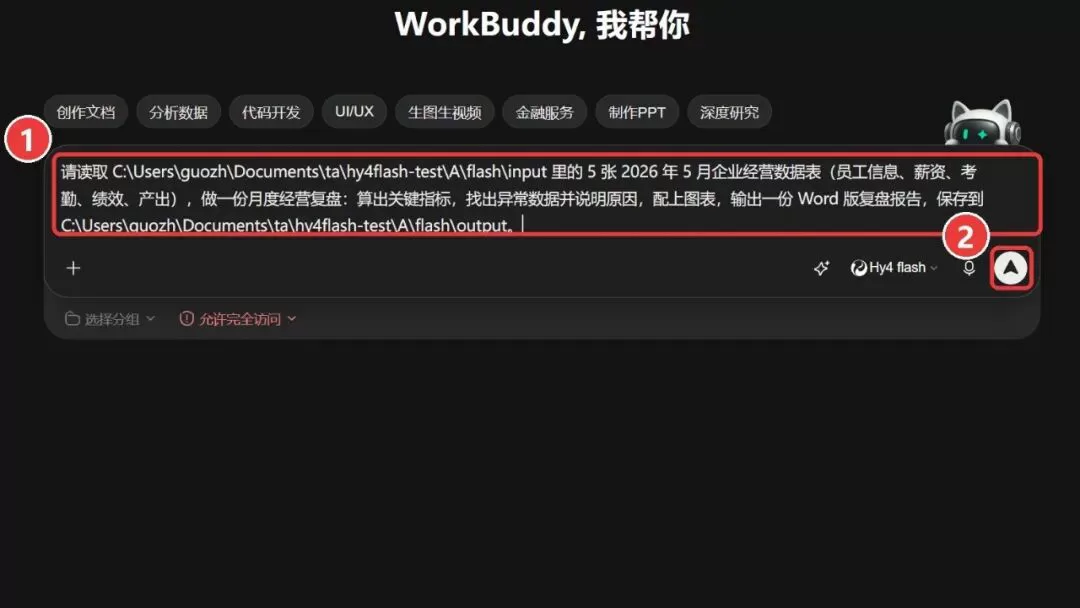
测试环境是 WorkBuddy(腾讯的智能体桌面工具)。11 月 30 日前,Hy4 flash 在里面限时免费。点输入框右下角的模型名,选 Hy4 flash 就行:
然后把任务写进输入框,点发送:
一、先测快和省:同一道题,看谁话少
先不上复杂任务,用 4 道单轮题看最干净的数据:一句话解释概念、写一段带测试的代码、一道推理题、读一篇文章写摘要。
我不靠肉眼估,WorkBuddy 会把每一次模型调用的词元用量和时间戳记在本地,我写了个脚本直接读出来。
4 道题三个模型全部答对。差别在话多话少:
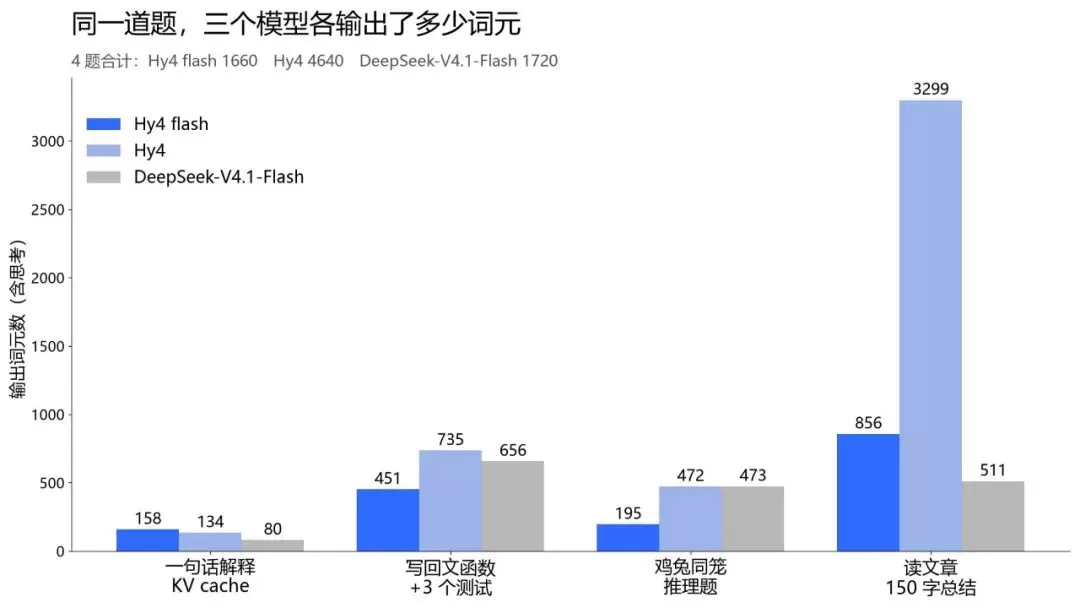
4 题合计,Hy4 flash 输出 1660 个词元,Hy4 是 4640,DeepSeek-V4.1-Flash 是 1720。
也就是说,Hy4 flash 只用了 Hy4 不到四成的字数,和 DeepSeek 基本持平。不过也不是每题都最短,第一题它反而比另外两个多说了几句。
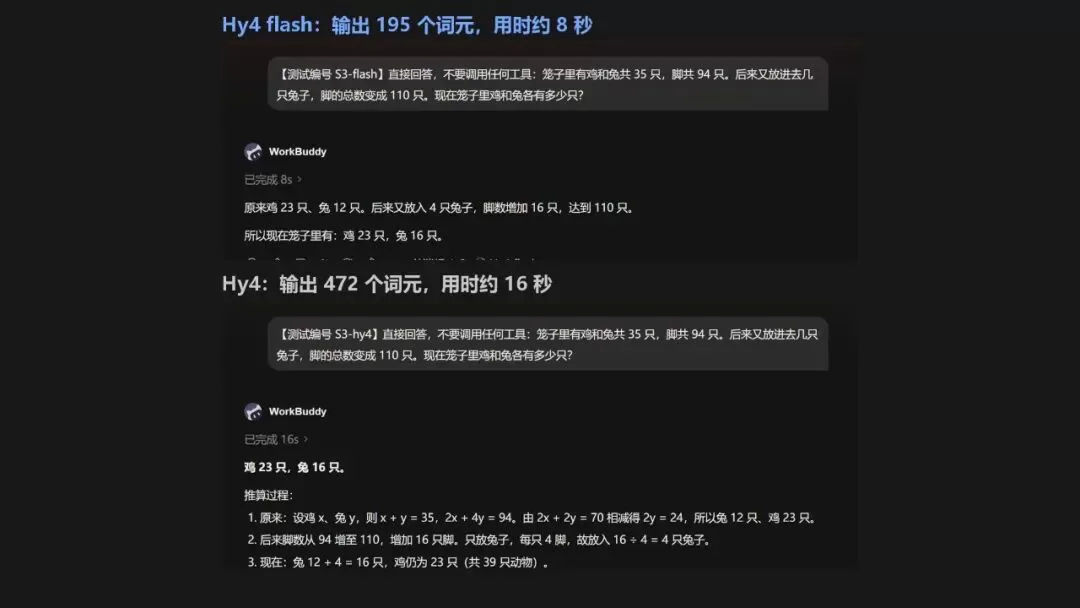
最直观的是鸡兔同笼这道题。Hy4 flash 两句话给出答案,8 秒;Hy4 把推算过程和验算都写了一遍。16 秒:
这里有一个技术点要讲清楚:为什么说得短,既快又省?
官方的做法是两头下手:后训练阶段用强化学习,把端到端任务的输出长度降了 50%;架构上用混合注意力等设计,把 KV cache(键值缓存,模型记住上文要占的显存)压到 Hy4 的六分之一,解码速度超过每秒 150 个词元。
单轮只是热身,真正的账要在长任务里算。
二、 办公智能体实测:两个真任务
任务一:月度经营复盘。
我把 5 张真实的企业经营数据表丢给它:员工信息、薪资、考勤、绩效、产出,一万两千人的规模。要求算出关键指标,找出异常数据并解释原因,配图表,交一份 Word 报告。
这个任务同时考表格处理、分析能力和成品质量。
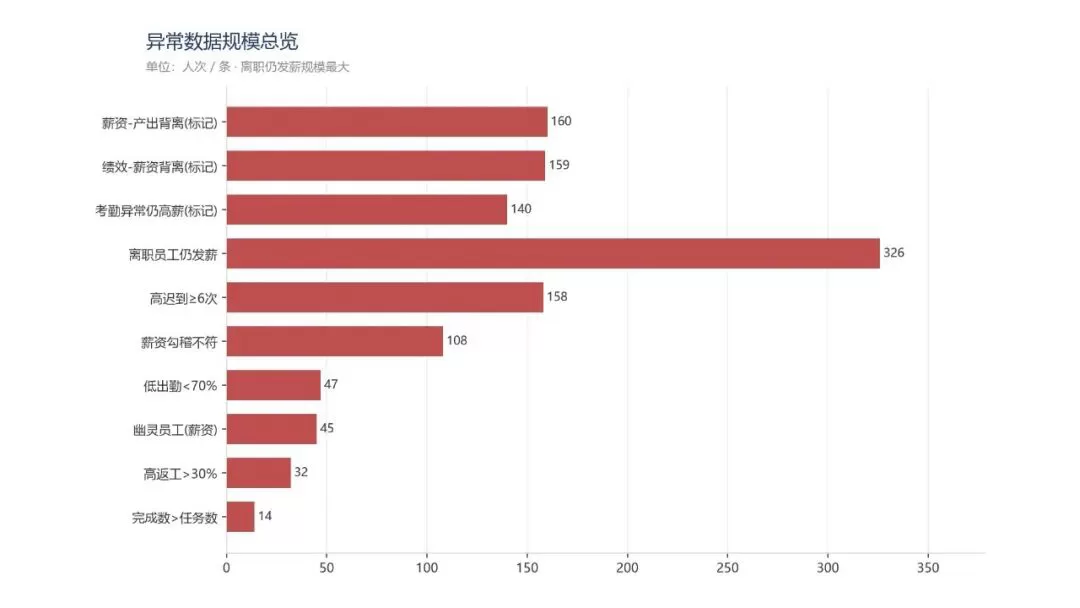
Hy4 flash 用了 17.1 分钟,交出一份 16 页的报告,带 10 张图表,还在对话里列出了离职仍发薪、绩效和薪资背离等四类核心问题:
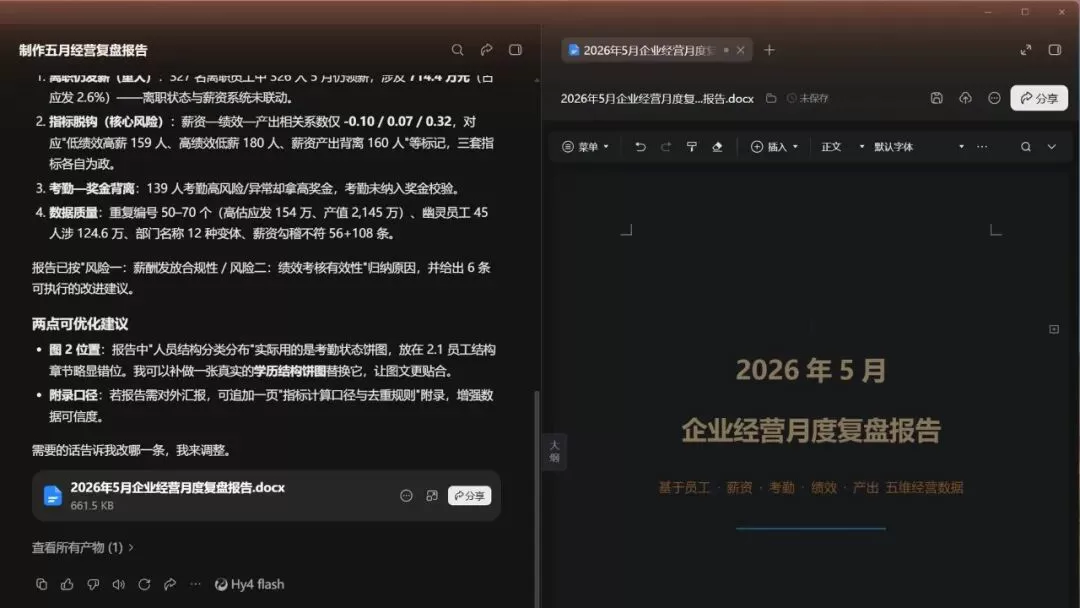
如下图所示,为报告里的一张异常数据总览图,离职员工仍在发薪的有 326 人,是最大的一类问题:
同一个任务,Hy4 用了 34.3 分钟,DeepSeek-V4.1-Flash 用了 36.4 分钟。三份报告都能用,Hy4 flash 最快交付。
任务二:联网调研出报告和 PPT。
围绕"2026 年国内人形机器人行业进展",让它自己查资料,对比主要厂商的产品、价格和量产交付,交一份调研报告和一份 10 页左右的汇报 PPT。
这是长链路任务,全程上百步,考规划能力和工具调用稳不稳。
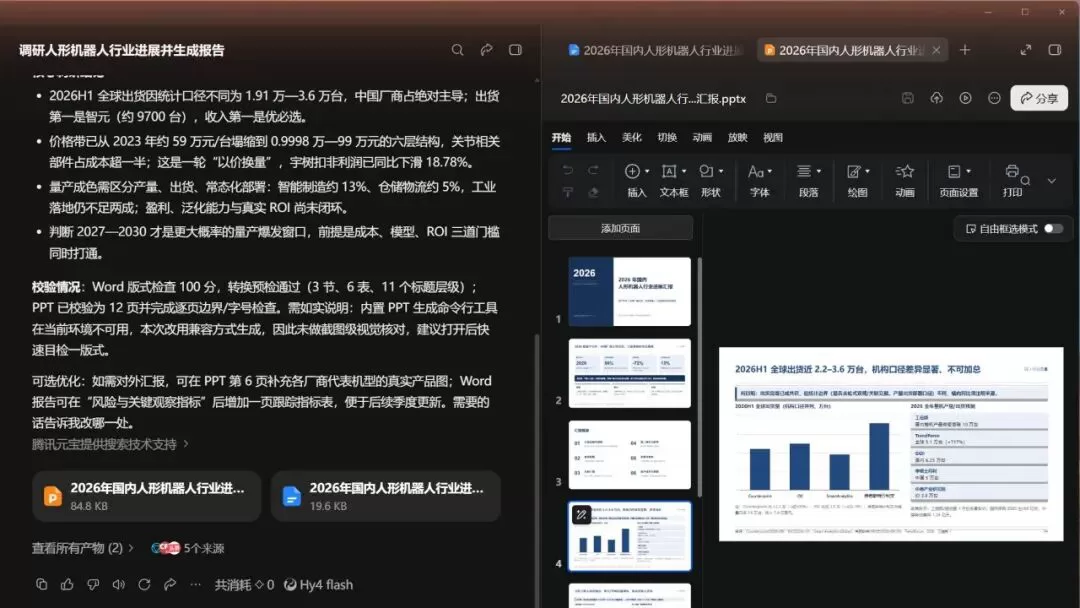
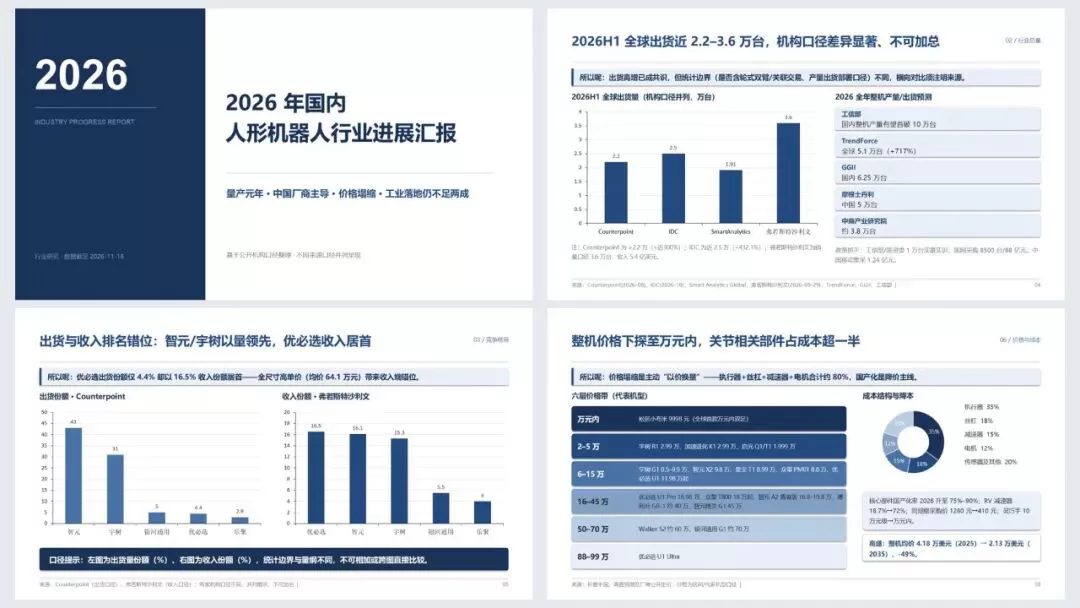
flash 做了 12 页,有出货量柱状图、价格分层表和成本结构环形图,结论也敢下判断。我用 PowerPoint 把每一页导出来看过,排版没有错位:
这一题它不是最快的:Hy4 flash 18.2 分钟,Hy4 17.9 分钟,DeepSeek 15.5 分钟,基本在一个档位。
但成本差距很大。按官方标价折算后,Hy4 flash 这一单是 0.56 元,DeepSeek 1.99 元,Hy4 3.80 元。
三、 编程智能体实测:写代码、改项目,再算一笔总账
任务一:从零写一个小工具。
我电脑里有 56 篇公众号草稿,让它写一个 Python 工具:批量统计每篇的标题、字数、图片数和小节数,生成目录表,要求自己运行、报错自己修。
Hy4 flash 3.3 分钟跑通,交出代码、Excel 目录表和统计结论:
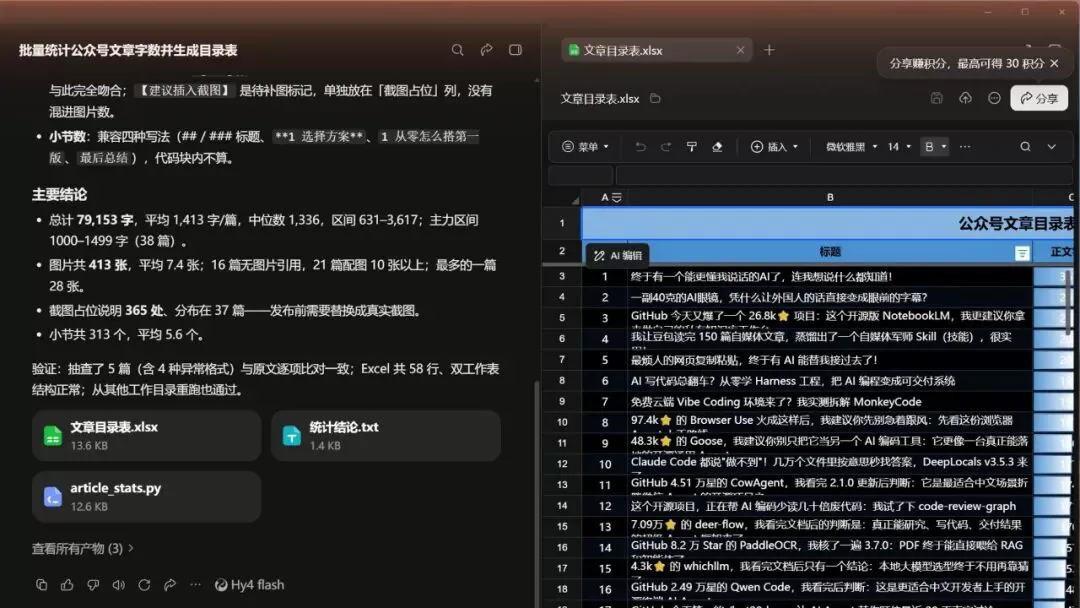
我拿三个模型的结果对了一遍,图片总数都是 413 张,完全一致。Hy4 用了 7.9 分钟,DeepSeek 用了 5.9 分钟。
任务二:读懂真实项目再动手。
这是我平时推送公众号草稿用的脚本。让它先读懂代码,再加一个预检模式:不调任何接口,只检查标题长度、图片在不在、有没有超过 1MB、正文里有没有忘删的占位标记。
Hy4 flash 2.2 分钟改完,还拿项目里的文章实际跑了一遍:
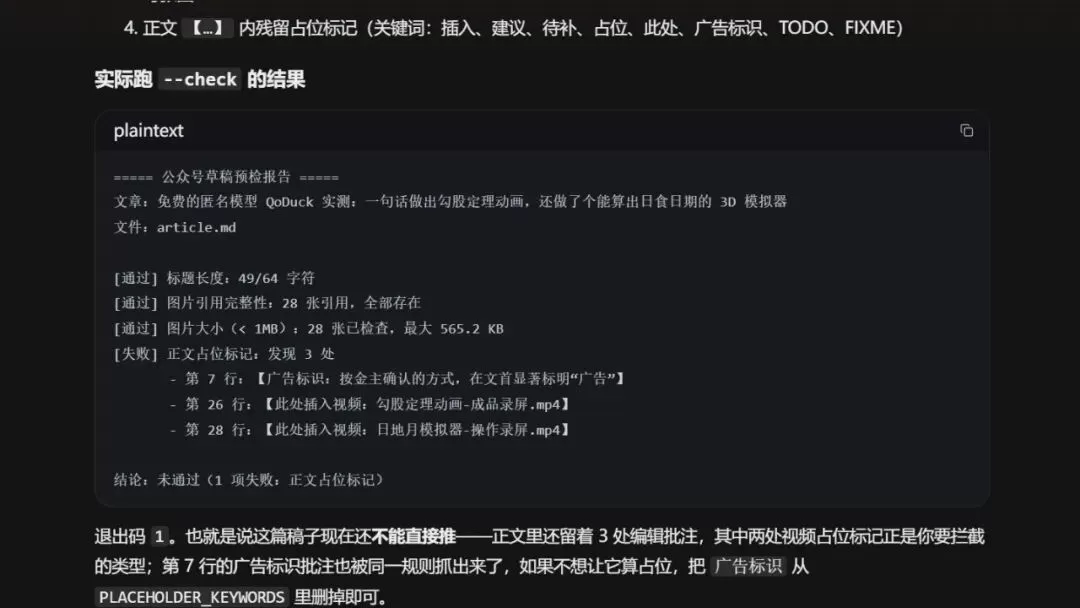
改完的脚本我自己又跑了一遍,三处遗留的占位标记全部揪了出来。另外两个模型改的版本也都能用。
DeepSeek 用了 2.0 分钟,和 Hy4 flash 差不多;Hy4 开头深度思考了将近 9 分钟,总共用了 15.7 分钟。
把以上四个任务的数据汇到一张表里:
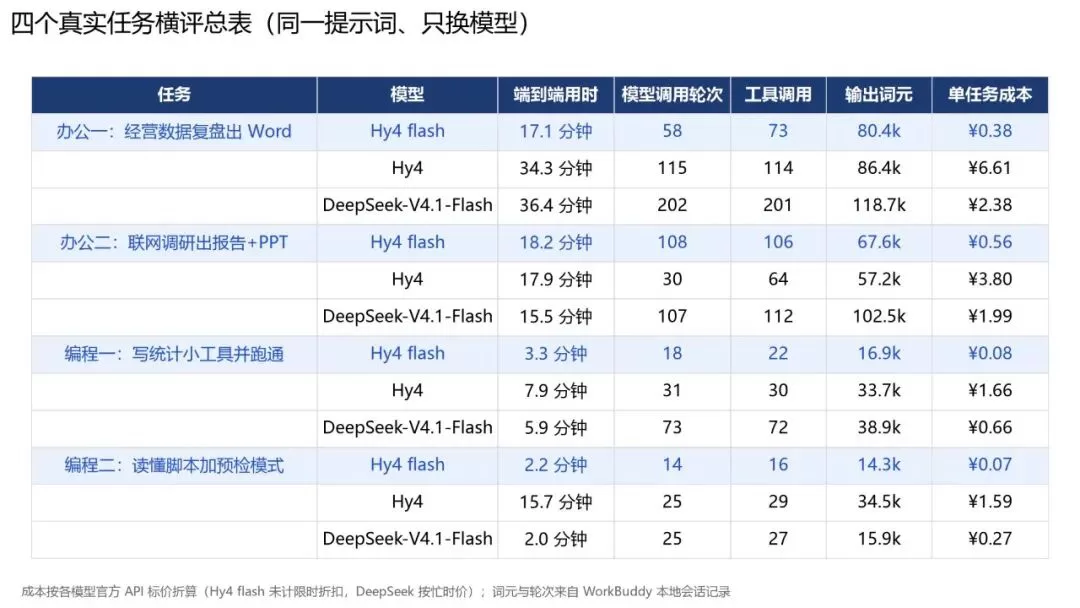
最后算总账。成本按各模型官方标价,用实际消耗的词元折算,并且只算交付成功的任务,这次 12 单全部成功:
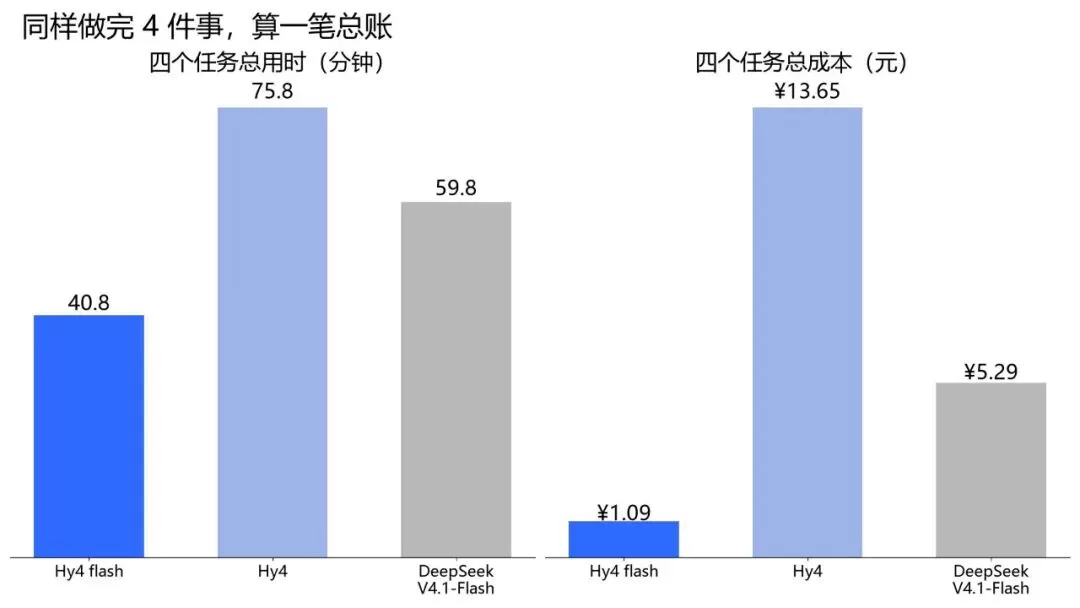
同样做完 4 件事,Hy4 flash 总用时 40.8 分钟,比 Hy4 少 46%,比 DeepSeek 少 32%。
总成本 1.09 元,约为 Hy4 的 1/12、DeepSeek 的 1/5。换句话说,一块钱差不多能让它办成 4 件这样的事。
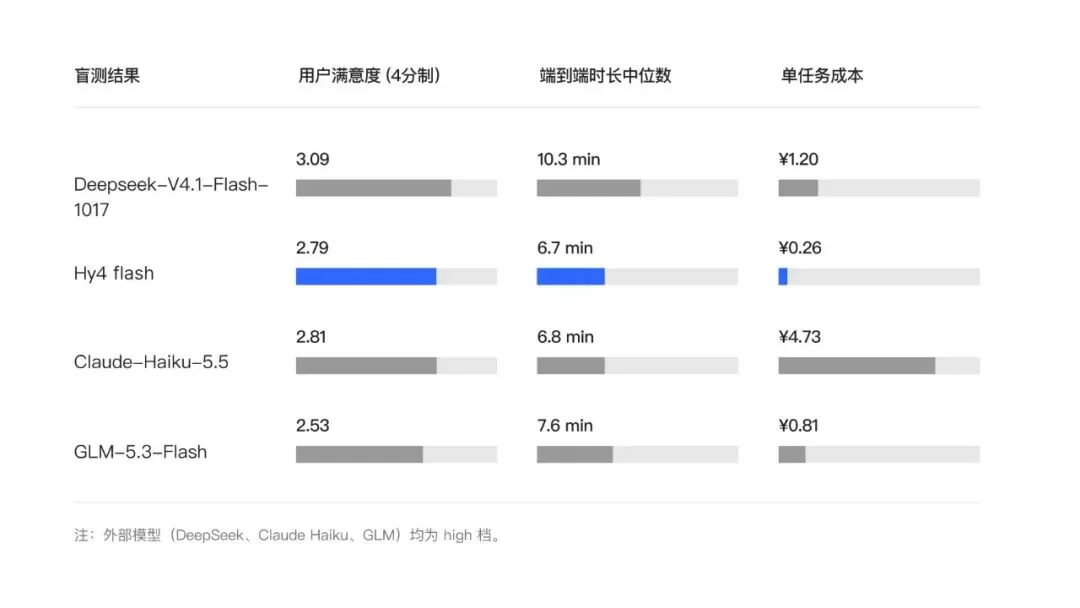
这个结果和官方的大规模盲测方向一致:85 位用户、259 个日常任务,Hy4 flash 满意度接近 Claude Haiku 5.5,任务时长最短,单任务成本最低:
最后总结一下
这次我在 WorkBuddy 里用 4 个真实任务、4 道单轮题,把 Hy4 flash 和 Hy4、DeepSeek-V4.1-Flash 放在一起跑,数据全部来自本地记录。
结论很清楚:活都干成了,Hy4 flash 快了将近一半,成本降到原来的十分之一左右。
我的选用建议:日常办公、数据整理、写报告做 PPT、写小工具,直接交给 Hy4 flash;长程软件工程这类硬骨头,还是上智能上限更高的 Hy4,这和官方的推荐一致。
11 月 30 日前 WorkBuddy 里限时免费,腾讯云 TokenHub 的 API 限时 5 折,感兴趣的抓紧去体验。