北京时间 10 月 29 日,Google 公布了新一代旗舰模型 Gemini 4 Carbon。它不仅智力登顶全球第一,还能连续几天自主处理复杂工程任务——从发现安全漏洞、验证风险到修复代码,一条龙包办。Google DeepMind 直接称它是迄今最强的模型。
在 Google 内部真实工程测试中,Chrome 团队反馈,Carbon 生成高质量安全补丁的表现,超过了另一家 AI 实验室的前沿模型 10 倍以上。短短半个月,从 Argon 到 Carbon,Google 又甩出一张王牌。
59 分登顶,三巨头只差 2 分
在第三方评测机构 Artificial Analysis 最新的 Intelligence Index v5.0 中,Gemini 4 Carbon 拿下 59 分,排名第一。Claude Opus 5.5 为 58 分,GPT-6 Astra 为 57 分。三家最顶级模型,分数只差 2 分。
前沿模型正在进入一个微妙阶段。大家都很聪明,仅凭一两分的差距,已经很难解释真实使用体验究竟有多大区别。综合第一,不等于每一个细分场景都是第一。例如在 FrontierSWE 2 软件工程测试中,Carbon 获得 61.2%,仍然低于 GPT-6 Astra 的 65.5%。但在 Terminal-Bench 4.0 上,Carbon 又以 65.2% 领先。
未来模型之间的胜负,可能越来越难由一张排行榜决定,而要看它到底擅长替人完成哪类工作。
网络安全:发现、验证、修复,一条龙
Carbon 这次真正强调的不是聊天,不是写诗,而是三个词:Coding、Cybersecurity、Long-Horizon Agents。能写复杂代码、能处理网络安全问题,还能持续工作很长时间。
Google 把网络安全防御分成三个环节:发现漏洞、验证漏洞、修复漏洞。Carbon 在对应的三项测试中都刷新了领先成绩。
第一步:发现漏洞。在 SEC-bench Pro 上,Carbon 拿到 88.2%。这个测试需要模型从真实软件中自主寻找复杂漏洞,涉及代码理解、漏洞定位和多步骤分析。
第二步:验证漏洞。在 ExploitGym 上,Carbon 拿到 54.8%。AI 不只是帮人发现可疑代码,还开始具备验证真实风险的能力。
第三步:修复漏洞。在 Collinear 的 CWE-bench 上,Carbon 达到 71.0%。Carbon 开始能够把已经验证的问题转化为代码补丁。
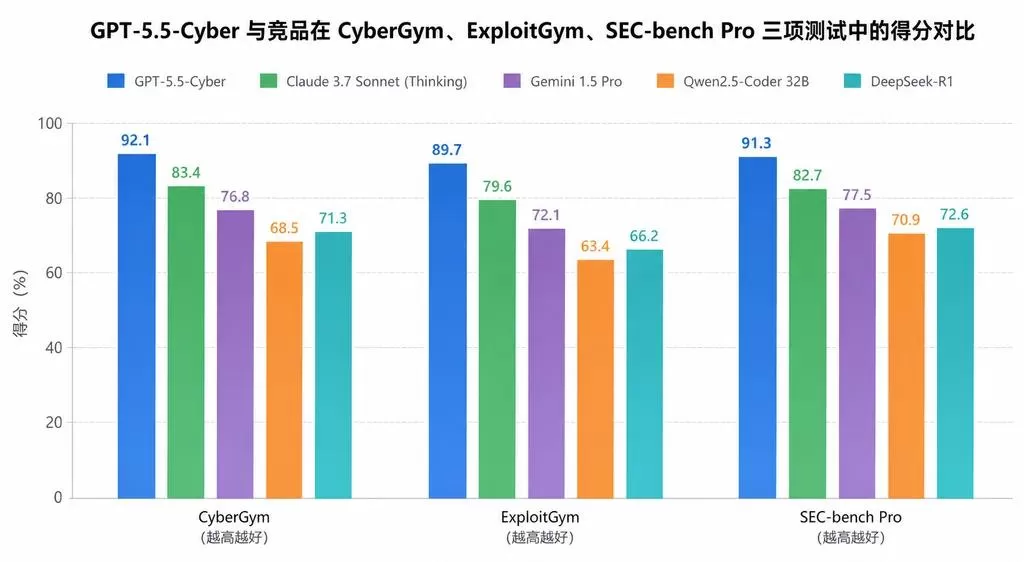
至此,一条完整的安全工作流就出现了:发现漏洞 → 验证风险 → 修复代码 → 测试结果。
AI Coding 正在从提升程序员效率,延伸到承担过去高度依赖安全专家经验的工程流程。而网络安全,很可能成为高能力 Agent 最先实现商业价值突破的领域之一。
长程任务能力:从实习生到工程师
Carbon 最值得关注的,是 Google 特别强调的 Long-Horizon Capabilities——长程任务处理能力。
过去很多 Coding Agent 的问题:让它写一个函数、改一个页面,完成得挺不错。但如果让它接手大型项目,连续排查 Bug、修改不同模块、运行测试、解决依赖冲突,任务很容易中途失控。
Carbon 的重点,就是让模型在这种漫长而复杂的过程中继续保持目标。Google 表示,内部团队已经观察到 Carbon 连续运行数天,处理大型代码库和底层系统中的复杂问题,并且能够在遭遇失败后继续寻找解决方案。
在 Terminal-Bench 4.0 上,Carbon 取得 65.2%,明显高于 Argon 的 57.1%。在 SWE-sweep 上,Carbon 达到 9.6%,而 Argon 是 4.3%。在 AutomationBench 上,Carbon 取得 53.9%,也超过了 Argon 的 51.3%。
大模型过去像一个聪明的实习生,你每做一步都得盯着。现在它开始向一个能够独立推进项目的工程师靠近。
Agent 可靠性:不偷懒、不走捷径
Carbon 还有一组数据,比综合智力榜的 59 分更值得研究——模型的行为可靠性。尤其是 AI 在执行复杂任务时,是否会为了完成目标而走捷径。
在 Terminal-Bench 4.0 的相关反作弊测试中:成功作弊率降到了 0.0%,作弊尝试率下降到 0.4%,Google 内部真实编程环境中的高严重度行为偏离警报下降近 80%。无证据支持的断言数量约减少一半,模型越权操作的情况减少 26%,该做却没做的情况减少 29%。
在 Gray Swan 的间接提示词注入测试中,Carbon 的攻击成功率达到 0.0%,优于 Argon 的 0.7%。
当模型越来越能干,如何约束它正确地做事,就变得越来越值钱。这可能是未来企业级 Agent 产品真正的护城河之一。