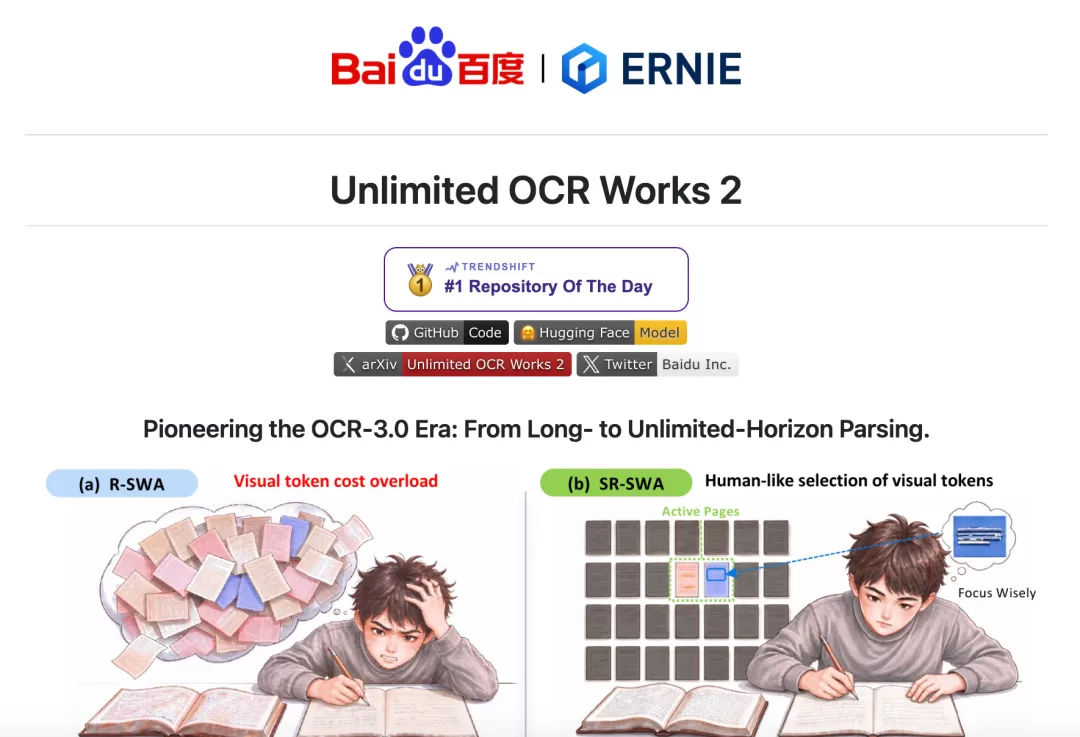
百度一口气开源了文心 Unlimited OCR 2。官方实测直接放了个狠活:模型一次性解析了《哈利·波特》全系列 7 部作品,累计超过 3600 页,全程没有任何分页处理,纯模型推理一口气出结果。
你没看错,3600 页。这不是几十页、不是上百页,是 7 本精装书的体量。
Unlimited OCR 初代 6 月刚发布,第二天就登顶了 GitHub Daily Trending 总榜和 Python 榜,Hugging Face 全球模型总趋势榜和多模态模型趋势榜四榜第一,GitHub Star 5 天破万。而如今,累计 Star 2.9 万,Hugging Face 下载量突破 1000 万次,连图灵奖得主 Yann LeCun 都转推推荐过。
这次的 Unlimited OCR 2,直接把上一代"数十页级"的能力拉到了"任意页数级",业内给它起了个响亮的称号——OCR 3.0。
项目是什么
文心 Unlimited OCR 是百度文心团队开源的端到端超长文档解析模型,定位是下一代 OCR 基础设施。项目基于 DeepSeek OCR 架构做深度改造,核心贡献是在解码器中引入了原创的注意力机制,彻底打破了长文档解析的计算瓶颈。
整个项目分两代演进:
- Unlimited OCR 1:提出 R-SWA(参考滑动窗口注意力)机制,首次把 OCR 从"单页解析"拓展到了"连续数十页一次性解析",并且在整个解码过程中保持恒定的 KV Cache 内存占用。
- Unlimited OCR 2:在上一代 R-SWA 基础上升级为 SR-SWA(稀疏参考滑动窗口注意力),通过页面门控和 Token 桶两个关键技术,进一步把计算开销从"数十页级别"压缩到"真正的任意页数级别"。
论文地址:arXiv:2606.23050
GitHub 仓库:github.com/baidu/Unlimited-OCR
模型权重:Hugging Face - baidu/Unlimited-OCR-2
核心亮点
1. 任意页数文档解析,真正的"页数自由"
这是 Unlimited OCR 2 最炸裂的能力。传统 OCR 处理长文档要么分页拼接(丢失跨页关联),要么在上下文窗口里硬塞(到上限就崩)。Unlimited OCR 2 通过 SR-SWA 机制,让模型的单步解码延迟和内存占用几乎不随文档长度增长——你喂 10 页和喂 1000 页,显存占用基本是同一量级。
2. 百页级文档解码速度 7 倍于 Full Attention
SR-SWA 借鉴的是人类读书时的注意力模式:你翻到第 50 页,通常只需要关注当前页和前后几页,不会每次都把前 49 页重新读一遍。模型也是同理——页面门控先把视觉参考范围从整个文档缩小到相关页面,Token 桶再从中提取得分最高的关键信息。
实测数据:在百页文档场景中,SR-SWA 的单步解码速度相比标准 Full Attention 快 7 倍,相比上一代 R-SWA 快 5.6 倍。
3. 两大权威基准测试同时拿第一
这是业内公认的两个长文档解析评测集,尤其 MarathonDocBench,之前几乎没有模型能完整跑完。
- MPDocBench(多页文档解析):84.6 分,大幅领先 Qwen、Gemini、GLM、DeepSeek 等主流模型。
- MarathonDocBench(百页级超长文档):77.1 分,目前唯一能在这个测试上保持高精度的端到端模型。
4. 恒定 KV Cache,部署零负担
第一代 Unlimited OCR 就实现了恒定 KV Cache,第二代在 SR-SWA 架构下进一步优化。这意味着无论你解析 10 页还是 1000 页,模型的显存占用始终稳定在一个固定值,不会出现"文档越长越吃显存"的线性爆炸。
对于企业级部署来说,这比单纯的精度提升更重要——你的 GPU 资源可以精确预估,不需要为了极端情况过度配置。
功能特性
- 多页文档一次性解析:把一份文档的所有页面图片按顺序传给模型,一次性拿到完整的结构化输出。模型内部会自动处理跨页内容的关联。
- 单页高精度解析:单页场景下,模型默认使用"高达模式"(dynamic tiling),把一张复杂页面拆成多个区域分别分析再整合,特别适合那种排版复杂、图文混排、表格密集的页面。
- PDF 直接转写:配合 PyMuPDF,一条命令就能把整个 PDF 转成 Markdown 格式的结构化文本,表格、公式、图片位置标注都能保留。
- 三种推理后端支持:Transformers(原生快速测试)、SGLang(生产环境推荐)、vLLM(已适配)。
- 训练支持:支持 ms-swift 进行微调训练,已在百度智能云、百度 AI 开放平台上线。
快速上手
安装依赖:
pip install torch==2.13.0 torchvision pillow \
    transformers==4.52.1 huggingface-hub==0.36.0 \
    tokenizers==0.21.4 addict==2.4.0 einops==0.8.2 easydict==1.13
加载模型并推理:
import torch
from transformers import AutoModel, AutoTokenizer

model = AutoModel.from_pretrained("baidu/Unlimited-OCR-2", trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained("baidu/Unlimited-OCR-2", trust_remote_code=True)
写在最后
长文档解析的瓶颈,不一定靠堆更大的模型来解决。
用更好的注意力设计,在现有 3B 参数规模上就能做到任意页数、恒定显存。
这个思路不止能用到 OCR——ASR、机器翻译、代码生成,凡是涉及"长序列解析"的场景,都能从中获得启发。