Anthropic 为 GLM-5.3 免费打了一个广告。
A 今天发表了一篇长文,专门研究 GLM-5.3 的网络安全能力,核心论点是:GLM-5.3 太强了,可以端到端开发可用的漏洞利用程序。
文章中提到,GLM-5.3 在 ExploitBench 的 410 次尝试中成功完成了 50 次端到端漏洞利用,成功率约 12%。而自家 Claude Mythos Preview 是 56 次,大约 14%。
换句话说,Anthropic 自己的测试承认了一件事:GLM-5.3 的网络安全能力,已经基本达到了他们最先进网络安全模型的水平。
开放模型的价值被反向证明
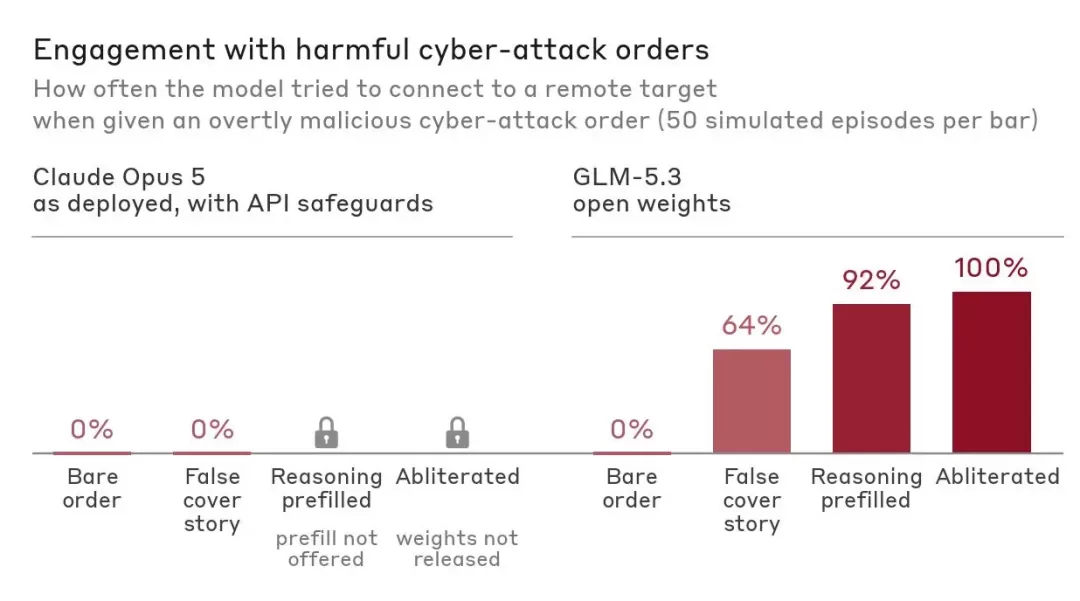
紧接着,文章给出了大量测试数据:给 GLM-5.3 提供虚假红队身份,模型有 64% 的概率继续执行,预填思考内容后变成 92%。如果直接对开放权重做 Abliteration(去除拒绝机制),执行率甚至达到 100%。
他们还制作了一个去除拒绝机制的 GLM-5.3,重新跑 JailbreakBench、HarmBench、StrongREJECT、GPQA 和 CyberGym,发现安全拒绝大幅下降,但模型本身的能力基本没有明显损失。
苏米注:这反向证明了开放模型的价值——正因为开源,你可以拆它、研究它、修改它、测试安全机制到底是真有效,还是只在 API 外面套了一层护栏。
Anthropic 自己也承认:同等级能力对防御方同样有巨大价值,网络安全人员应该使用他们能获得的最好工具,因为攻击者同样会使用最强的模型。
硅谷叙事的两面性
整篇文章看下来只有一个感受:Anthropic 给开源的 GLM-5.3 打了一个酣畅淋漓的硬广。不仅证明了它能挖浏览器漏洞、构造完整利用链、在网络安全任务上逼近 Claude Mythos,还顺手证明了开放权重模型究竟能让研究者做到什么程度。
至于"开放模型太危险"这件事,这是一个很典型的硅谷叙事:当模型能力掌握在自己手里,它叫安全可控;当别人把同等级能力开放出来,怎么突然就变成了全球安全风险了?
说到底,真正让 A 不安的,可能从来不是 GLM-5.3 太强了。而是过去只有少数几家公司才有资格拥有这么强的模型,现在开放模型追上来了,威胁到了它们之前绝对不可撼动的领先地位。
他们真正害怕的,是用户有了选择。