大模型做选择题时,如果让它生成JSON再解析出概率,数字可能是编的,格式崩一次就得重来。LLM2Jev把这条链路整个换掉了——让本地LLM/VLM做一次prefill,不生成任何token,直接从最后一层logits读出yes/no两个数,归一化成概率。
文本和图片都能处理,零训练零微调,Apache-2.0协议,v0.2.0已于10月16日发布。
LLM2Jev是什么
LLM2Jev不是模型,而是调用层。你手上有什么模型权重,它拿什么,一个参数不改。它的任务很明确:把LLM里原本用来生成文字的next-token预测器,改用来读出决策概率。
模型内部有一张150,000列的打分表(lm_head),每列对应词汇表里的一个token。LLM2Jev在这张表写完后停住,不采样,只取"yes"和"no"两列的分数,算一次softmax。
支持SGLang、Transformers、MLX三套后端,覆盖NVIDIA GPU到Apple Silicon全平台。
生成式vs直读式
以客服系统场景为例:收到"My card was charged twice.",要判断转给shipping、billing、returns哪个部门。
生成式做法:问题+选项+格式要求写成prompt,模型开始生成,假设答案50个token,就是50轮串行前向。
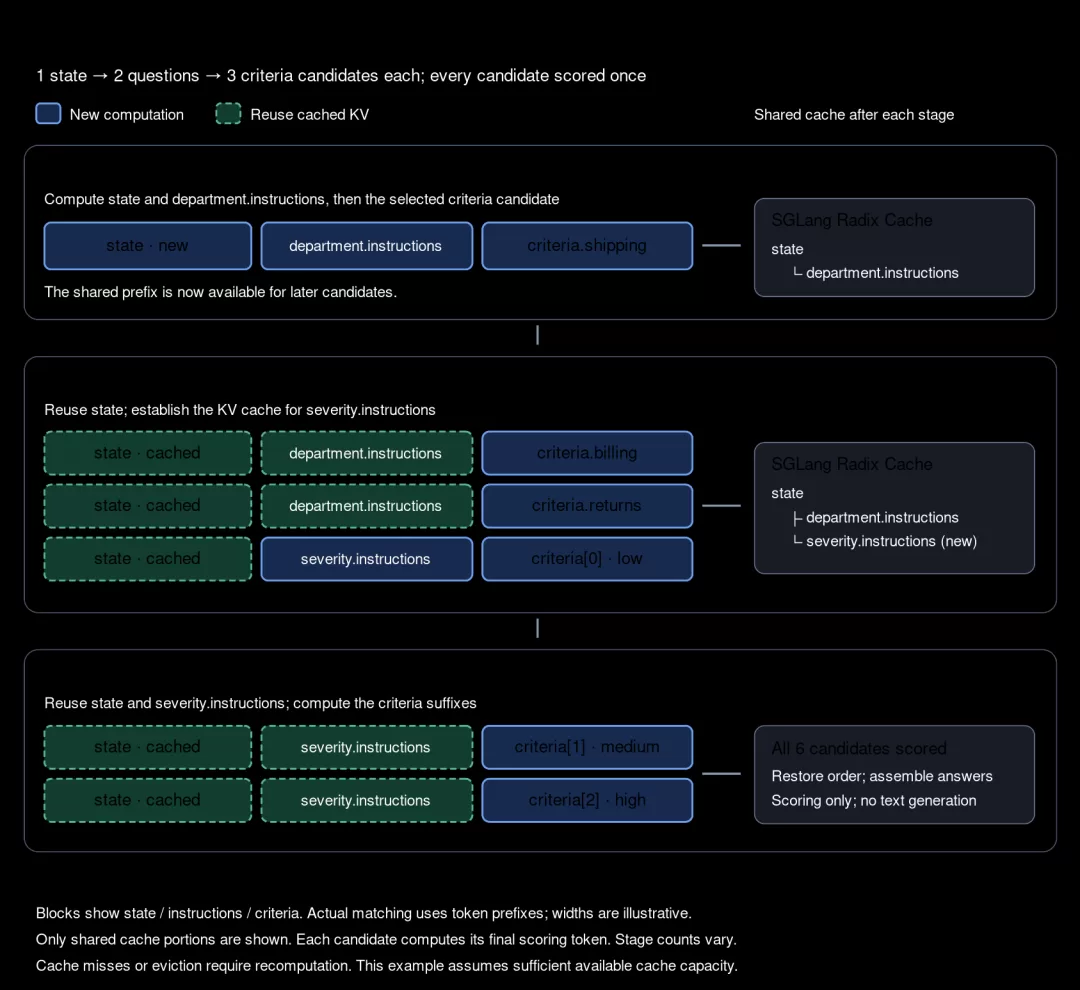
LLM2Jev做法:把3个选项各拆成一道是非题,"Is billing the best department?"喂进去,prefill完读logits里yes和no两列的分数做归一化。3道题并行发,公共前缀只算一次。
| 维度 | 生成式 | LLM2Jev直读式 |
|---|---|---|
| 解码 | 串行50轮,每轮完整前向 | 0轮,只读2个数 |
| 数字来源 | 模型"写出来"的文字,可能加和≠1 | 代码归一化,严格=1 |
| 格式风险 | JSON缺引号、漏字段都得兜底 | 无,只读logits列 |
| 多选项扩展 | 选项越多,解码越长 | 选项越多,并行越划算 |
共享前缀分阶段打分架构:第一条候选建立Radix Cache,后续候选复用公共段,只补差异后缀。
四种题型
v0.2.0新增了Box类型,现在一次请求能混着出四种结果:
- Choice:多选题,每个候选独立打分,代码归一化成概率分布。
- Score:打分题,1-10分,读对应数字token的logits。
- Noul:是非题,两个选项,最干净的二选一。
- Box:图像定位,Qwen-VL原生0-1000归一化坐标格式,四个整数。这是四种里唯一的"真生成"——坐标是连续值,词汇表里没有现成列可查,只能让模型生成bbox_2d坐标。
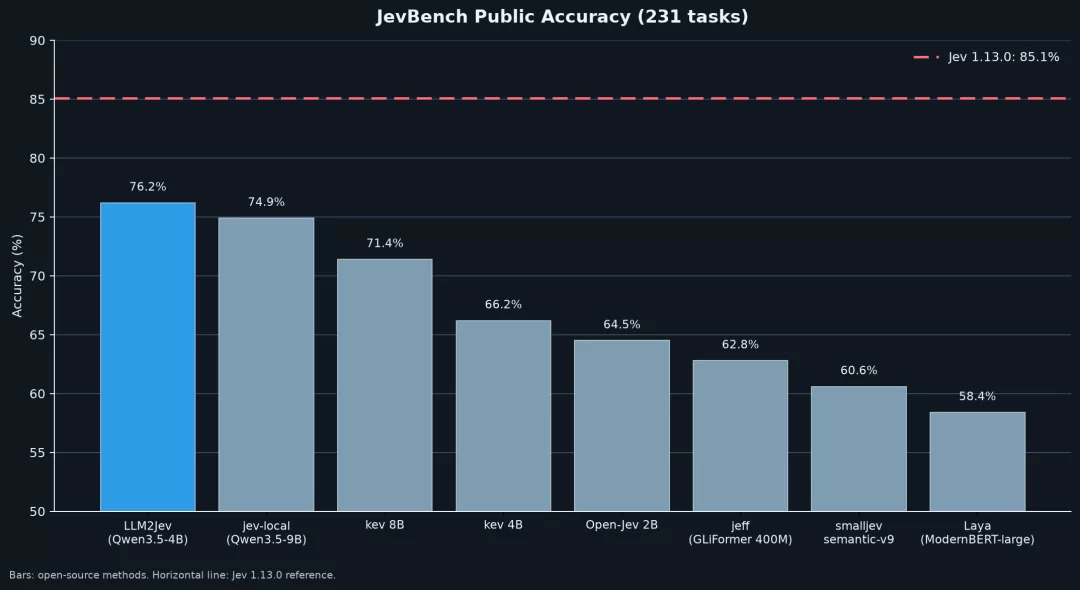
官方JevBench测试,231题,P50延迟约为原生Jev官方API路径的1/10以下,准确率基本持平。
快速上手
git clone https://github.com/Yinsongxu/LLM2Jev.git
cd LLM2Jev
uv sync --extra sglang
三套后端各管一摊:
- SGLang:NVIDIA GPU,性能最猛,带Radix Cache共享前缀
- Transformers:PyTorch生态通用
- MLX:Apple Silicon专属,M系列芯片直接跑
llm2jev-serve --backend sglang \
  --model-path /path/to/your/model \
  --served-model-name local-model \
  --host 127.0.0.1 --port 30000
Python调用示例:
from llm2jev import Client, Choice

client = Client(base_url="http://localhost:30000/v1", api_key="unused")

decision = client.systemone.create(
    model="local-model",
    state="My card was charged twice.",
    questions={"dept": Choice(criteria={
        "billing": "Charges and billing",
        "shipping": "Delivery",
    })},
)
print(decision.choices["dept"].probabilities)多模态同理,state里放type: "multimodal"的content数组,文字和image_url混着塞,模型自带视觉编码器处理,无需额外训练视觉对齐。
适用场景与局限
适合:手里有本地模型,要做分类、打分、是非题的Agent或工作流,不想为每个任务花钱微调。
局限:Box依赖Qwen-VL系模型的坐标格式,换别的视觉模型需自行适配prompt。
苏米注:LLM最会干的事是猜下一个词,LLM2Jev把它从"写答案"改成了"读答案"。这个思路值得学习——把昂贵的生成操作替换为一次性的前向+查表,复杂度从O(N)降到O(1)。