这两天 AI 圈子格外热闹,各大科技巨头都各自放出了大招。
首先是 OpenAI 发布新一代图像生成模型 Images 2.6,图像生成速度和一致性都有极大提升。
最大更新是:可以做 GIF 动图,只发一句提示词就行,也可以拿一张现成的图让它动起来。
做出来的图还能再继续改,调一下快慢,或者单独改某一帧都可以。

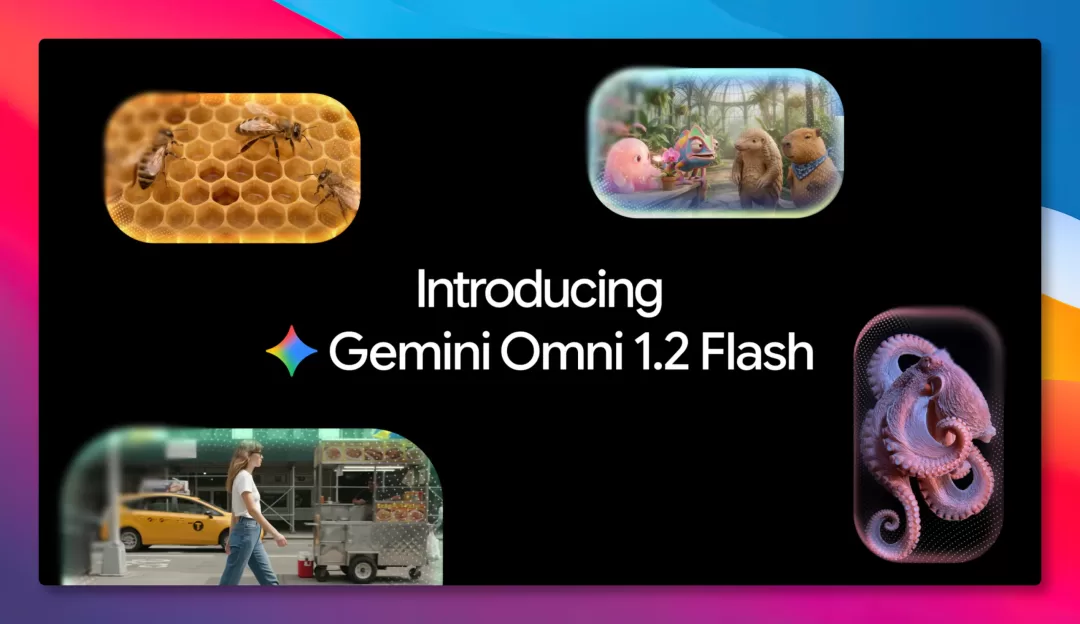
另一个是 Google 发布的 Gemini Omni 1.2 Flash,一次最长可生成 15 秒视频。而且 720p 视频的价格降到了每秒 0.07 美元,比上一代便宜了 30%。
模型是越来越好用了,不过这些内容都要靠模型一次次生成出来,用得多了也是一笔不小的开销。而且模型每次画出来的东西都会有些差别,想做一整套风格统一的配图还得花不少时间去调。
正好在 GitHub 上翻到了一个思路相反的开源项目:anidoodle。

它不调用图像和视频模型,而是让 Claude Code、Codex 这类 Agent 通过代码的方式把画面一笔一笔画出来。插画、动图、短片、讲解视频,还有能跟鼠标互动的网页它都能做,并且有 32 种风格可以挑。
生图模型交给我们的是一张图片,而 anidoodle 留下来的则是一段代码程序。同一份代码换台机器、换个尺寸再跑一遍,画出来的还是同一张图。
官方拿一部 47 秒的短片来举例,总共 1410 帧画面,加上一整段立体声配乐,都是由一个程序生成的。按项目的说法,这个程序写一次,折算下来每帧大约花 60 个 Token,之后再渲染就不用花 Token 了。
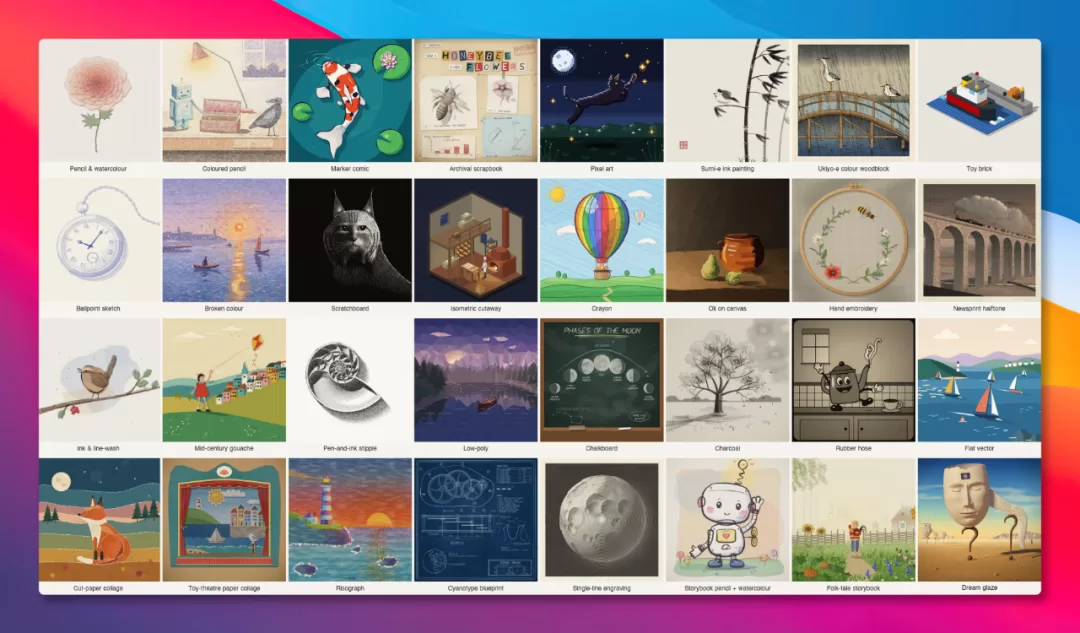
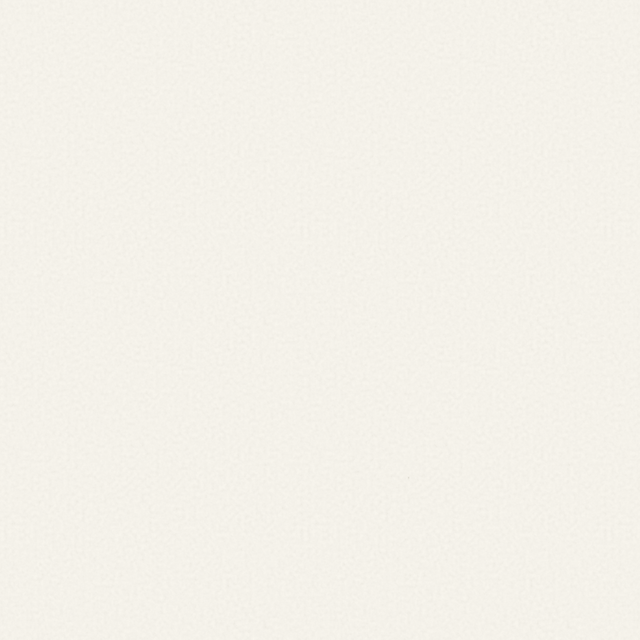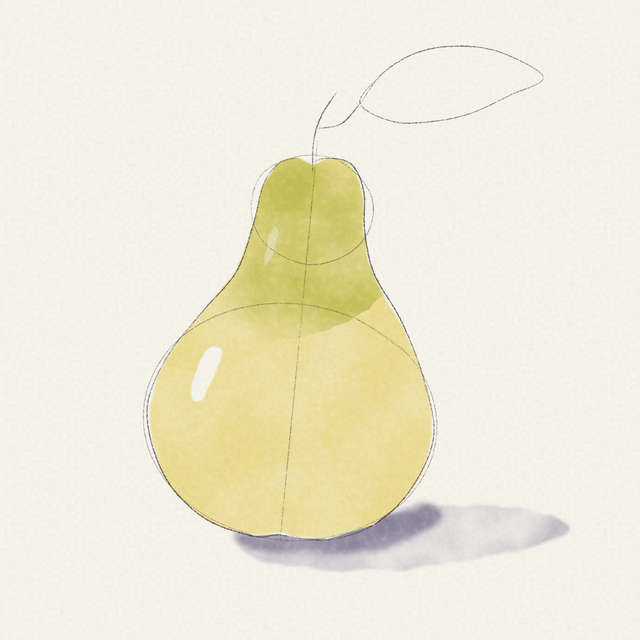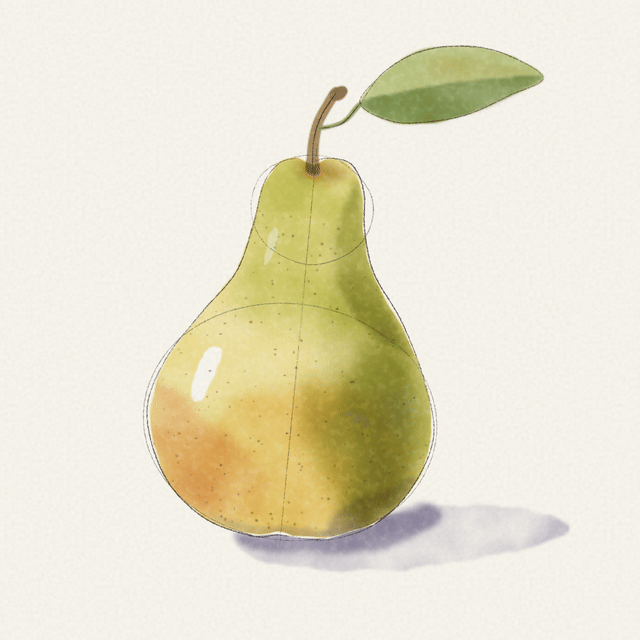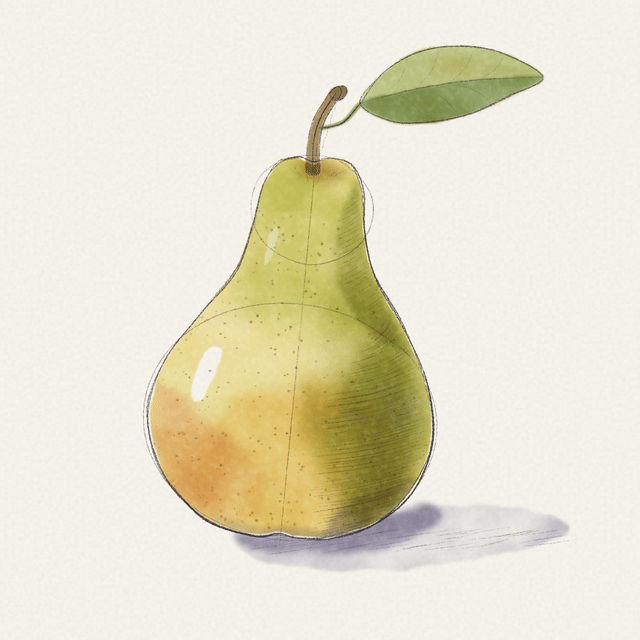
32 种风格里,铅笔、水彩、粉笔、浮世绘和像素画这些都有,连刺绣、玩具积木也能画出来。每种风格都带了一段作画过程的短片,而且是按这种画法本来的顺序来画。比如水彩会先打铅笔稿再从浅到深铺色,木刻则是先印主版再一层层印上色版。笔画都是一道道长出来的,没有用淡入效果糊弄过去。
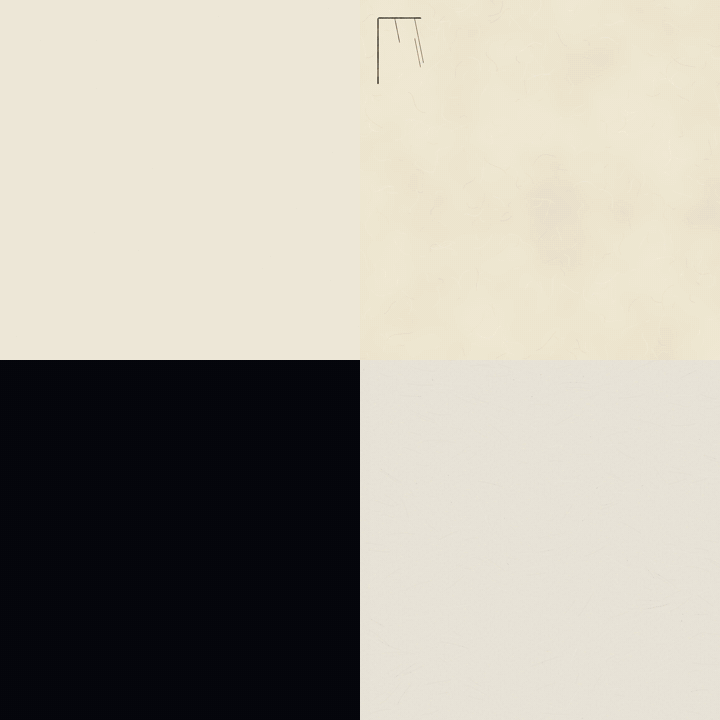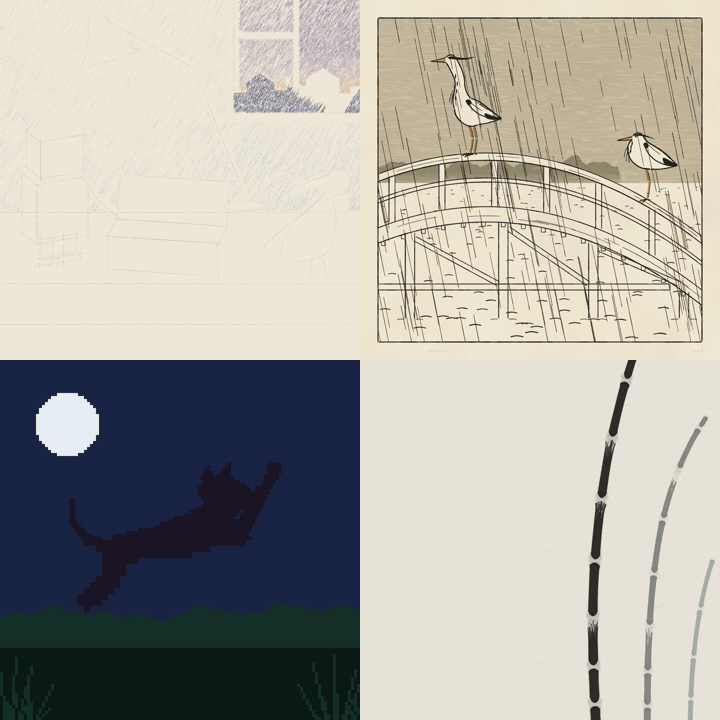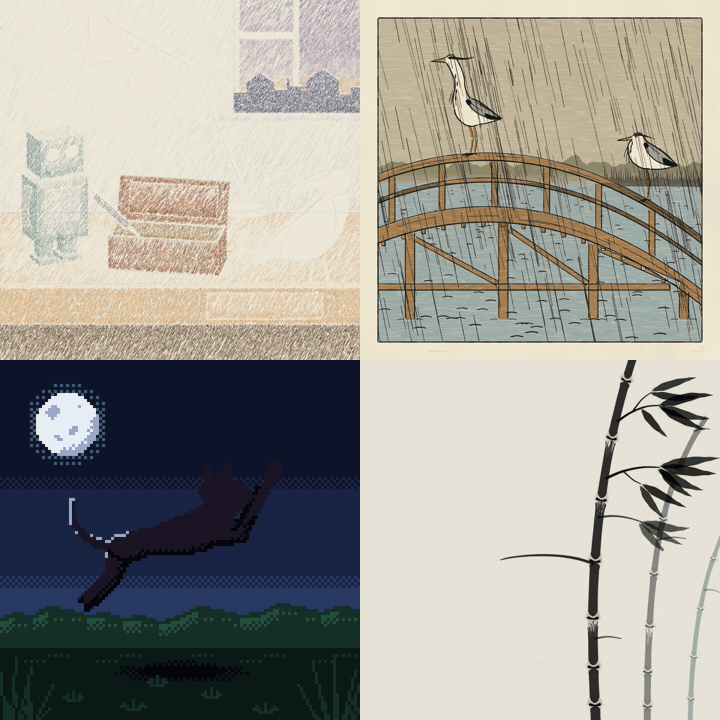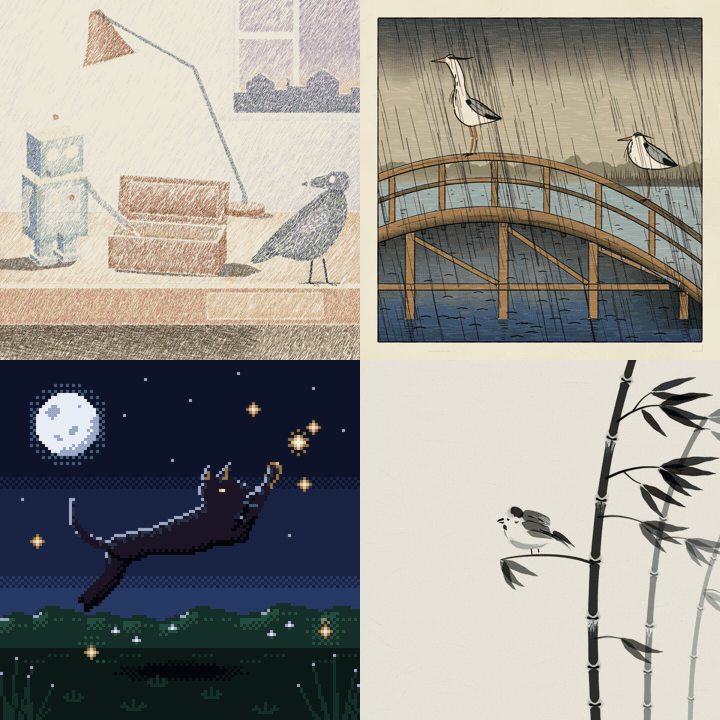
如果问它某样东西怎么画,它还能拆成一堂课,给出分步图和带字幕的延时视频,每一步告诉我们该观察什么、容易犯什么错。
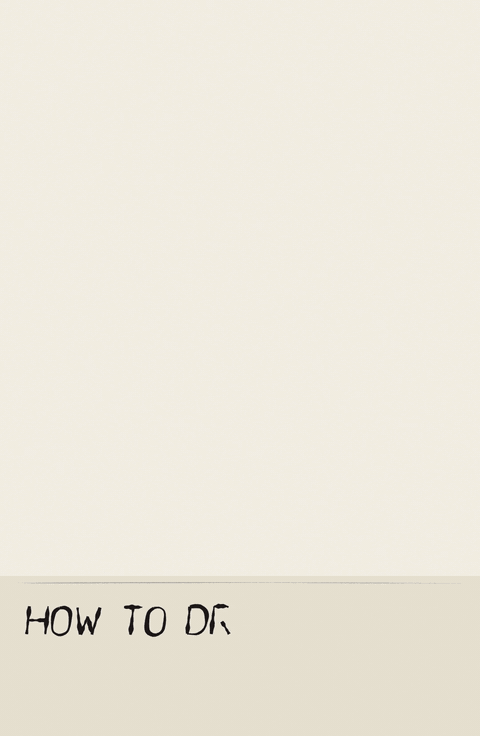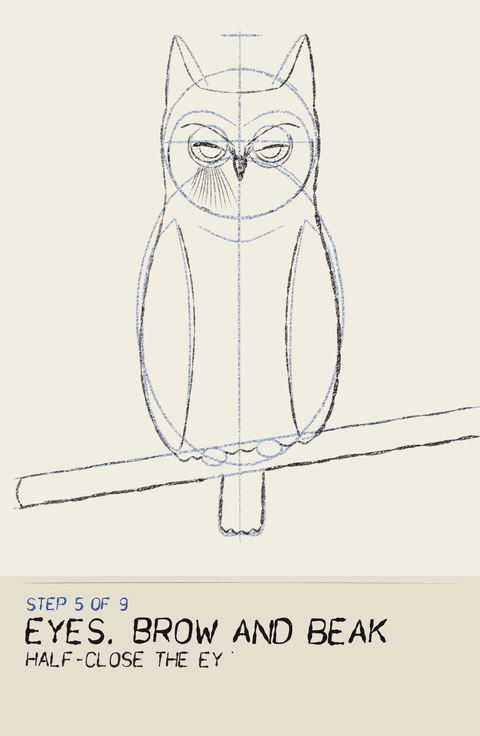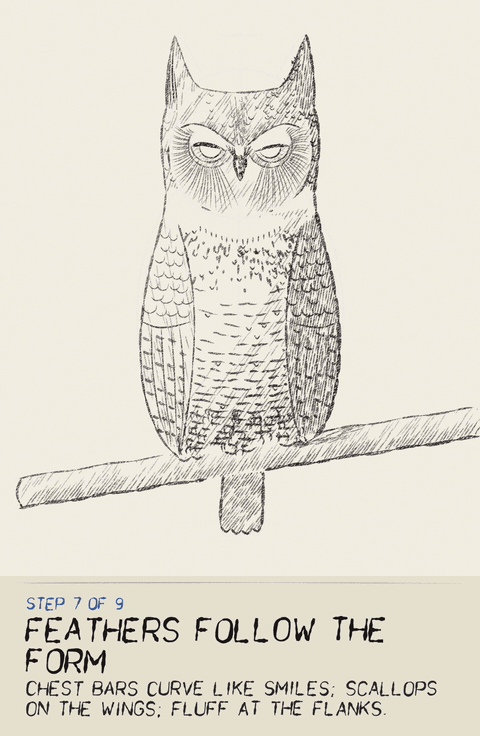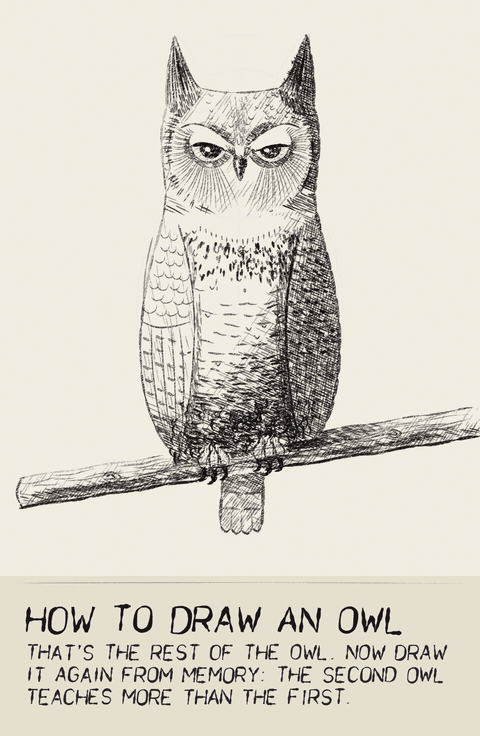
做好的作品也不用为了不同的场景重新做一遍,同一份源码就能导出 PNG、带配乐的 MP4、GIF 和透明背景的 WebM。还能导出一个大约 100 KB 的 HTML 文件,双击就能离线播放,声音也打包在里面。
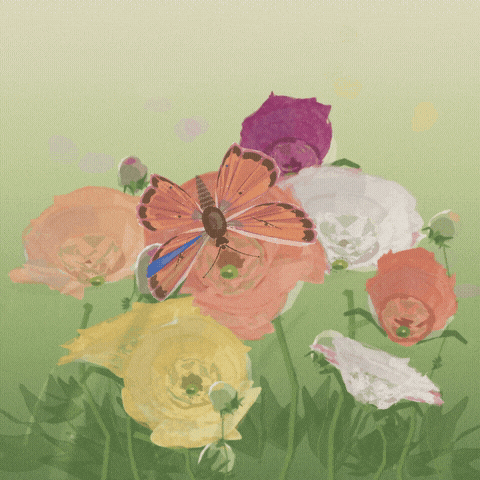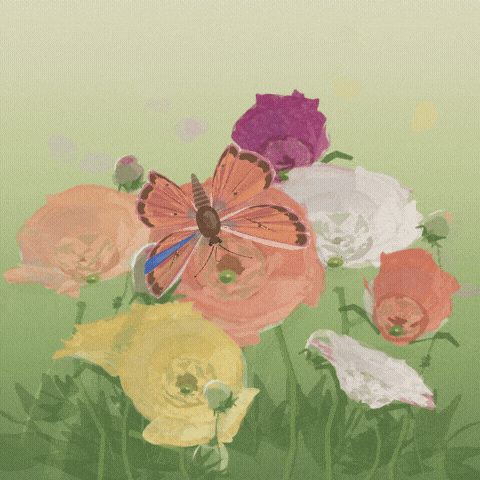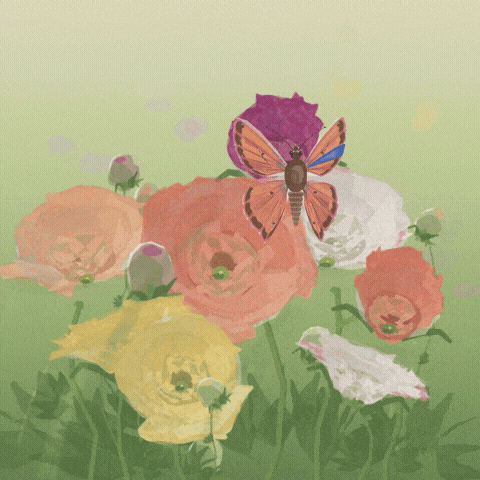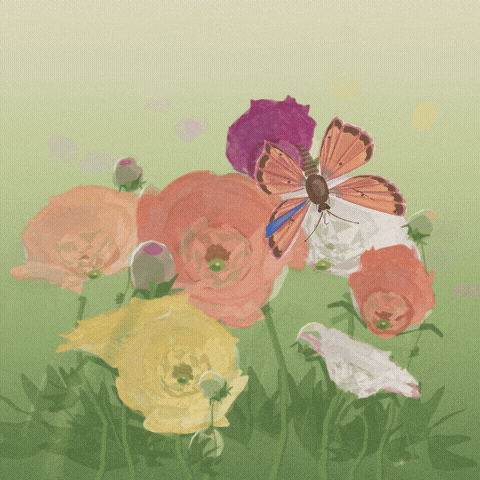
自己手头有喜欢的图也可以丢给它,它会研究笔触、配色和纸张,用同样的画风画新的内容。照片也能重画成刮画、木刻这类风格。同一个角色画好之后,换镜头、换姿势、换风格都还是这个角色。
另外项目还自带一套做产品发布片的工具,填好产品名、提示词和安装命令,就能踩着节拍剪出一支片子。支持输出 16:9、1:1、4:5 和 9:16 四种画面比例。
安装和使用
它本质是一个 Skill,但打包成了插件。想装来使用的话,Claude Code 执行以下命令:
/plugin marketplace add alexgreensh/anidoodle
/plugin install anidoodle@alexgreensh-anidoodle
若是用 Codex 的朋友,先跑以下命令,再到 Codex 里输入 /plugins 把 anidoodle 装上:
codex plugin marketplace add alexgreensh/anidoodle另外电脑上还得有 Node 20 及以上版本,以及用来出图的 Chromium 浏览器。要做动图或视频还要装上 ffmpeg。
总结
想要像照片一样真实的画面或者真人出镜的视频,可以优先考虑 GPT Images、Omni 这些模型。anidoodle 这种做法更适合拿来画网站配图,或者做讲解动画、产品发布片,方便保持风格也方便反复改尺寸。