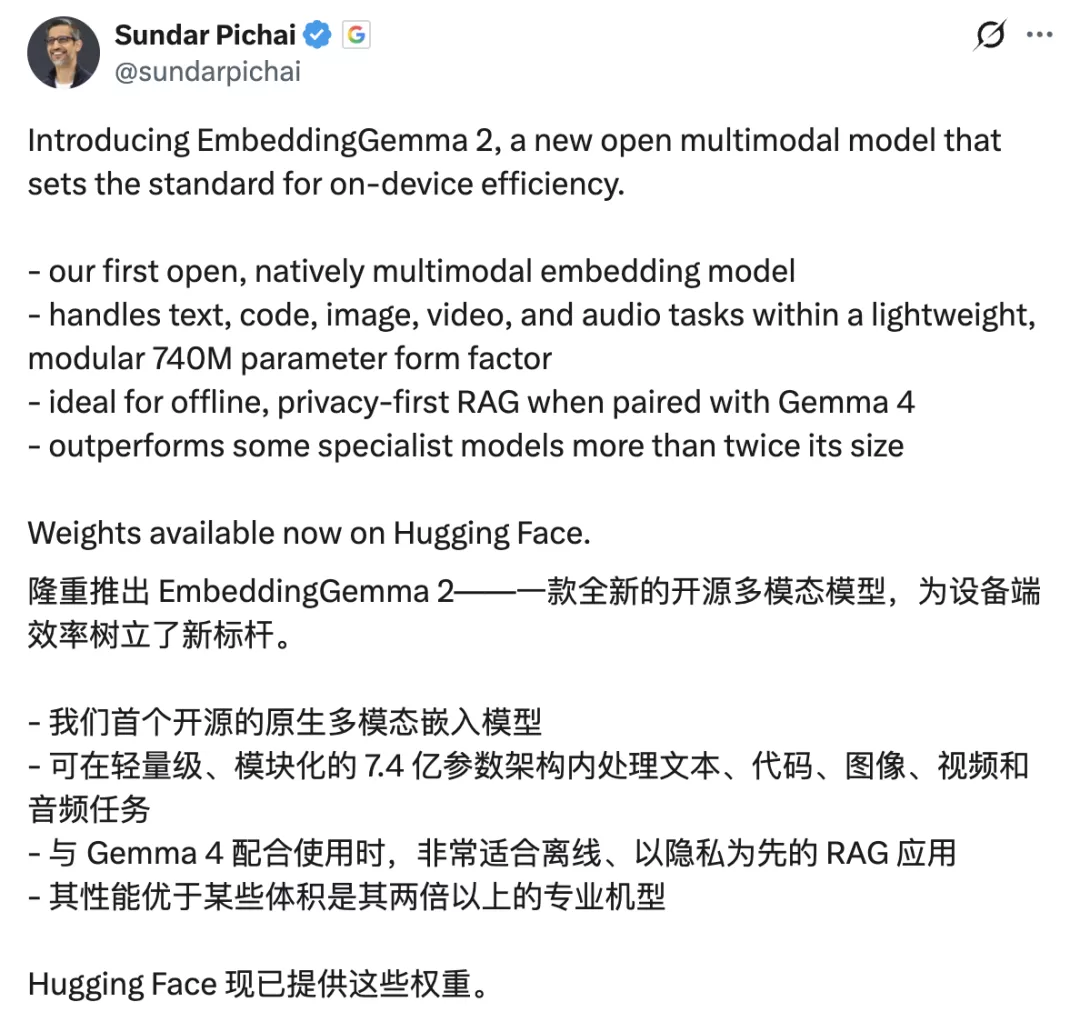
你手机相册里那几千张说好回头再看的照片,这回真有救了。谷歌开源了一个名为 EmbeddingGemma 2 的全模态嵌入模型。照片、截图、视频、录音,你打几个字描述一下,它就能在手机或电脑本地帮你翻出来,全程不用联网。只搜索文字的话,在手机上只占用 191MB 内存。网友评价:"比我微信缓存还小得多。"
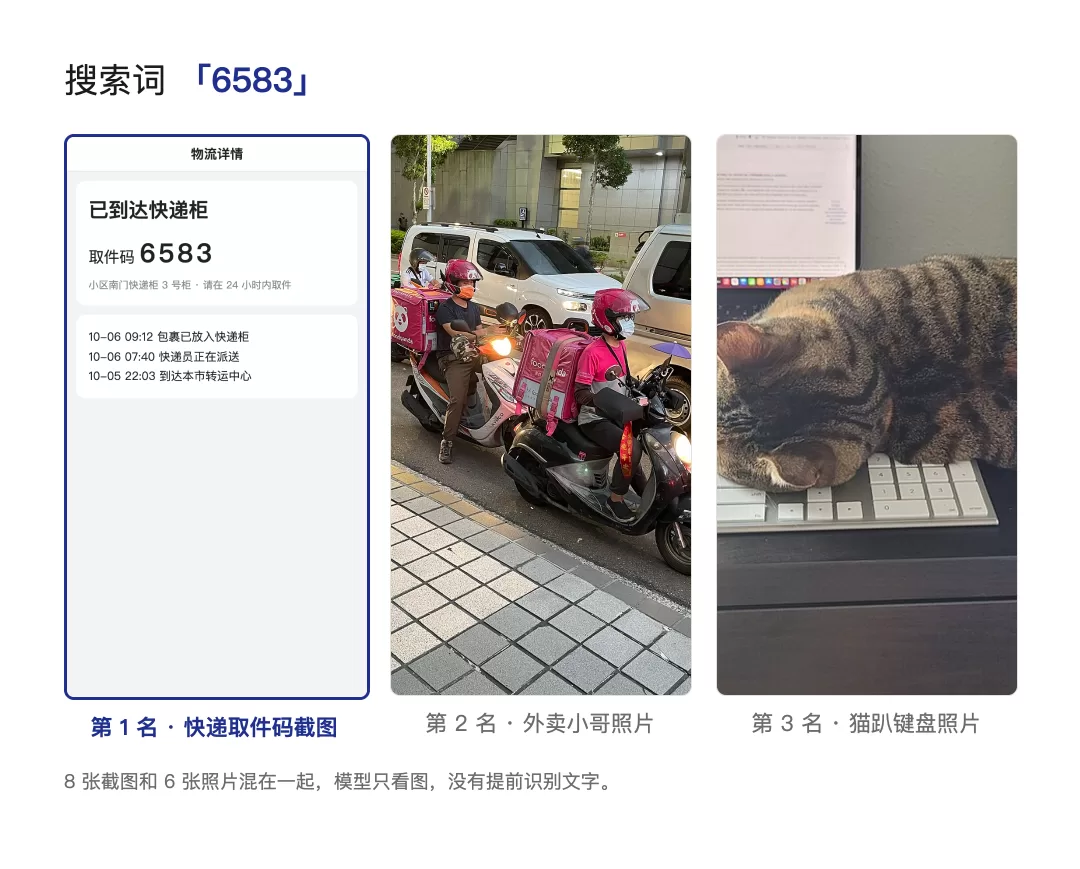
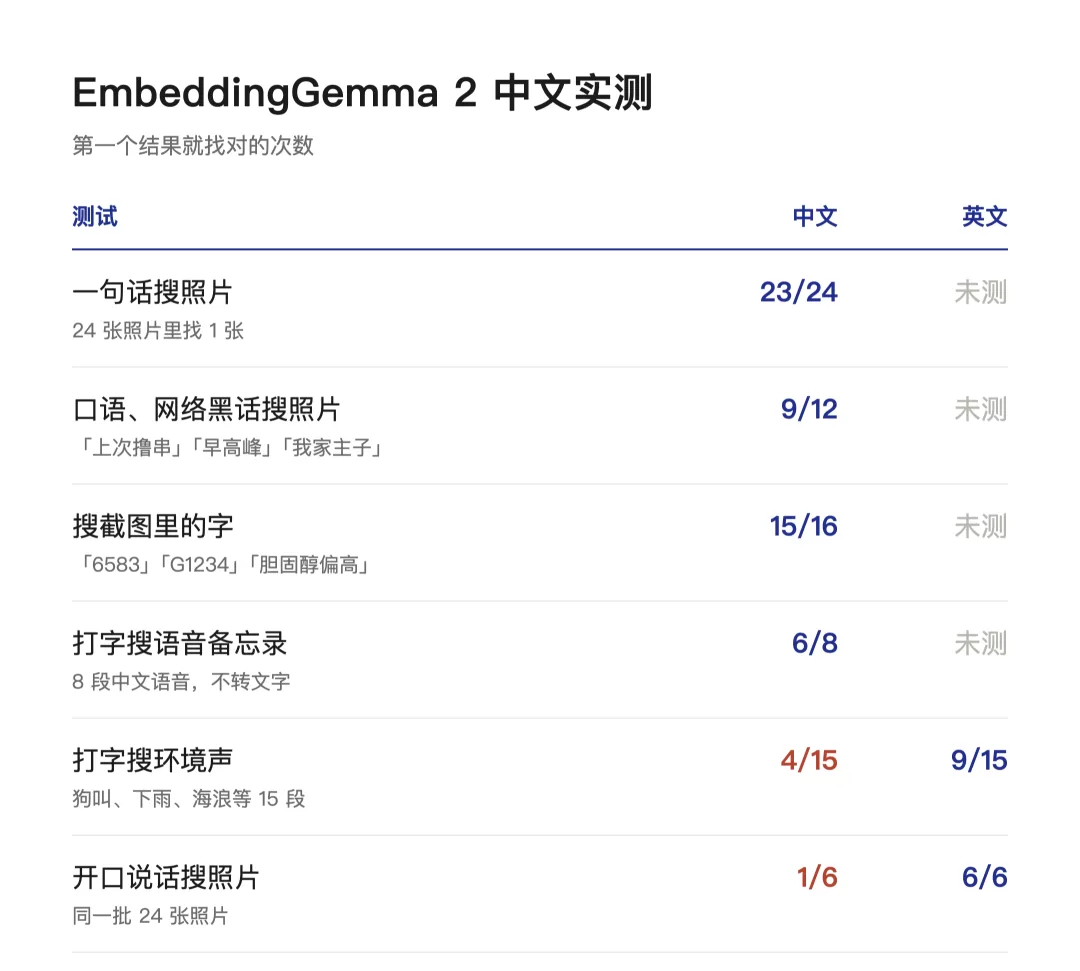
实测中,搜"6583"能从一堆照片里翻出写着取件码的快递截图——它事先根本没把图里的字识别出来,全靠看图。中文语音找图 6 次对了 1 次,眼睛很尖,中文耳朵还不太灵。
全模态嵌入:把五种内容标在同一张地图上
嵌入模型名气没有文本模型那么大,可搜索、推荐、AI 知识库(RAG)背后都得靠它。它干的活儿,是把一段内容变成一串数字,相当于在一张地图上给它标个坐标,语义相近的离得近,不相干的离得远。
以前这张地图基本只认识文字,图片得先配文字说明,录音得先转成文字。EmbeddingGemma 2 把文字、代码、图片、视频、音频全都标在了同一张地图上。
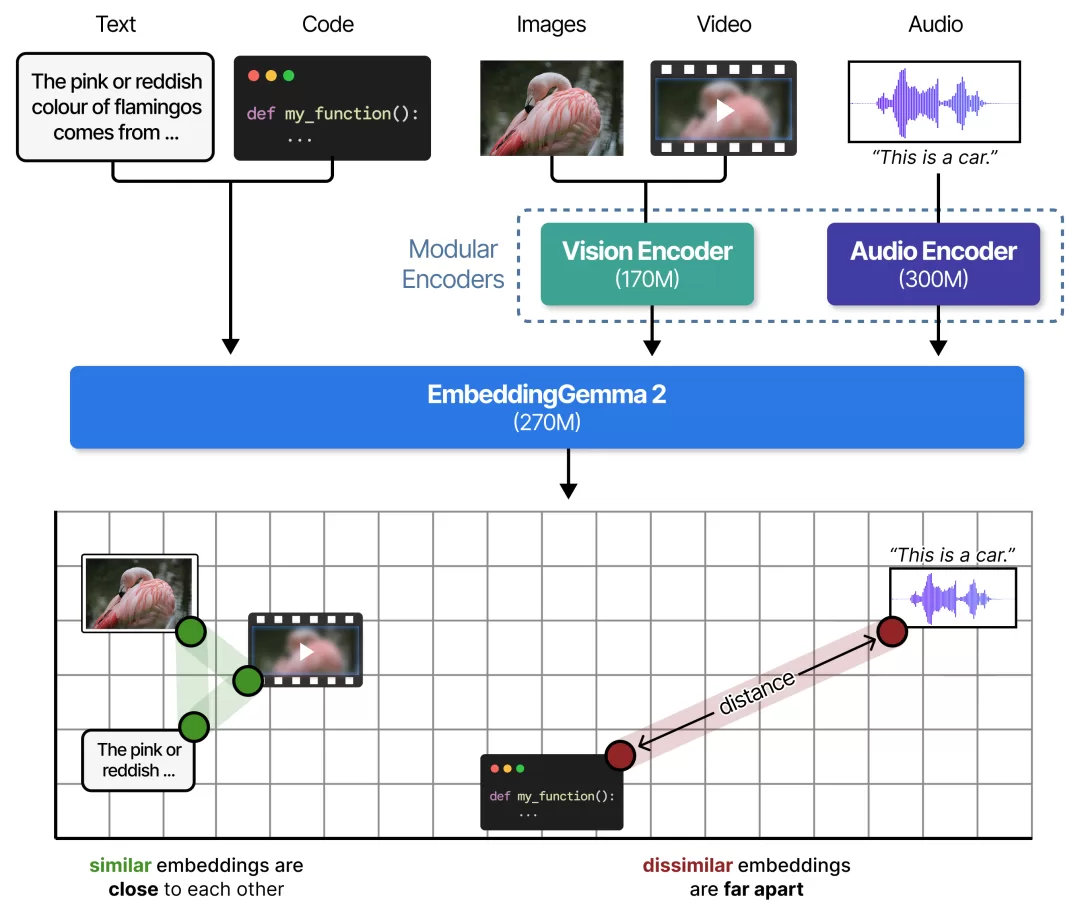
一张火烈鸟的照片、一段火烈鸟的视频、一段解释火烈鸟为什么是粉红色的文字,坐标邻近,你搜其中一个,另外两个也会被带出来。文字描述、代码片段、图片、视频帧、环境声音,全部统一编码,不再需要各自独立的模型。
实测:截图搜索出奇地强
8 张截图和 6 张照片混在一起,16 次搜索有 15 次第一个就对。搜"G1234"找到高铁票,搜"胆固醇偏高"找到体检报告,搜"香山爬山"找到了群聊截图。
音频方面,15 段环境声(狗叫、下雨、海浪、翻书),用英文描述去搜,9 次一遍正确;同样的音频换成中文,就只有 4 次正确。用语音找照片,英文准确率出奇得高,中文依旧稍差。
技术规格
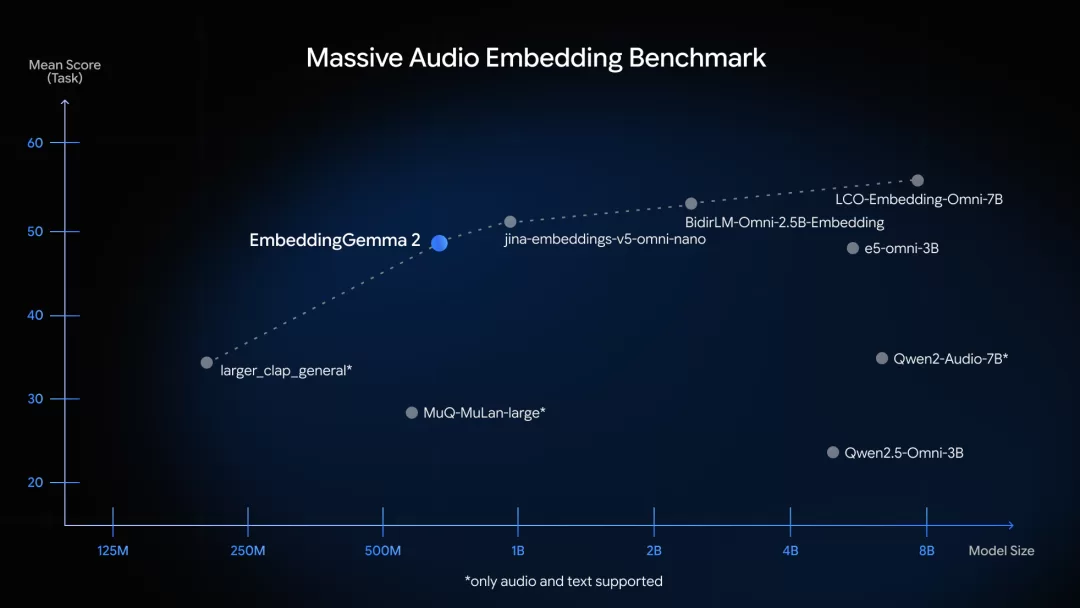
EmbeddingGemma 2 有 7.4 亿参数,在手机端纯文本搜索只需 191MB 内存。它是谷歌首个同时支持文字、图片、视频和音频的统一嵌入模型。支持多语言,包含中英日韩等多种语言,但中文音频和多模态检索能力仍需提升。
应用场景
除了个人相册搜索,EmbeddingGemma 2 还可以用于:
- RAG 知识库:多模态内容统一索引,不再需要分别处理文本和图片
- 推荐系统:跨模态相似度计算,图文音视频统一推荐
- 本地检索:断网可用,完全在端侧运行,不上传数据
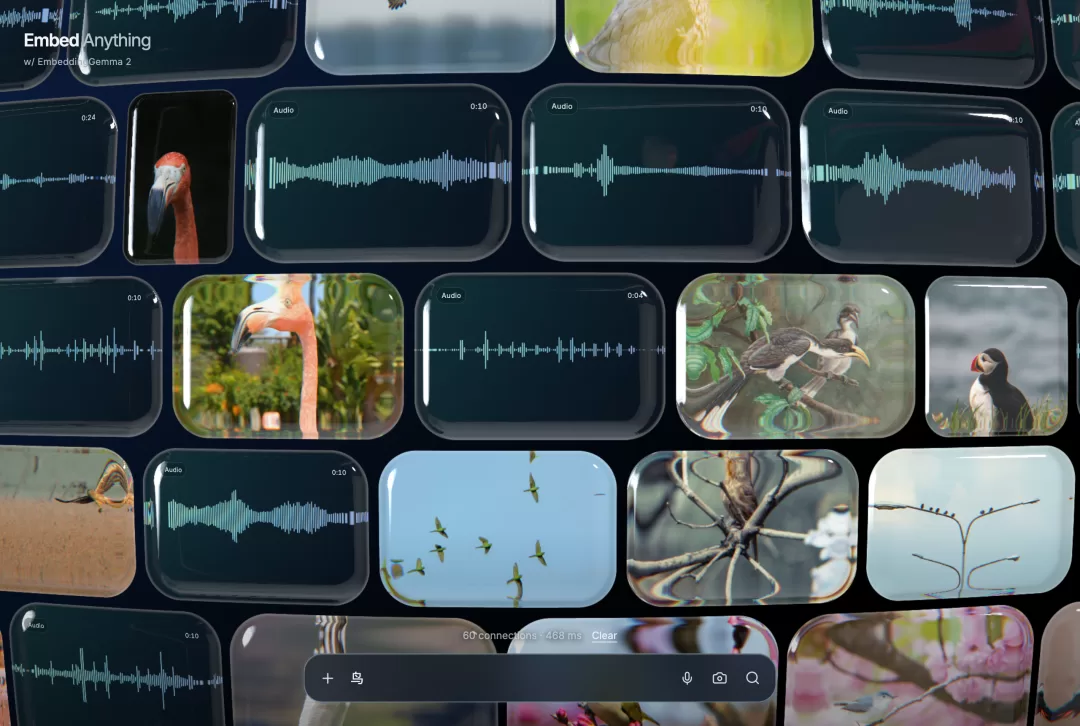
网页演示中,输入中文"鸟",不到半秒屏幕上就排满了各种鸟的照片。虽然中文音频能力还有待提升,但仅文字和图像搜索能力已经非常实用。
EmbeddingGemma 2 的开源意味着开发者可以在本地部署统一的多模态检索系统,无需依赖云端 API。对于重视数据隐私的场景,这是一个很好的选择。