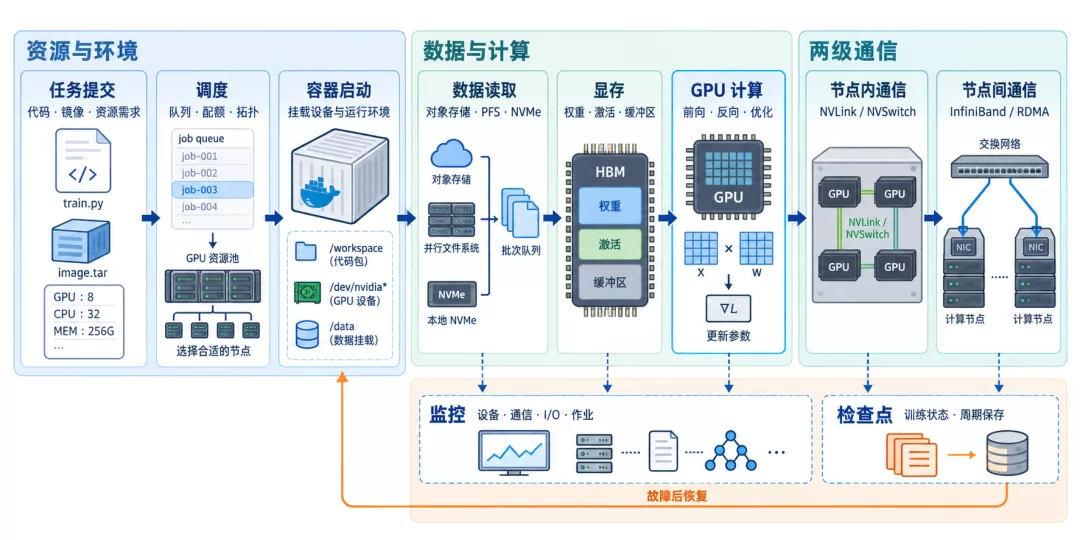
本文聚焦于 AI 算力平台的 8 个核心概念:GPU、显存、NVLink、InfiniBand、调度、存储、容器和监控。沿着一次分布式训练任务的执行过程,读者可以看清这些组件怎样协同工作,并初步判断:训练慢,究竟是卡没算起来,还是整条系统路径中的某一环在拖后腿。
01 GPU:峰值算力不等于训练速度
通俗理解:GPU 像一座同时开着大量生产线的工厂。任务足够并行,数据又能及时送到,生产线才真正忙得起来。
CPU 和 GPU 在硬件设计上各有侧重。CPU 擅长以较低延迟处理复杂控制逻辑;GPU 用大量并行线程换取整体吞吐。神经网络中的矩阵乘法、卷积和 Attention 包含大量重复的张量计算,正适合后者。
在 CUDA 的执行模型里,GPU 由多个 Streaming Multiprocessor(SM)组成,线程以 warp、线程块等形式被调度到 SM 上。Tensor Core 专门加速矩阵乘加,是现代 AI 训练获得高吞吐的重要硬件单元。
FLOPS(每秒浮点运算次数)描述的是理论计算上限。实际任务能跑到多快,还取决于几件更具体的事:
- 算子能否形成足够大的并行工作量
- 张量尺寸、精度和布局是否适合 Tensor Core
- 显存能否及时把数据送到计算单元
- 多卡训练时,其他 GPU 能否及时完成同步
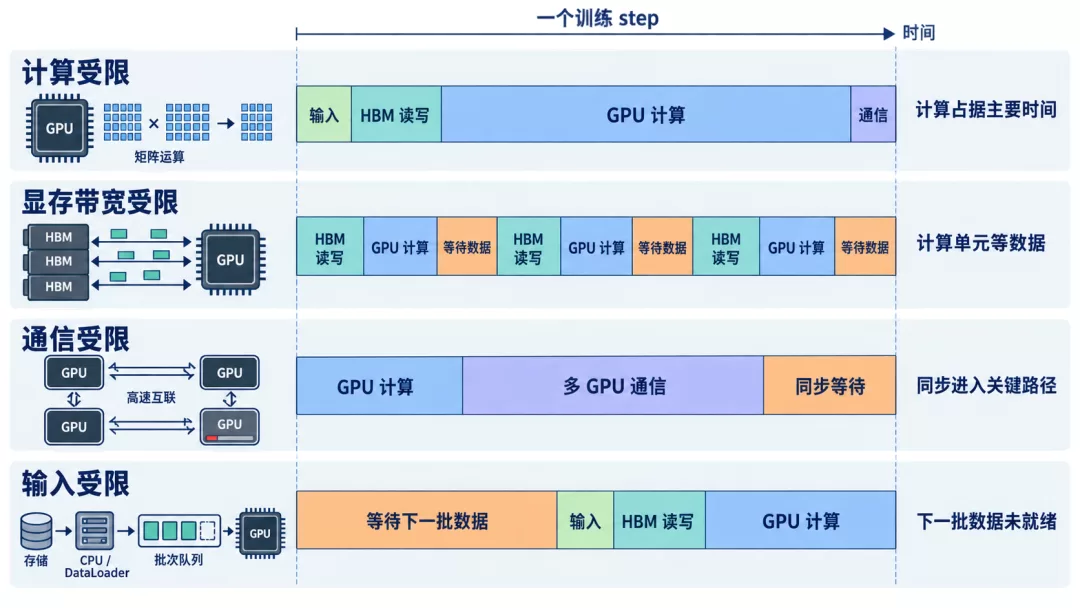
峰值 FLOPS 只是上限。训练单步究竟耗在哪里,要看计算、搬运、通信和输入在时间线中的占比与等待关系。即使所有 GPU 的多卡并行都处在理想状态,模型吞吐、单步耗时,以及计算、通信、输入各自占用的时间,通常更有判断价值。
02 显存:训练时真正"吃"内存的,不只是模型参数
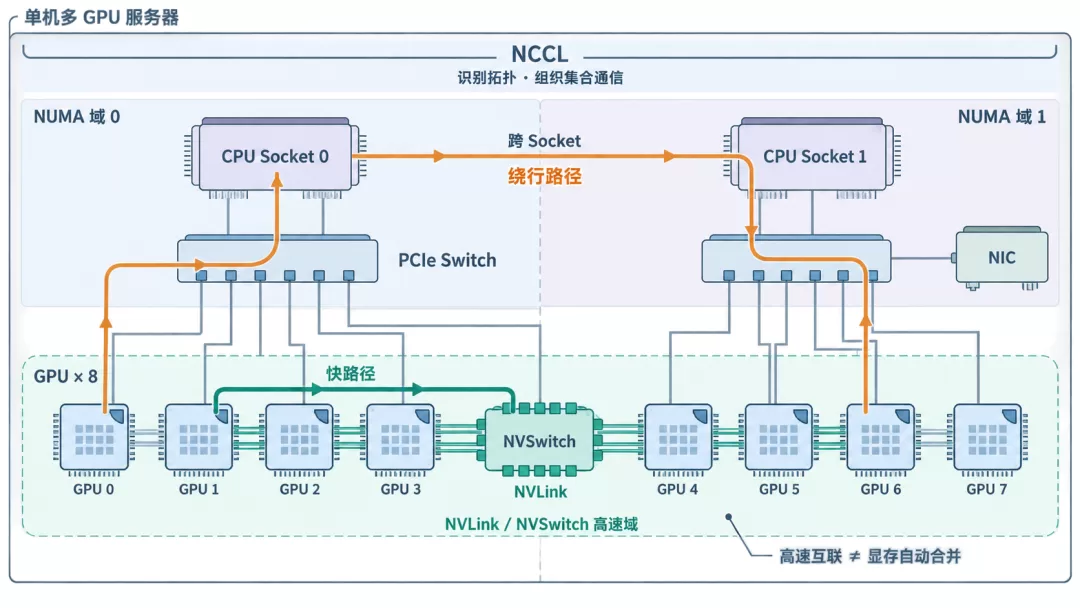
在单机多 GPU 训练中,GPU 之间需要直接通信来同步梯度、广播激活和协调优化步骤。NVIDIA 的 NVLink 和 NVSwitch 提供了远高于 PCIe 的 GPU-GPU 互联带宽,是目前主流选择。
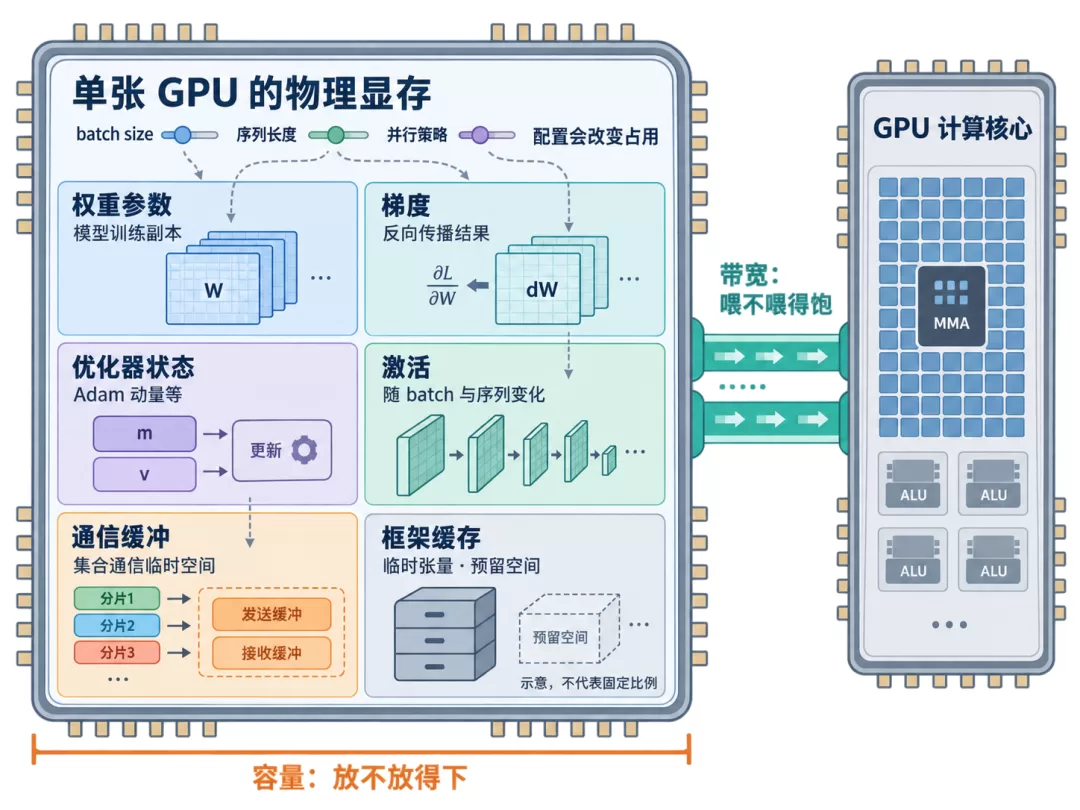
显存不只是装模型参数。训练时需要容纳梯度、优化器状态、激活值、通信缓冲和框架缓存。以 Adam 优化器训练 FP32 模型为例,一份参数对应:FP32 参数(4 字节)+ FP32 梯度(4 字节)+ FP32 一阶矩(4 字节)+ FP32 二阶矩(4 字节)+ FP32 参数副本(4 字节),总计约 20 字节/参数。
03 NVLink:节点内 GPU 互联的高速通道
NVLink 是 NVIDIA 的 GPU 直连技术,用于解决 PCIe 带宽不足的问题。以 H100 为例,单 GPU 配有第四代 NVLink,双向带宽约 900 GB/s。加上 NVSwitch,同一节点内所有 GPU 可以全互联,带宽远高于 PCIe。
但需要注意:GPU 内存访问仍受拓扑、时延、带宽和软件支持限制。训练框架依旧要明确怎样切分模型、放置张量和组织通信。
04 InfiniBand:跨节点 GPU 同步的基石
多机训练时,GPU 之间跨节点通信依赖数据中心网络。InfiniBand(IB) 是目前主流的高性能网络方案,支持 RDMA(远程直接内存访问),让 GPU 直接读写远程内存,绕过 CPU 和操作系统内核。
IB 的关键指标:
- 带宽:NDR InfiniBand 单链路 400 Gbps,SHDR 可达 800 Gbps
- 时延:通常亚微秒级,远低于以太网
- 拥塞控制:自适应路由和无损网络,避免大规模 All-Reduce 时网络拥塞导致 step time 暴涨
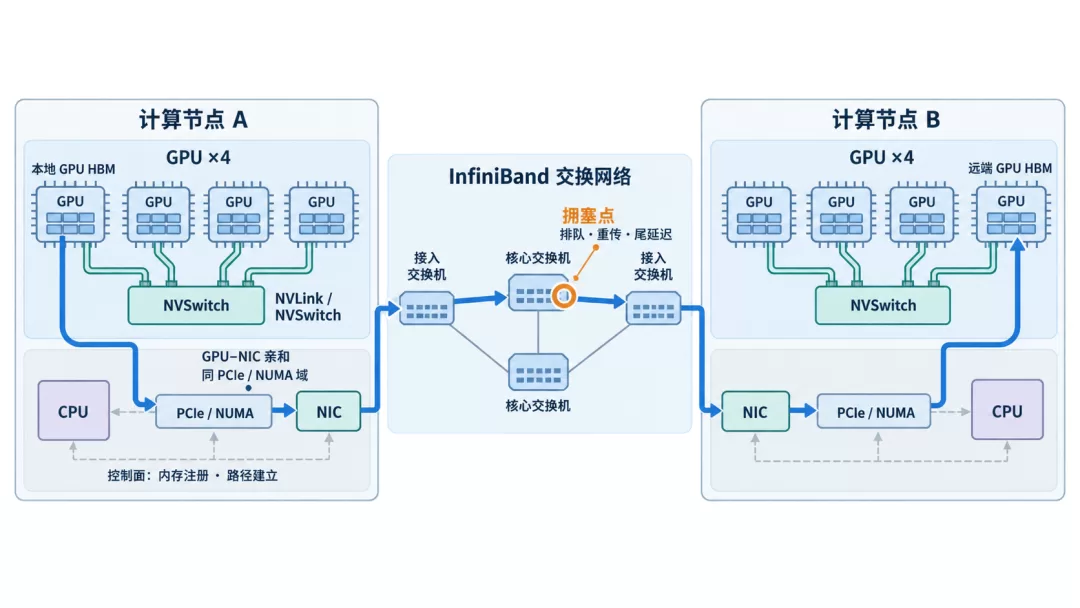
分布式训练要同时经过节点内与节点间两层互联。GPU-NIC 拓扑、RDMA 路径和交换网络拥塞都会影响同步效率。底层网络正常而 NCCL 慢,和 NCCL 正常但模型扩展效率差,是两个层次的问题。
05 调度:把合适的任务放到合适的 GPU 上
调度的核心任务是:既要让任务拿到适合其计算和通信模式的资源,又要控制碎片、排队与相互干扰。
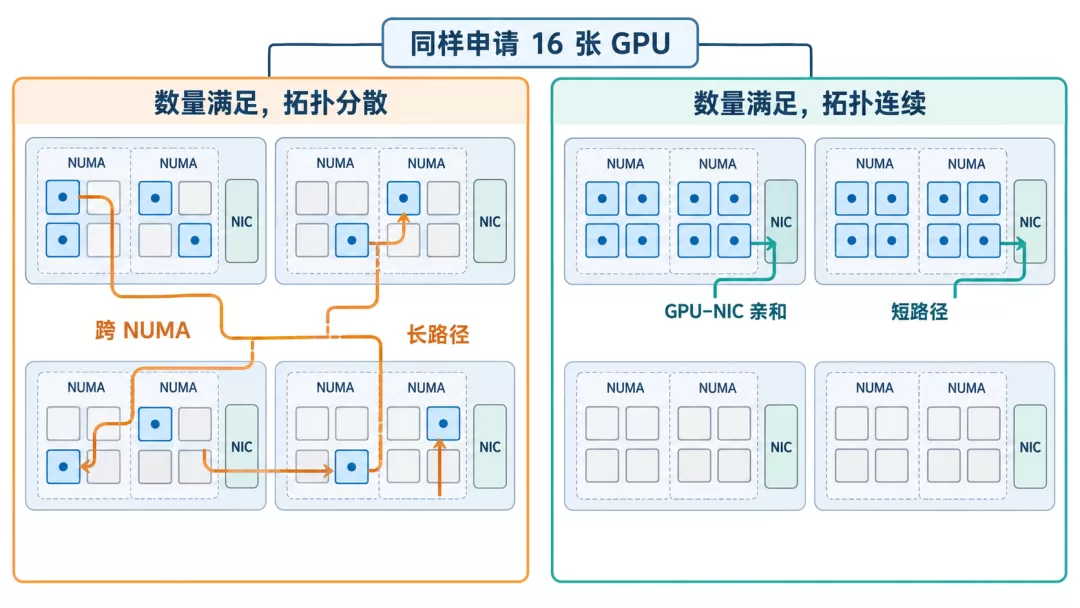
GPU 调度不只是"凑够数量"。好的调度还要考虑:
- 拓扑连续性:尽量选择同一 NVSwitch 域内的 GPU,避免跨 NUMA
- GPU-NIC 亲和性:确保 GPU 与网卡在同一 PCIe 根复合体下
- 碎片控制:避免留下无法使用的小块 GPU 资源
- 干扰隔离:不同任务之间避免显存、网络和 I/O 争抢
06 存储:数据怎么到 GPU,检查点怎么存
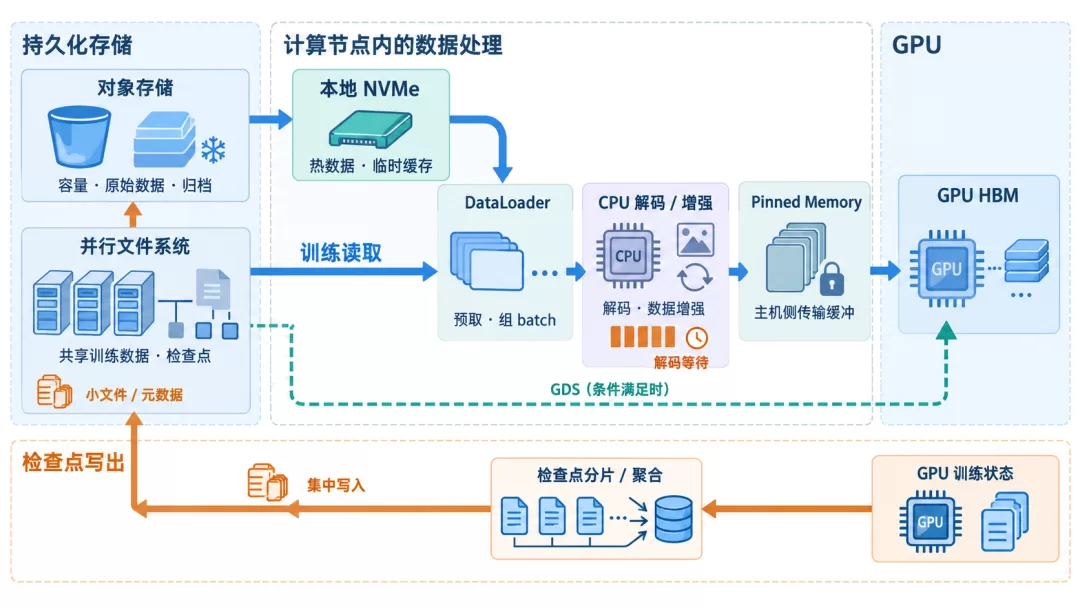
训练数据从持久化存储经过可选缓存、DataLoader 和 CPU 预处理进入 GPU 显存;检查点沿反向路径写回存储。这一路的性能瓶颈可能出现在任何一环。
关键考量:
- 小文件问题:海量小文件的元数据操作是最大瓶颈
- 缓存策略:SSD 缓存或内存缓存可以缓解存储压力
- 检查点吞吐量:大规模训练的检查点可能数百 GB,需要高吞吐并行写入
07 容器:带走的是环境,不是整台机器
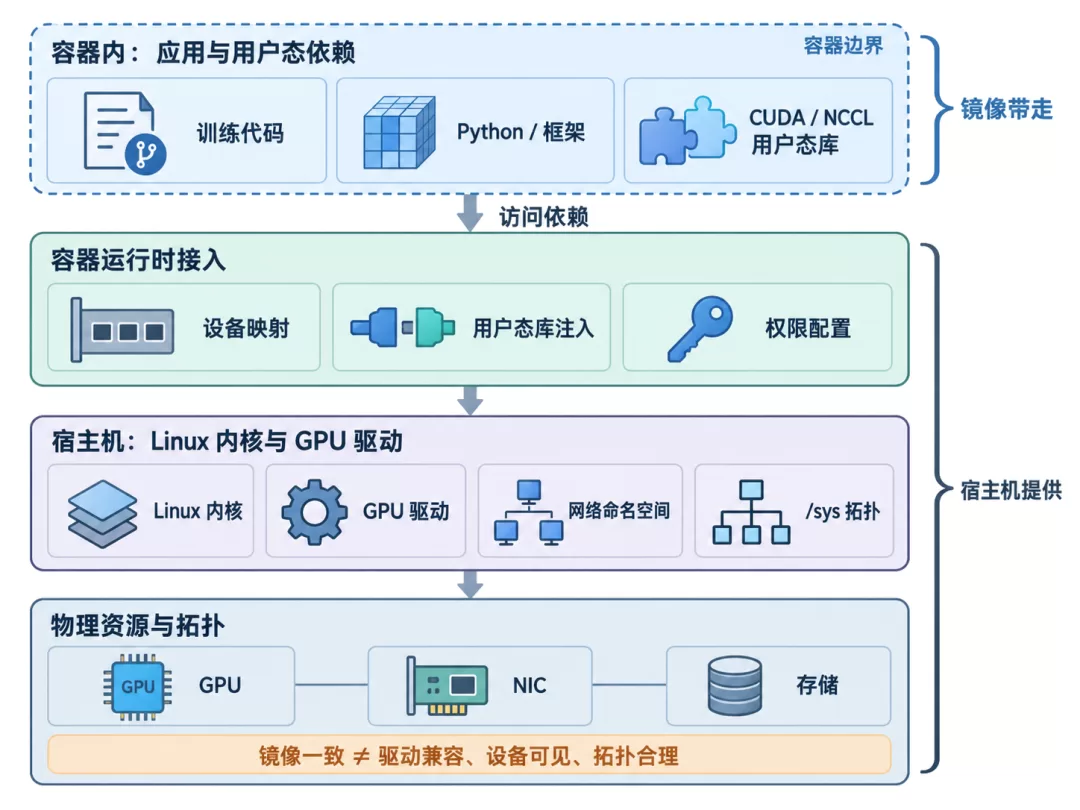
容器化部署让训练环境可复现,但容器带走的是应用环境,不是整台机器。设备映射、驱动兼容、网络能力和硬件拓扑仍取决于宿主机与平台配置。
容器在大规模训练中的挑战:
- 容器镜像在大量节点上同时拉取,可能把镜像仓库和节点网络变成新瓶颈
- 镜像分层复用、节点缓存和预热,是平台工程的一部分
- GPU 驱动需要在宿主机和容器之间正确映射
08 监控:GPU 利用率很高,不等于训练高效
GPU 利用率只是表象。即使 GPU 一直在算,如果吞吐很低,平台仍谈不上高效。比"GPU 忙了多久"更重要的问题是:这些 GPU 时间换来了多少有效训练进展。
五层监控指标体系:
- 作业层:整体进度、吞吐、loss 曲线
- Pod 层:容器级别资源使用情况
- 节点层:主机级 CPU、内存、网络、磁盘
- Rank 层:每个训练 rank 的 GPU 利用率和通信量
- Step 层:单步训练中计算、通信、输入的耗时分解
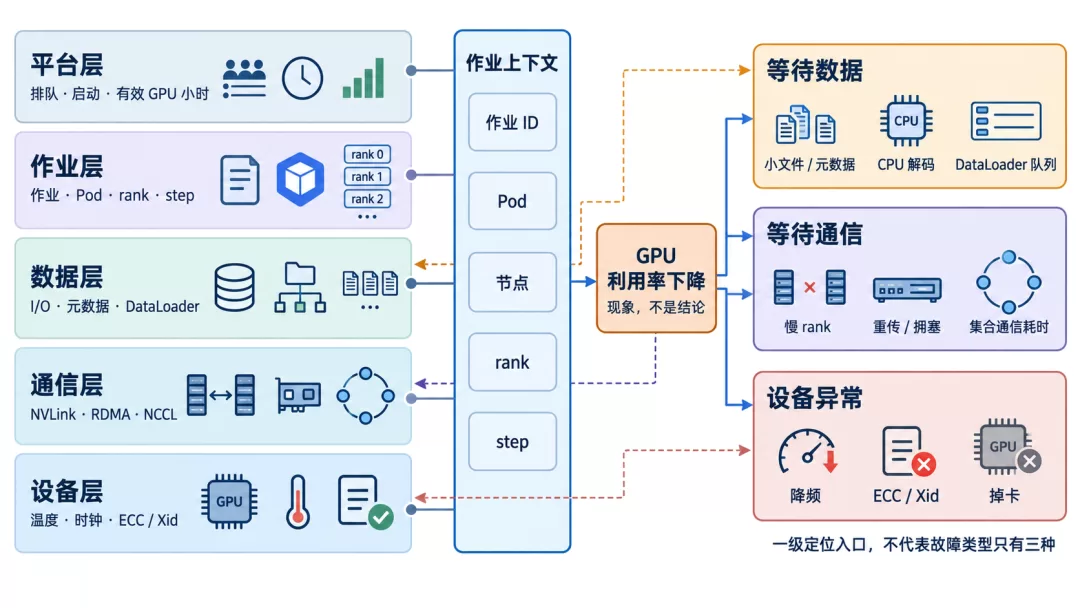
五层指标通过作业、Pod、节点、rank 和训练 step 关联起来后,才能从 GPU 利用率下降继续检查 NCCL 通信、存储 I/O 和调度排队,逐步定位真正的瓶颈所在。
总结
AI 算力平台是一个高度复杂的系统工程。GPU 只是起点,显存、NVLink、InfiniBand、调度、存储、容器和监控共同决定了训练的最终效率。只有理解每一环的作用,才能在训练出现问题时快速定位:是计算不够、通信太慢、存储跟不上,还是调度不合理。