在探索自动剪口播的工作流后,最近这个 Skill 的粗剪效果已经比较稳定,现在开源出来,并分享整个过程中的关键决策和思考。
文章主要回答两个问题:为什么不用 ChatCut 剪?为什么不用剪映的自动粗剪?以及分享制作剪口播 Skill 过程中的关键决策。
为什么不用 ChatCut?
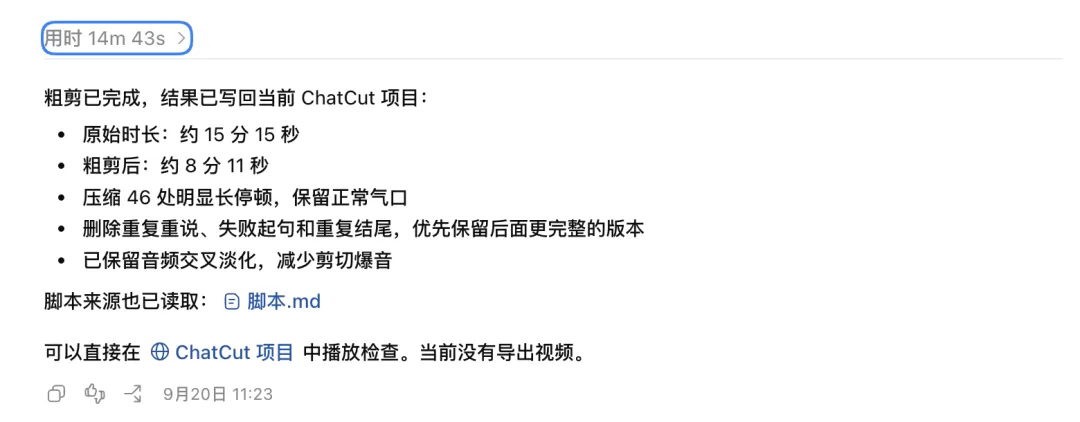
ChatCut 在今年 7、8 月份很火,但实际体验下来有几个问题:首先剪辑结果比较一般,没能正确识别明显重复的片段、长的静音片段或气口;其次使用场景和性价比不高,ChatCut 的卖点是包含粗剪、字幕生成、B-Roll 生成、配乐生成在内的 AI 编辑器,但 B-Roll 和配乐生成并不能满足需求,只为粗剪订阅 50 刀/月性价比太低;最后启动和运行都很慢,一条 15 分钟左右的视频,粗剪也要差不多的时间。
为什么不用剪映的智能剪口播?
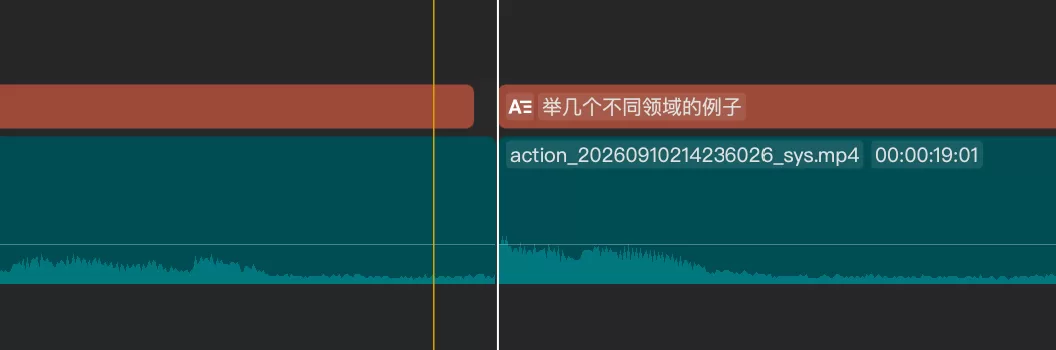
和 ChatCut 类似,剪映的「智能剪口播」在气口、重复内容的判断上也有很大提升空间,更像是做了个音视频转文字,然后把大部分审查判断交给人,谈不上太智能。「智能粗剪」功能还多了一个问题:很容易把一段话开始的气口剪多了,导致两个音频片段过渡不自然。
这才有了后面的选择:决定手搓一个更适合自己的剪口播 Skill。
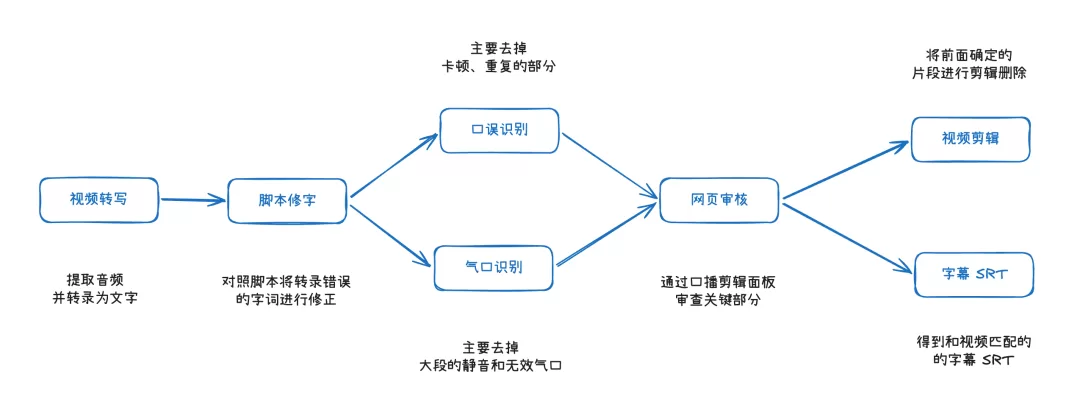
工作流编排:视频转写 → 脚本修字 → 口误/气口识别 → 网页审核 → 导出视频/字幕 SRT
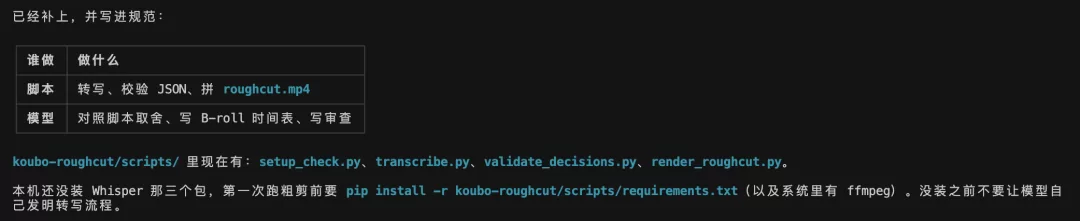
模型选择:从本地 Whisper 换到云端
第一版使用了本地 Whisper(small)作为音频识别模型,但 Whisper 的运行会占用本机内存。后来改为云端的阿里云百炼 paraformer-v2,备选火山引擎豆包语音识别 2.0。两边都有几十小时的免费转写额度,并且在中文语音识别上都要比 Whisper 更强。
字幕优化:搭配脚本基本做到 99% 准确率
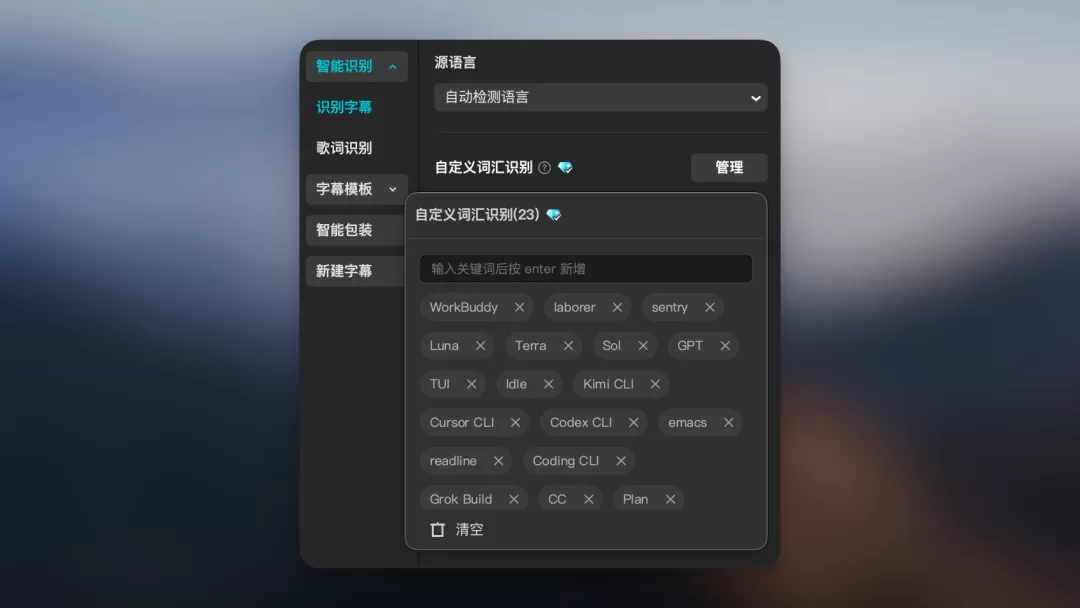
paraformer-v2 和豆包语音识别 2.0 在中文语音识别上更强,但遇到谐音、产品名(如 Claude Code、Grok Bot 等)、专业术语(如 Slider、Toast 等)效果依然会打折扣。剪映的「自定义词汇识别」可以添加的词汇数量非常有限(不超过 20 个),而且是个无底洞。
既然词汇要在完整上下文中才更容易被识别,把整个脚本/逐字稿一起丢给 AI 效果非常好,基本可以把字幕准确率提升到不用二次调整的程度。
口误识别:完全交给 LLM
关于卡顿、重复、气口的判断,经历了"完全交给 LLM → Jev 辅助判断 → 完全交给 LLM"的反复。中间引入 Jev 想验证专门的判断模型能不能让重说剪得更准,但六次实跑下来没有明显提升:修过字的成片没有因为 Jev 多删掉时长,其中唯一一次产生增量却误删了片尾唯一一句"再见"。所以后面把 Jev 从默认流程里移除了。
审片面板:人工比 AI 更快
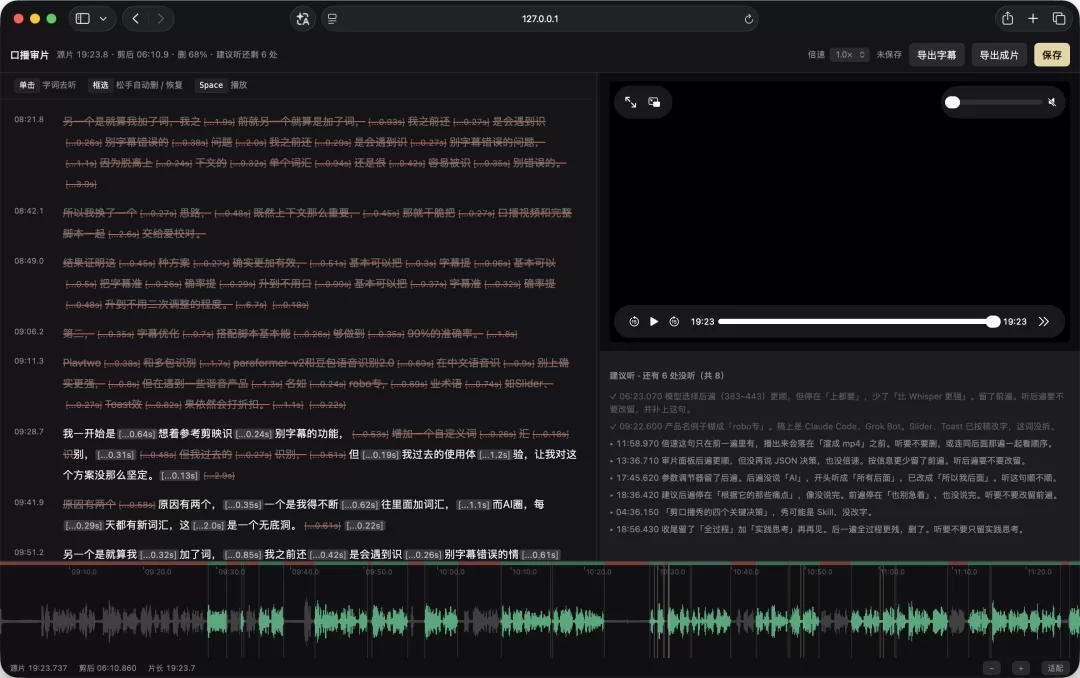
第一版是把删留结果渲染成 MP4,但每次修改细节都得重新导出,非常麻烦。后来做了审片面板:左侧看带删除线的转写,右侧看画面,底部看波形。删留决策保存在 JSON 里,面板直接改这份决策,确认以后再导出需要的文件。对需要反复调整尺寸、位置、颜色的视觉组件,做个参数调节器比让 AI 每轮重新跑一遍更快、也更准。
视频导出:从 FCPXML 转向剪辑导出
之前审片面板支持导出 FCPXML(Final Cut Pro 的项目文件格式),但最终没有选择这种方式。原因一是剪映对 FCPXML 的兼容没做好,导入流程复杂;二是源片帧率不均匀(实测为 299/12),只改 FCPXML 上的帧率标记没法消除部分字幕和声音错开的片段。所以最后选择在审片面板中确认后再导出。