当前的 AI 编码工具本质上是为「写代码」设计的:改个 bug、加个功能、跑个测试,完事拉倒。但做研究不一样——你得提假设、改代码、跑实验、看结果、再决定下一步。这是一个循环,而且可能要跑几十轮、上百轮。每一轮都得被追溯,不然论文写不出来。
更别提并行探索了。你想让两个 AI Agent 同时试两个不同的优化方案怎么办?用同一个目录?它们会互相踩脚——Agent A 刚改了训练脚本,Agent B 立刻把它覆盖了。
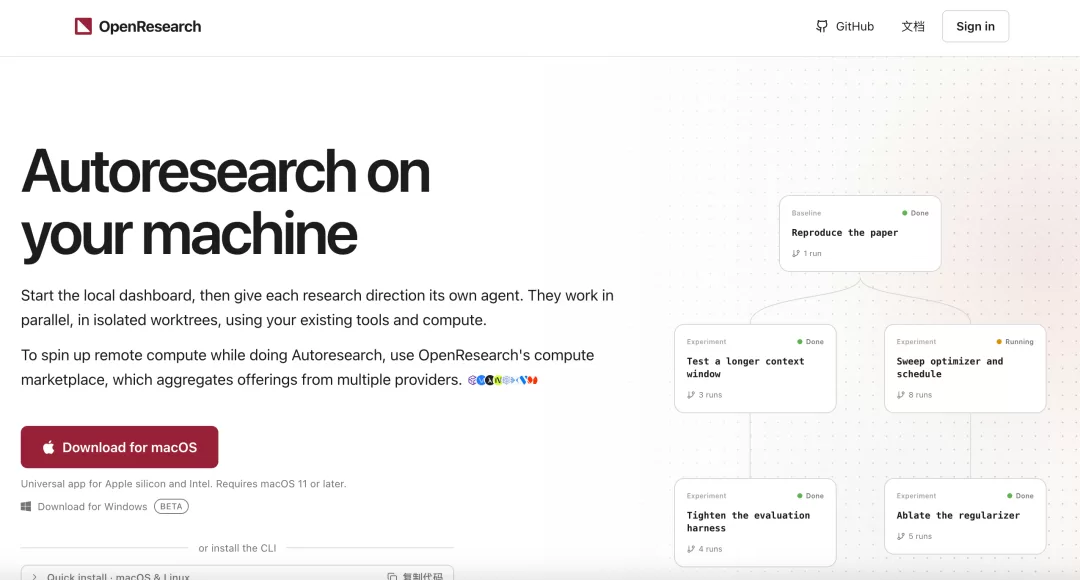
alphaXiv 团队(就是做那个 AI 论文阅读站 alphaXiv.org 的团队)最近开源的 OpenResearch,一个开源的本地科研工作台,把 Claude Code、Codex、OpenCode、Cursor 这四款 AI 编码工具,包装成能跑完整研究循环的 Research Agent。
什么叫「研究循环」?提想法 → 改代码 → 起实验 → 看结果 → 决定下一步 → 再提想法……OpenResearch 能把这整个循环自动跑起来,而且支持多个 Agent 并行探索不同的研究方向。
亮点一:每个研究方向,一个独立的 git worktree
Git worktree 允许你从同一个仓库同时 checkout 多个分支到不同目录,共享对象存储。OpenResearch 强制每个 Agent 会话配一个 worktree:
主仓库:~/project/(你自己的主工作区)
├── Agent A:~/project-agent-a/(git worktree,跑梯度下降方向)
├── Agent B:~/project-agent-b/(git worktree,跑 Adam 方向)
└── Agent C:~/project-agent-c/(git worktree,跑 SGD 方向)
每个 Agent 的改动、依赖安装、输出文件,全都锁在自己的 worktree 里。你在主工作区继续写代码、查文献,三个 Agent 在旁边各干各的,互不干扰。
亮点二:实验按 git 树管理,谱系清晰
跑了 50 次实验,每次的代码版本、参数配置、日志输出、结果图片,全都跟那次实验绑定在一起。每次运行都存一份当时提交的快照——不是拍个照片那种快照,是真正的 git commit。日志、代码 diff、输出文件,全都挂在产生它们的那次运行下面。
OpenResearch 把实验组织成父子关系的树结构:根节点是 baseline,子节点是在某个方案基础上改出来的变体。论文里需要引用的实验过程,根本不用手动整理——要追溯某个 ablation study 是怎么来的?沿着树往前爬就是了。

亮点三:本地优先,数据不出自己机器
OpenResearch 运行在 127.0.0.1,用本地 SQLite 数据库存一切。项目、对话、运行记录、日志、代码、产物,全在你自己的硬盘上。创建项目不会把代码传到云端,启动实验也不会。唯一需要联网的是调用 AI 模型 API。
功能全景
除了上面三个核心设计,OpenResearch 还补齐了整个科研工作流的上下游:
多 Agent 后端:Claude Code、Codex、OpenCode、Cursor——四个工具任选,甚至可以混搭。Agent 之间互相独立,各自有独立的 worktree 和实验目录。
实验追踪:每次运行自动记录参数、日志、输出文件,形成可追溯的实验树。支持对比不同分支的结果,快速找到最优方案。
论文草稿自动生成:基于实验树的结构和结果,自动生成论文草稿。ablation study 的表格、实验对比图、方法描述,都能从运行记录中提取。
快速开始
安装完成后,在项目目录下初始化:
openresearch init
openresearch agent start --backend claude-code
然后就可以开始并行探索了。给它一个研究方向,让它自己跑起来。你只需要在关键时刻看结果、做决策。
写在最后
OpenResearch 真正值得关注的地方,是把 AI 编码工具从「写代码的助手」升级成了「做研究的队友」。它不替你写论文,但它帮你跑实验、记过程、理谱系——那些最耗时间、最容易出错的重复性工作,全部自动化。