北大放出一个教育大模型 Omni-Edu,专做中小学教学。题目能解,错因能找,还知道这题挂在哪个课标上。4B 到 27B 三档,全开源,Apache-2.0 协议。
它是什么
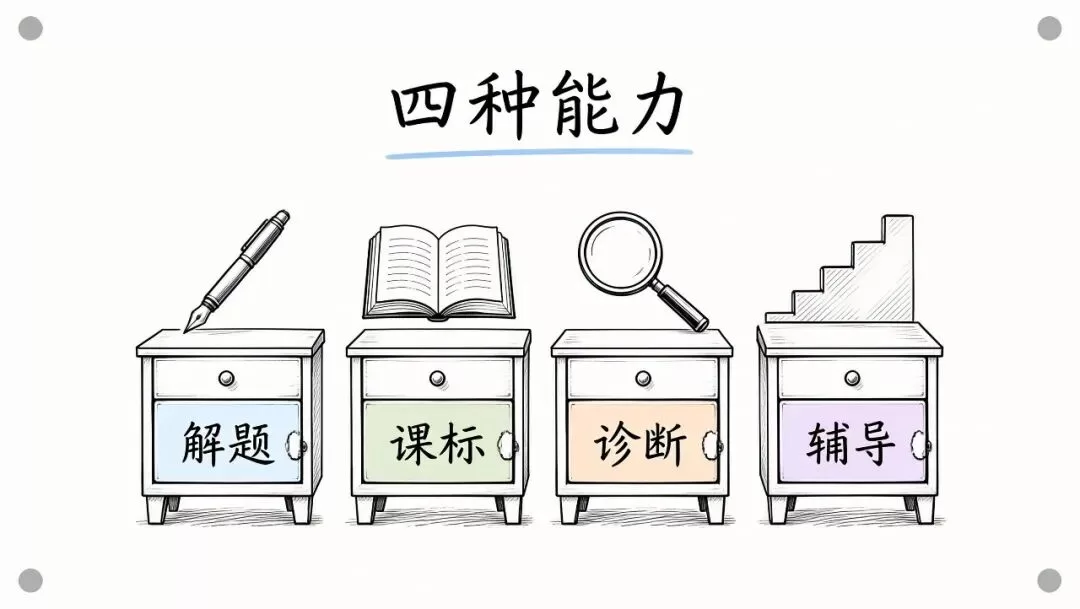
一个面向 K12 的学习加教学模型,带一篇 arXiv 论文(编号 2609.23088)。训练目标拆成四块:
- 解题:跨科目跨输入形式
- 课标对齐:题目、概念、解法都能挂到课程标准和前置知识上
- 诊断:找错因,找没学牢的前置概念
- 教学:给反馈、追问、讲解,按情况调支持方式
后三块是通用模型和大厂教育模型都不做这么结构化的。举一个例子:一个初二学生说夏天更热是因为地球离太阳近。模型得先点破这个误区,再给一个引导问题,然后才解释。顺序不能乱,先诊断后讲解。
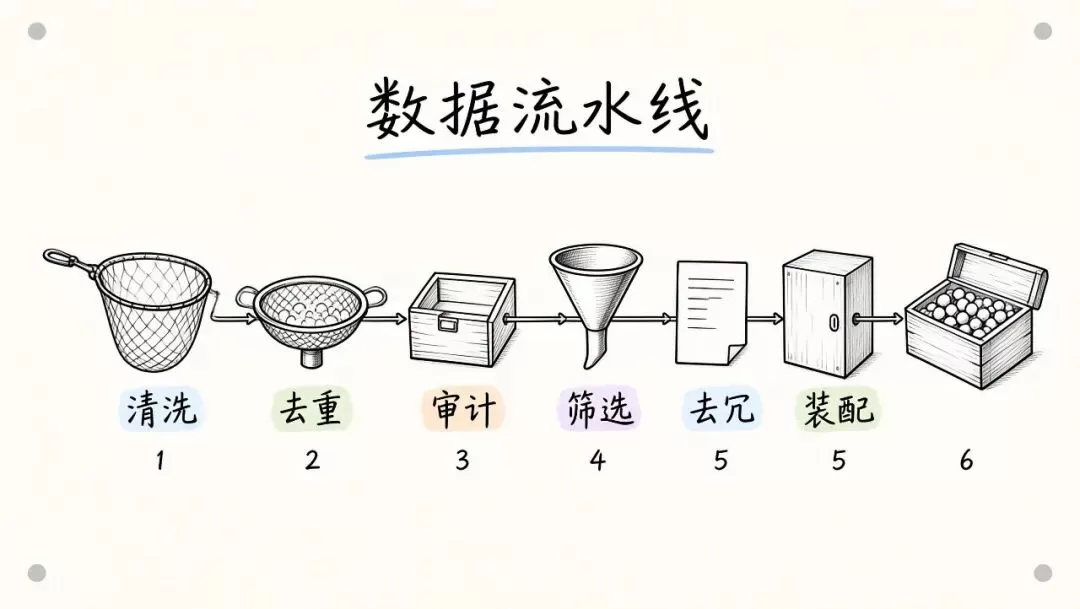
数据流水线
69999 条指令样本,15.96M 个监督 token,来源 100 多个,其中 60951 条是教育专用的。这批数据过了六道关:定能力分类、规则去重加答验、LLM 逐条判保留改写丢弃、多样性压缩、打分过滤、配教学指令。
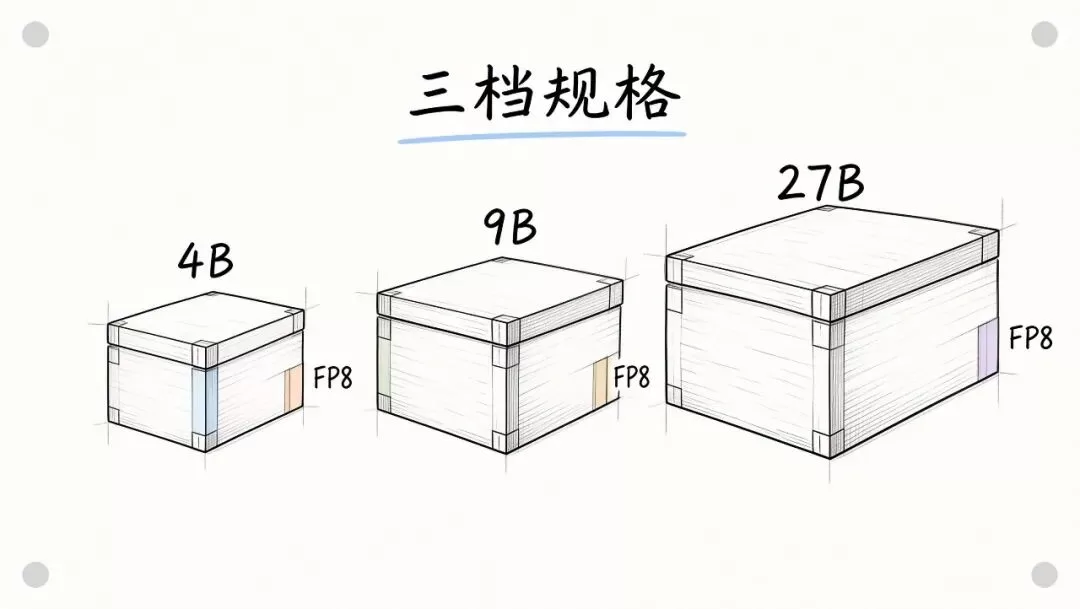
三档规格
4B、9B、27B 三档,每档又出 BF16 和 FP8 两种权重。FP8 走 128 乘 128 分块量化,视觉塔和几个投影层不量化。4B 的 FP8 只要 5.14 GiB,8G 显存的卡就能跑。
考得怎样
OmniEdu-27B 在课标对齐那张表里,K12-Bench 精确匹配和 F1 都是第一。解题那组,GAOKAO-Bench 拿 94.87。教学那组,MathTutorBench 的脚手架胜率 78.74。教育微调后通用能力没掉,27B 的 GPQA 从 74.24 升到 77.78。
怎么上手
Transformers 直接加载 BF16,vLLM 起一个兼容 OpenAI 的接口,或者装 omniedu 的 SDK。SDK 支持 pip 装,五个子命令各管一摊:chat、task、batch、eval、judge。还能吃图,把学生作业拍照传进去,让它挑错、给逐步提示。
项目结构
Omni-Edu/
├── data_preparation/   六阶段数据流水线
├── sdk/                omniedu 工具包
├── training/           LLaMA-Factory 全参微调
├── pyproject.toml
├── index.html
└── style.css
data_preparation 占最大头,六个 stage 目录各自带 README 写清了输入输出。27B 那档要两节点。
值不值得
最打动人的是课标对齐加诊断缺漏这个定位。通用模型没有,大厂教育模型多为闭源 API,它把权重、数据、流水线、SDK 四件全放出来。短板也清楚:还在验证的路上,指望它直接当正式教学用的可以再等等。