DeepSeek 最近两周动作频频。先是 V4.1-Flash-1017 基于旧版完成训练后发布,接着又把线上推理框架 DeepInfer 开源。实测下来,这个版本的回答明显更加谨慎和可靠。
从底座模型、底层内核到存储系统、Agent 套件,DeepSeek 的开源版图远比表面看到的更完整。下面系统性盘点它最有价值的 10 个顶级开源项目,综合影响力、受众范围、Star 数和代码质量进行排名。
1. DeepSeek-Math — 强化学习推理的起点
虽然 Star 只有 3000 多,但在大模型技术演进史上,它的分量不输很多百亿参数的大模型。2024 年 2 月发布时,行业主流还迷信靠海量 SFT 数据堆叠来提升能力。
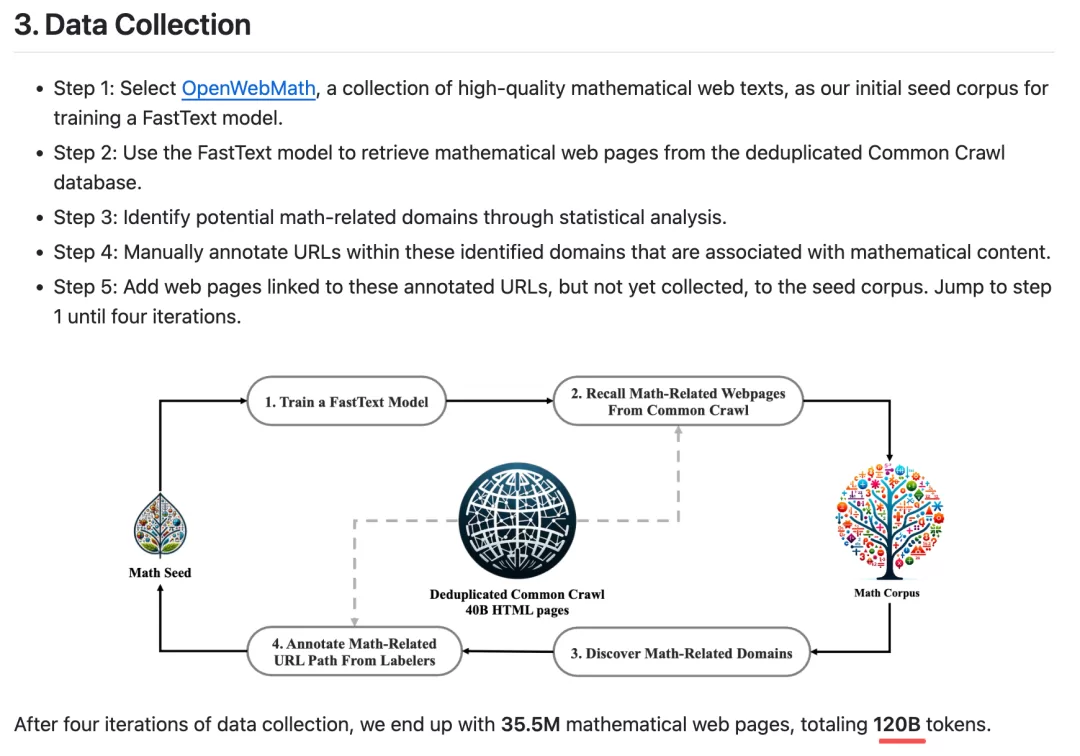
它从 DeepSeek-Coder-Base 出发,用自研清洗流水线从 Common Crawl 中筛出 120B Token 的高纯度数学语料库,证明了一个关键事实:高质量代码和数学语料的连续预训练,是激活大模型深度推理能力的基石。
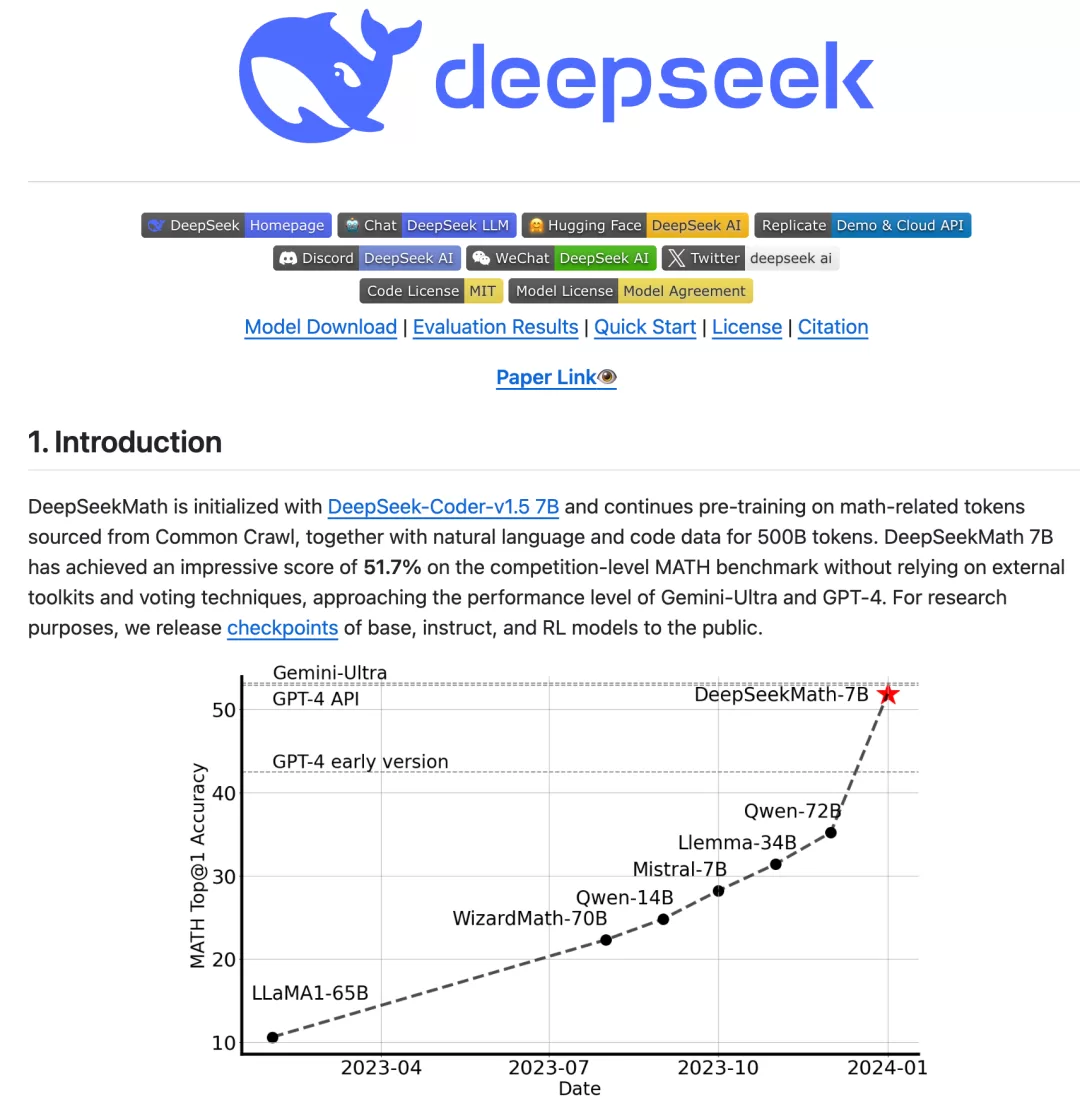
更关键的是,这篇论文首次提出了 GRPO(组相对策略优化)。后来震动全球的 R1-Zero 和 R1,算法底层完全脱胎于此。想要理解大模型强化学习,这是必读的第一课。
2. DeepEP — MoE 通信的工业级方案
DeepEP 是 DeepSeek MoE 架构的通信库,2025 年开源周第二天放出。现代 MoE 架构中,专家分散在成千上万张 GPU 上,每个 Token 都要跨卡跨节点找专家计算,再把结果汇总回来,这两次 All-to-All 通信正是 MoE 训练和推理的最大瓶颈。
DeepEP 是业内极少数将通信协议和硬件拓扑紧密结合后开源的底层库。机内走 NVLink,机间走 RDMA,高速互联配低延迟网络。传输数据的同时,安排不依赖这些数据的计算,让 GPU 少停下来等待网络。再用 FP8 紧凑格式分发,进一步缓解带宽压力。
想自建大规模 MoE 生产集群,这是目前最完整的工业级参考实现。
3. 3FS — 万卡集群的存储命脉
2025 年开源周的压轴项目,Star 刚过万,是 DeepSeek 万卡集群能平稳吞吐海量数据的底层基础设施。
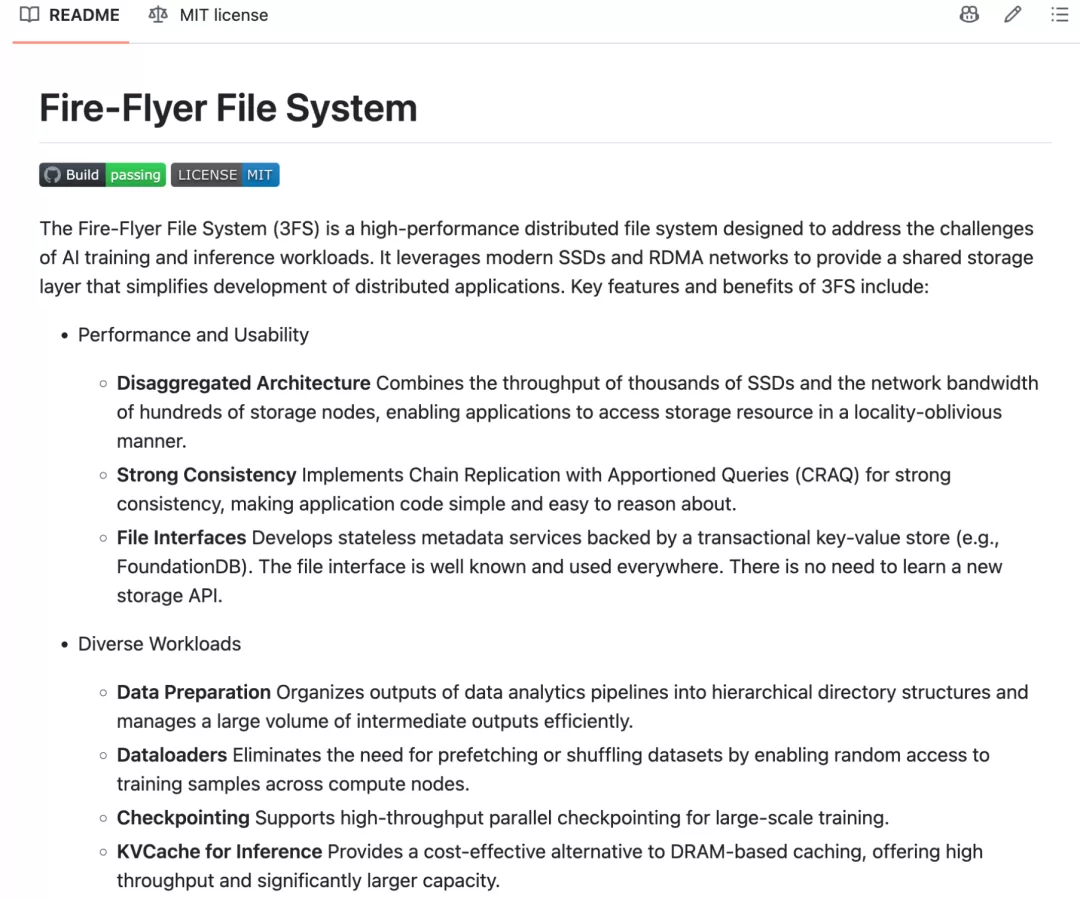
大模型有两个关键的 IO 场景:一是预训练时海量小文件的高并发吞吐,数千个 Rank 节点同时请求文本和代码,稍有阻塞算力就空转;二是极速 Checkpoint 刷盘,几百 GB 的权重断点必须在数秒内写完。3FS 直接丢掉了 POSIX 的历史包袱,为 AI 负载重新设计了存储路径:存算分离,GPU 管计算,存储节点把 SSD 组成共享池,计算节点统一访问。配合 CRAQ 强一致复制和多副本读取,再靠 RDMA 高速访问,拉满了训练读取、断点保存和推理缓存的吞吐。
4. FlashMLA — Hopper 架构的 MLA 解码内核
针对 NVIDIA Hopper 架构(H800/H100)优化的 MLA 解码高性能内核。DeepSeek-V2 和 V3 能把推理成本压到极低,核心功臣是 MLA 架构,它将 KV Cache 压缩到极小维度,显存占用骤降九成以上。但压缩之后,部分解码场景的瓶颈会从数据搬运转向矩阵计算,通用方案跑不快,需要专门的内核优化。
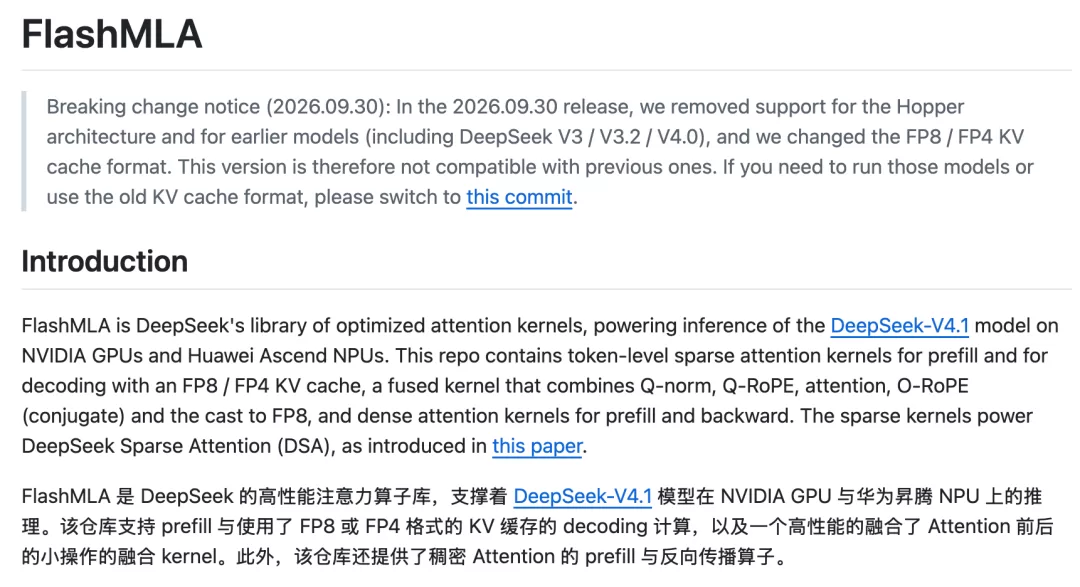
FlashMLA 直接适配压缩后的 KV Cache,省去展开再读写的开销。用 TMA 和流水线调度提前搬运数据、交错排列任务,让 GPU 少等待多计算。同时支持变长序列和分页缓存,适应多请求并发推理。核心逻辑只有几百行代码,是学习 GPU 内核调优最纯粹也最现代的教材。
5. DeepInfer — 线上推理引擎开源
10 月 16 日建仓库,五天就拿到 1.86 万 Star。这是 DeepSeek 线上支撑数亿生产请求的同一套引擎。
vLLM、SGLang 这类通用框架为了适配一切模型和硬件,堆了大量抽象层和胶水代码。DeepInfer 反其道而行,将内核、并行策略、调度全部围绕自家模型做全链路定制:接入 FlashMLA、DeepGEMM、DeepEP 等定制内核,做 MoE 专家并行和负载均衡,异步调度让 GPU 计算当前批次时 CPU 提前备好后续批次,再用 DSPark 做投机解码,生成候选 Token 后批量验证。对比两者的执行流水线,能真切体会到为自家模型完全定制时,吞吐能压榨到什么程度。
6. DeepSeek-OCR — 上下文光学压缩路线
开创了上下文光学压缩路线,能把数十页文档压进少量视觉 Token 中处理。
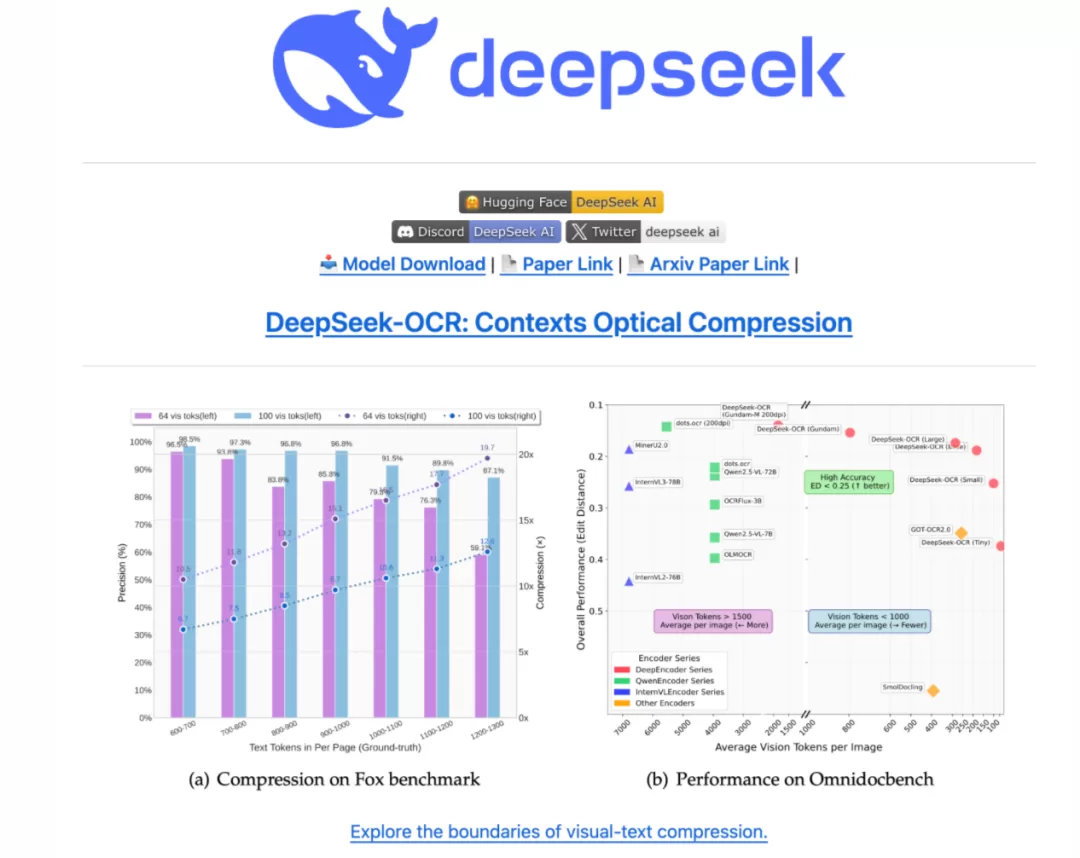
传统方案把文档 OCR 成纯文本再塞进上下文,有两个致命问题:一是 Token 爆炸,几十万字会撑爆 KV Cache,注意力成本呈二次方增长;二是结构信息丢失,表格对齐、双栏混排、流程图的空间关系全部丢失。DeepSeek-OCR 换了一条思路——文档不一定非要先转成文本。它将文档高保真渲染成图像,用视觉编码器做 Patch 切分和光学特征提取,一页数千 Token 的文档,压缩到几十到几百个 Token 就能完整表征。
7. DeepSeek-Coder — 国产 Coding 大模型的奠基之作
2023 年 10 月发布,是很多人第一次认识 DeepSeek 的起点。当时开源代码模型还停留在补全单行的水平,复杂工程处理一塌糊涂,开发者只能依赖闭源 GPT-4。DeepSeek 从零预训练代码基座,2 万亿 Token 中 87% 是源码、覆盖 80 多种语言,外加 10% 技术文档和 3% 数学语料。
预训练阶段就引入双向掩码,支持光标前后的局部重构和行内补全,上下文 16K 起步,还针对大型工程做了依赖结构训练。2024 年 6 月的 Coder-V2 更是全球首个开源 MoE 代码大模型:236B 总参、21B 激活、338 种语言、128K 上下文,在 HumanEval 和 SWE-bench 上正面超过 GPT-4-Turbo,从此打破了"写代码只能用国外闭源模型"的偏见。
8. DeepSeek-R1 — 深度推理的工业革命
2025 年 1 月 20 日发布,直接打破了 OpenAI o1 在深度推理领域的垄断,一周内掀起资本市场滔天巨浪——英伟达单日跌 17%,蒸发近 5900 亿美元。
在此之前,推理模型被普遍认为是硅谷巨头靠海量人工标注 CoT 和昂贵 PRM 堆出来的护城河。R1 的技术报告给出了一条以强化学习为核心的路线:R1-Zero 从 V3-Base 直接开始纯强化学习训练,数学对答案、代码跑测试,用反馈训练,自发涌现出自我检查和反思能力;GRPO 通过组内比较压开销,省掉独立价值模型;多阶段训练兼顾推理能力、可读性和通用能力;最后蒸馏出 1.5B 到 70B 的小模型版本,部署门槛大幅降低。
9. DeepSeek-V3 — 以极低成本追平顶级闭源
2024 年 12 月发布,671B 总参、37B 激活,用 2048 张 H800、约 557.6 万美元训练成本,追平并局部超越了世界顶级闭源大模型。
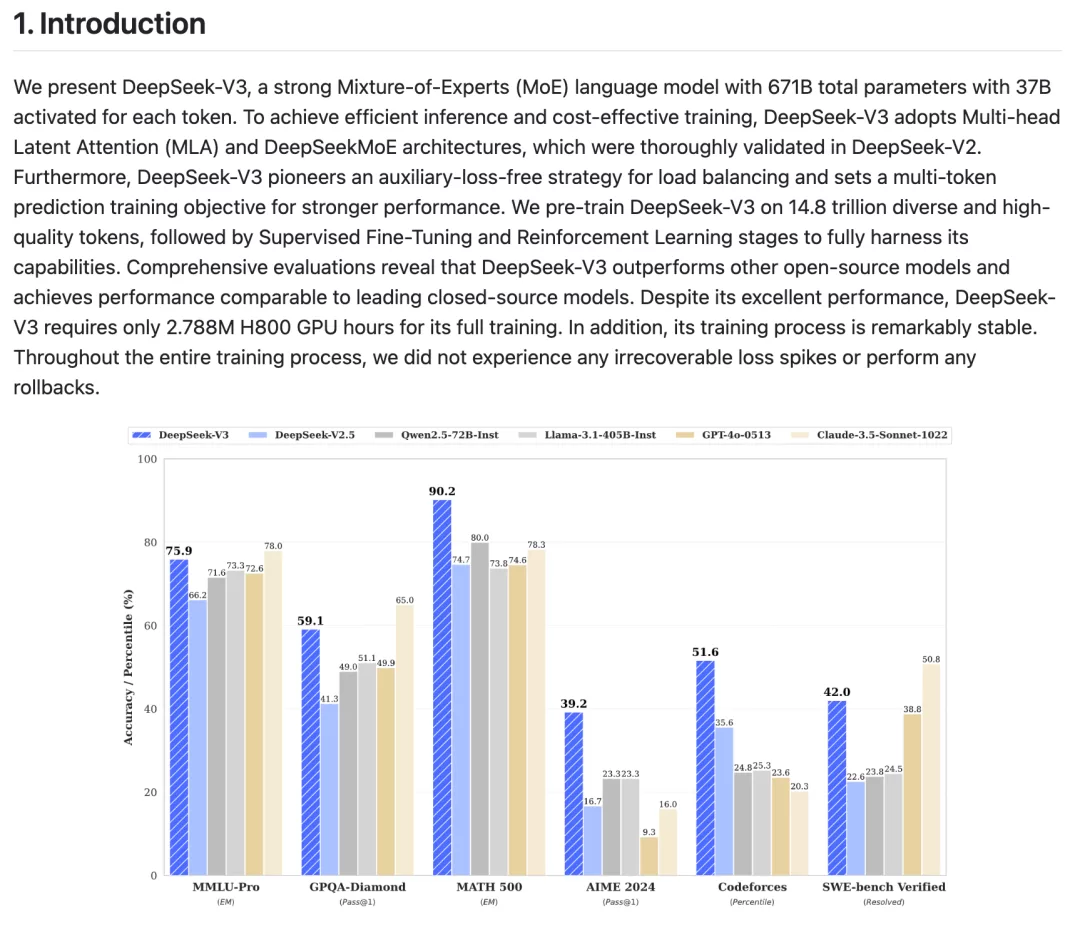
传统 Transformer 越过几千亿参数后,会撞上成本爆炸、显存墙、KV 缓存挤爆硬件这些瓶颈。V3 的思路是把系统级硬件考量反哺到架构设计中:MLA 压小 KV Cache 降低推理显存;MoE 无辅助损失负载均衡,每个 Token 只调用少量专家;FP8 混合精度训练兼顾效率和稳定;MTP 多 Token 预测在训练时多目标优化,推理时还能做投机解码加速。仓库里的 inference/model.py 值得单独一读,800 余行纯净 PyTorch,把 MLA、MoE 路由、RMSNorm、RoPE 写得清清楚楚,没有任何框架依赖。
10. DeepSeek Harness — 下一代 Agent 运行底座
DeepSeek 2026 年最具影响力的开源项目。基于 Cordis 微内核构建的下一代 Agent 运行底座,全面拥抱"一切皆插件"和驾驭工程(Harness Engineering)。
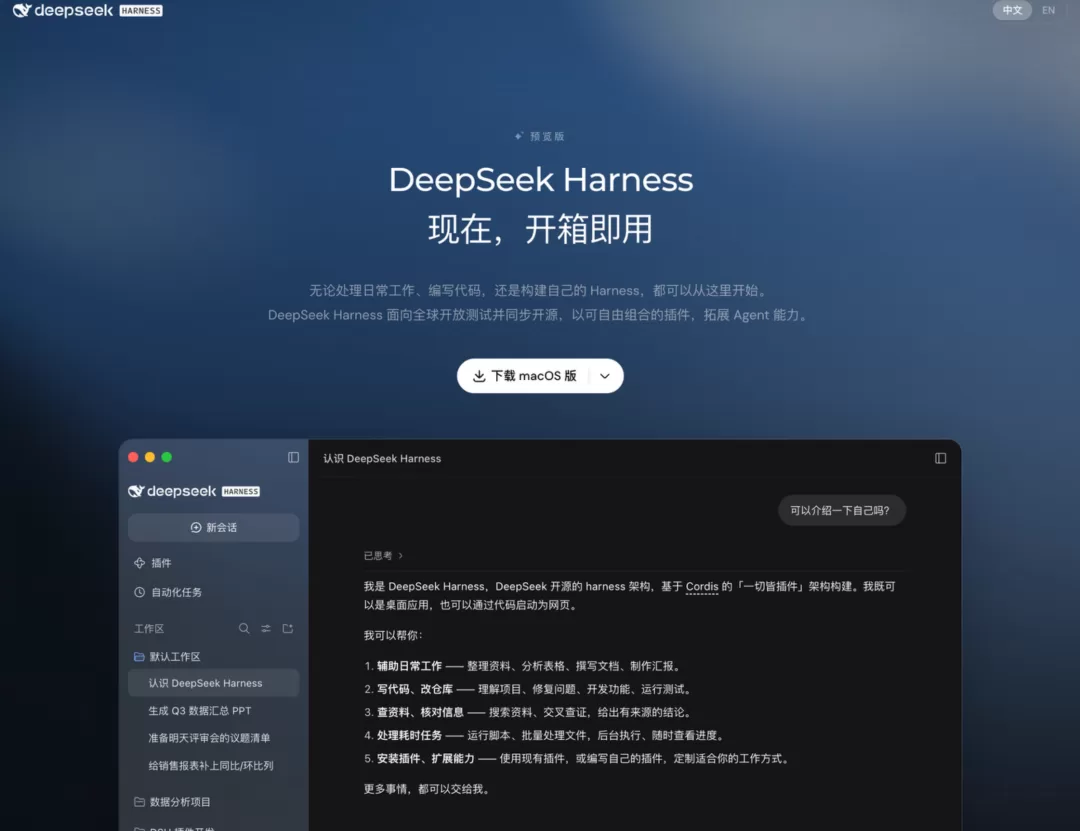
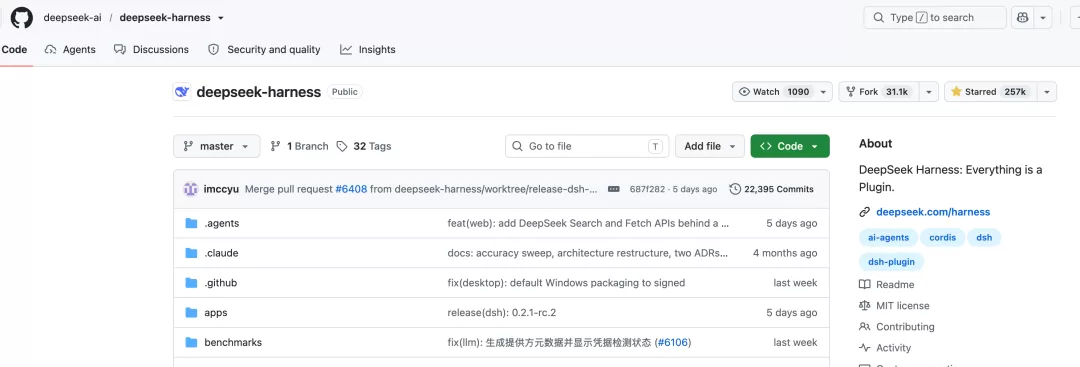
2026 年 8 月 13 日以 MIT 协议开源,两个多月 Star 突破 25 万,成为 GitHub 上最具统治力的 Agent 基础设施项目。
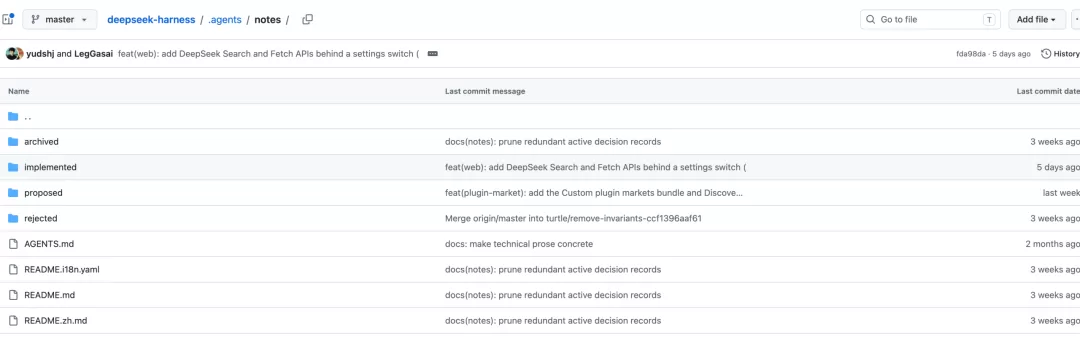
很多人以为 DSH 的爆发纯靠品牌号召力。但翻开仓库的 .agents/notes/ 目录,崔添翼团队留下的每一篇系统演进笔记,都带有真实思考日期、方案选型和硬件 Trade-off,甚至有被放弃的技术路线。把真实的架构设计过程全景留痕、毫无保留地公开,这种态度本身就比几万行代码更稀缺。
写在最后
复盘这 10 个项目后会发现,DeepSeek 的开源和其他 AI 公司有本质区别。别人开源是做了一个产品、放个精简 Demo 供围观,DeepSeek 是自上而下的全链路解剖——从内核到应用、从模型到存储,每一层都做到了能跑、能读、能复现。
这 10 个项目里,哪个对你的项目最有用?欢迎在评论区聊聊。
项目地址汇总
Github:deepseek-ai/DeepSeek-Math
Github:deepseek-ai/DeepEP
Github:deepseek-ai/3FS
Github:deepseek-ai/FlashMLA
Github:deepseek-ai/DeepInfer
Github:deepseek-ai/DeepSeek-OCR
Github:deepseek-ai/DeepSeek-Coder
Github:deepseek-ai/DeepSeek-R1
Github:deepseek-ai/DeepSeek-V3
Github:deepseek-ai/deepseek-harness