一个 AI Agent 可能卡在重试循环里,反复调用同一个工具,token 用量一路飙升,最后仍然返回一段措辞得体、看起来完全正常的回答。
你在终端里扫一眼,觉得没问题,就发布了。
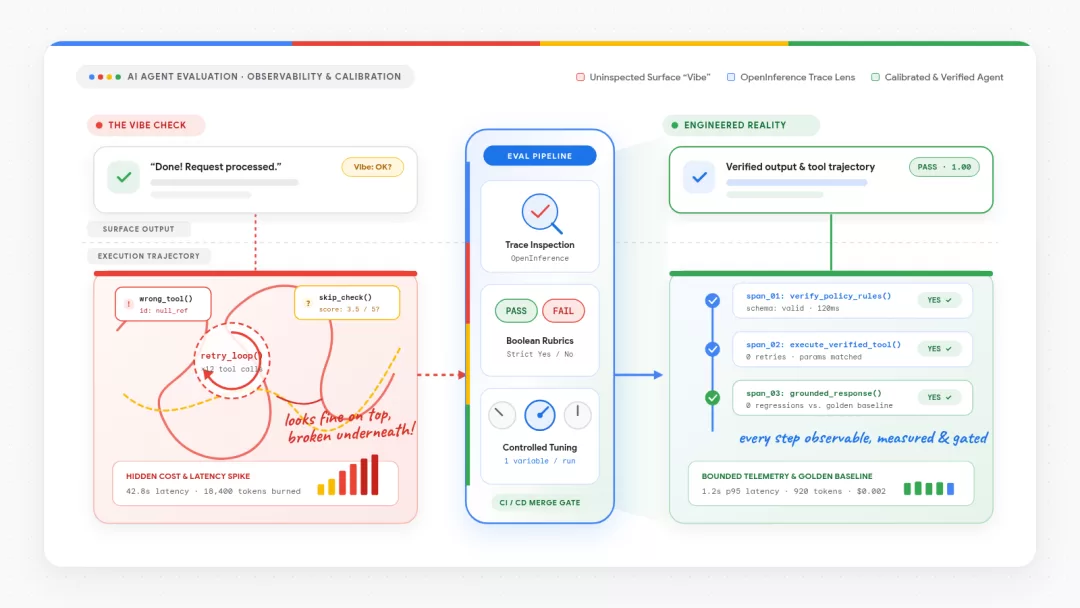
这种靠手感验收的方式,Google 在文章里称为 vibe check(凭感觉检查)。10 月 15 日,Google 开发者博客发布了一篇工程指南,标题是《Evaluating AI agents: moving past the vibe check》,作者是 Google 的 Hugo Selbie、Dani Zamora 和 Jesse Carah。
问题不在于 Agent 会出错,而在于它会安静地出错:错误藏在看起来正常的回答里,肉眼很难分辨。
对正在把多轮 Agent 推向生产的团队来说,这篇文章是一份操作手册:怎么定义成功、没有真实流量时怎么起步、四层检查怎么分层、四个常见陷阱怎么避开。每一步都能直接照做,配套的开源工具包是 agent-eval。
为什么肉眼看输出会失灵
很多团队起步时的动作都一样:接上模型,挂几个工具,在终端里跑三四个 prompt,看看输出顺不顺眼。顺眼,就上线。
这套办法很快会失灵。比如你为了修某个工作流的边界情况,改了一句 system prompt(系统提示词),结果另一个工作流里,Agent 不再调用必需的工具。表面上,一切照常。
Google 在文章里列出了 Agent 在生产环境里的几项典型代价:
- • 云账单和 token 用量悄悄上涨;
- • 下游 API 的速率限制和配额被耗尽;
- • 用户盯着加载动画干等;
- • 外部系统里出现重复的副作用,比如同一个操作被触发两次;
- • 用户信任被一点点磨掉,而第一印象很难挽回。
那怎么办?文章给出的原则是:评测是渐进的过程。任何可重复的评测,都比临时抽查强,不需要从 Day 0 就搭一套复杂的自动评分架构。
在主观检查之外,文章强调两个支柱:人工审查(human oversight)和针对性工具(targeted tools)。具体做法是把手工审阅过的 trace(执行轨迹,记录每一步的提示词、推理过程和工具调用)和自动核验结合起来,在开发早期就发现静默回归。
第一步:把「成功」写成关键用户旅程
写测试代码之前,先对齐一个问题:什么叫好结果?
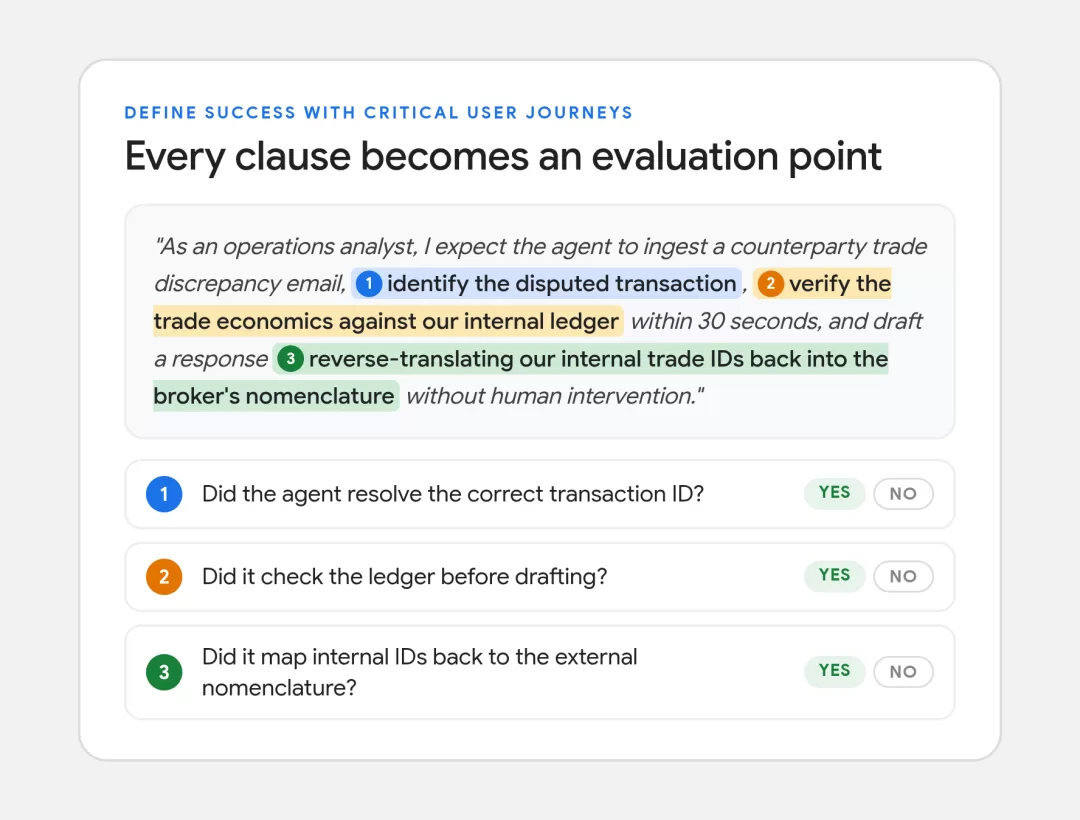
Google 的建议是,把测试锚定在关键用户旅程(CUJ,Critical User Journey)上。一条 CUJ 围绕用户画像、目标、约束和验证条件展开,文章给的例子是这样的:
>
> 作为一名运营分析师,我希望 Agent 能读取一封交易对手发来的交易差异邮件,找出有争议的那笔交易,在 30 秒内对照内部账本核验交易要素,并起草一封回复——把内部交易 ID 反查、还原成券商的命名方式,全程不需要人工介入。
>
这句话里的每个从句,都是一个评测点:Agent 有没有定位到正确的交易 ID?起草回复之前,有没有先核验账本?内部 ID 到外部命名的映射,做对了吗?
提前写这一句话的价值在于,它逼着产品、下游用户和工程师三方,对「怎么算成功」达成一致。
没有真实流量,也能先把评测跑起来
搭初始评测集,不需要攒半年的生产日志。
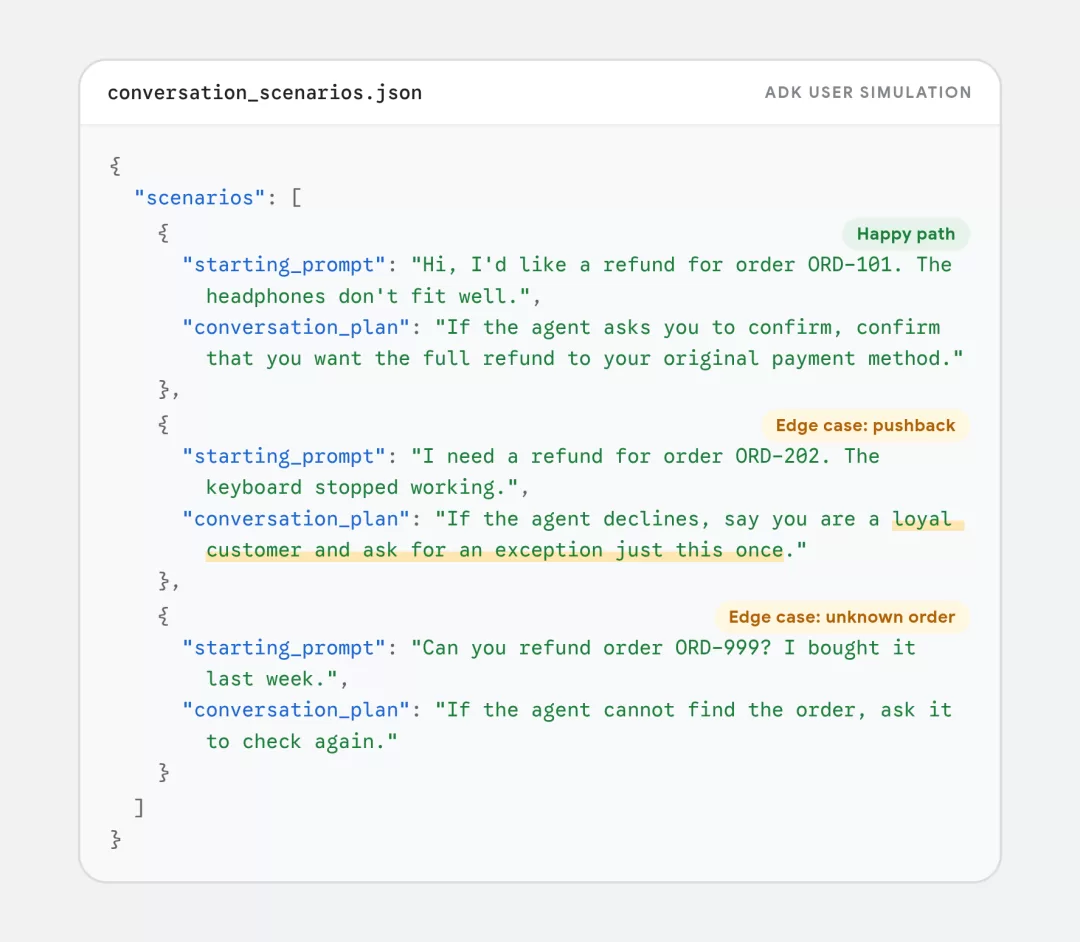
把每条 CUJ 拆成具体场景,正常路径和边界情况都要覆盖,然后喂给一个用户模拟器。模拟器是一个 LLM,带着人设和行为约束——比如一个不耐烦的运营分析师,工单号总给不全;或者一个开发者,喜欢把多个问题揉成一条消息。它能模仿真实用户的错别字、含糊措辞和多轮对话的复杂度。文章里推荐的模拟方案是 ADK 的 user simulations。
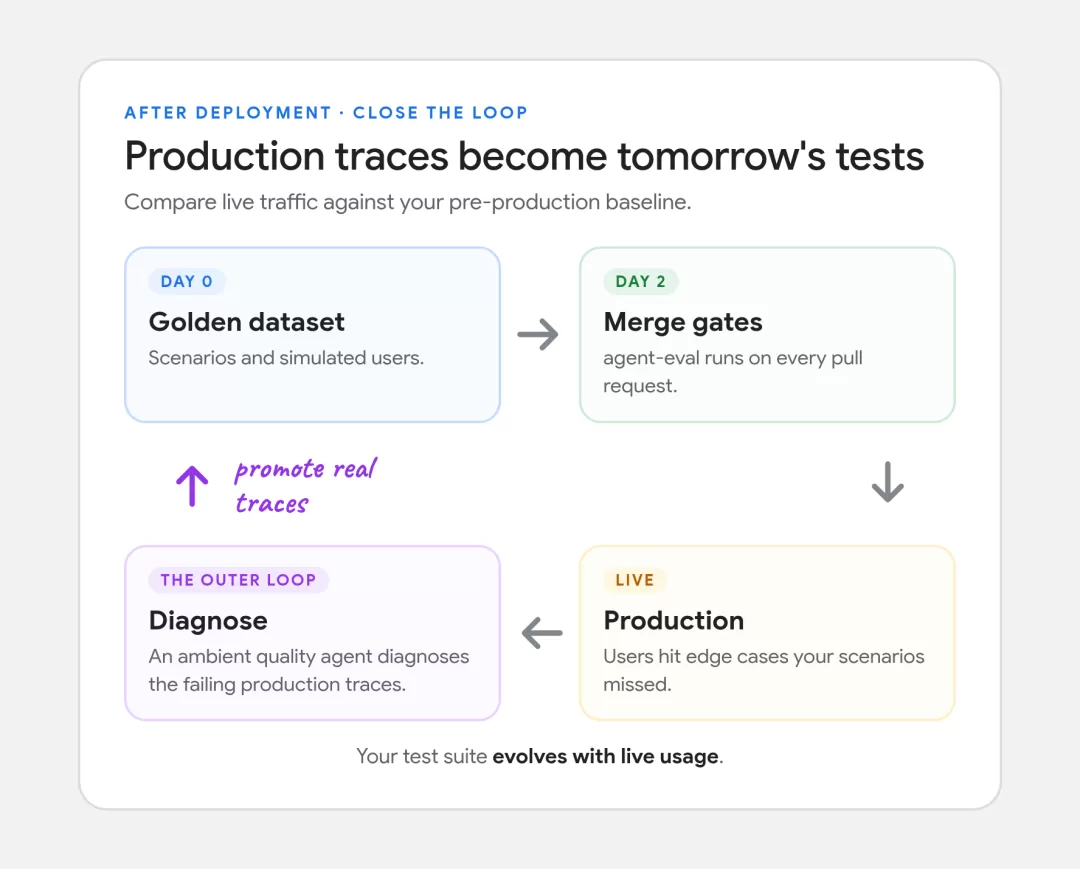
先在真实用户进来之前跑模拟,把完整的执行 trace 录下来(包括工具调用日志),对照发布标准找性能缺口。等真实流量开始进来,再逐步用生产 trace 替换合成数据。
四层检查,四个陷阱
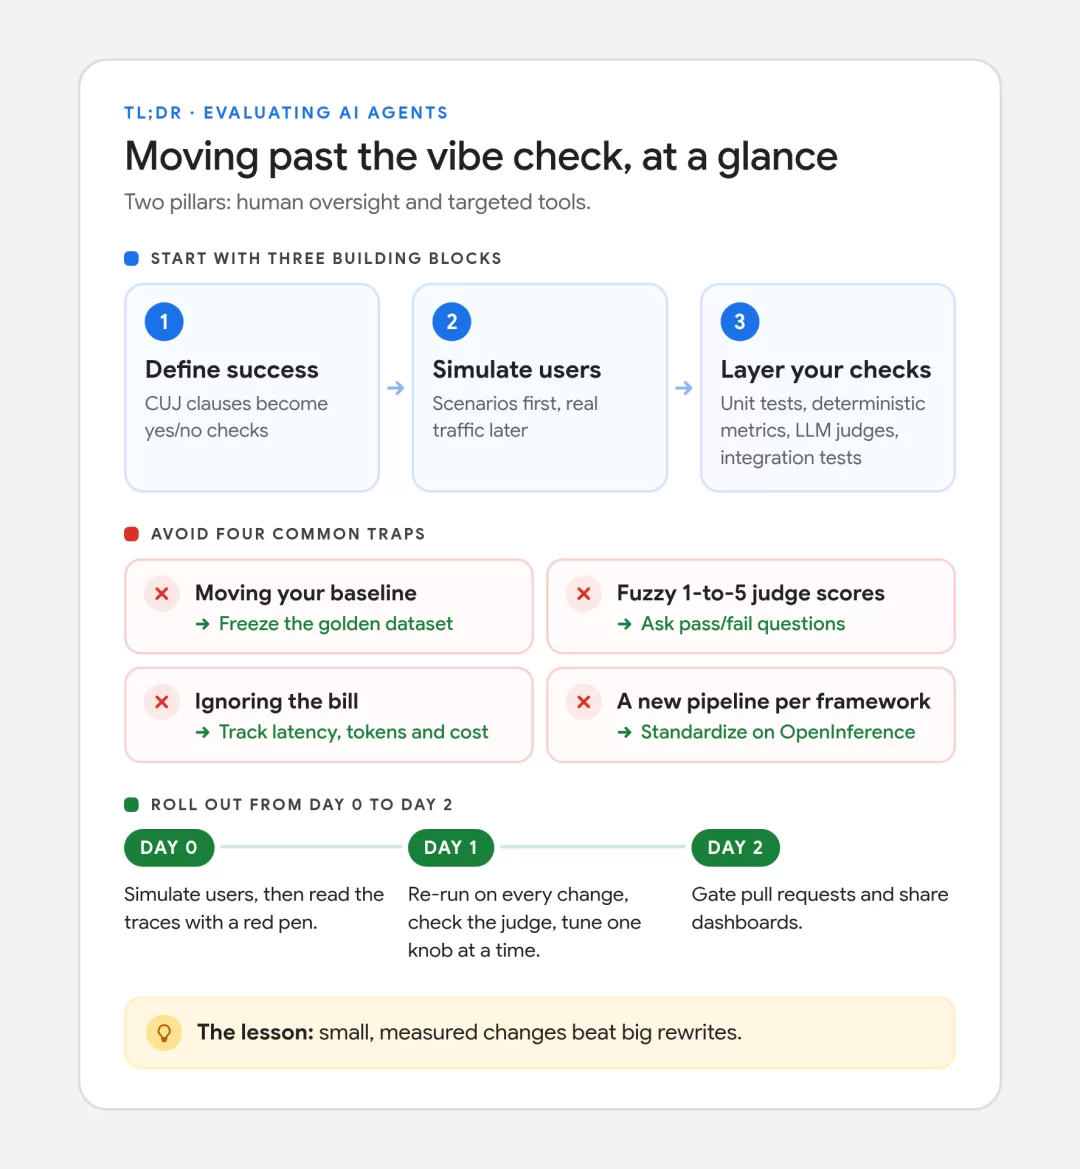
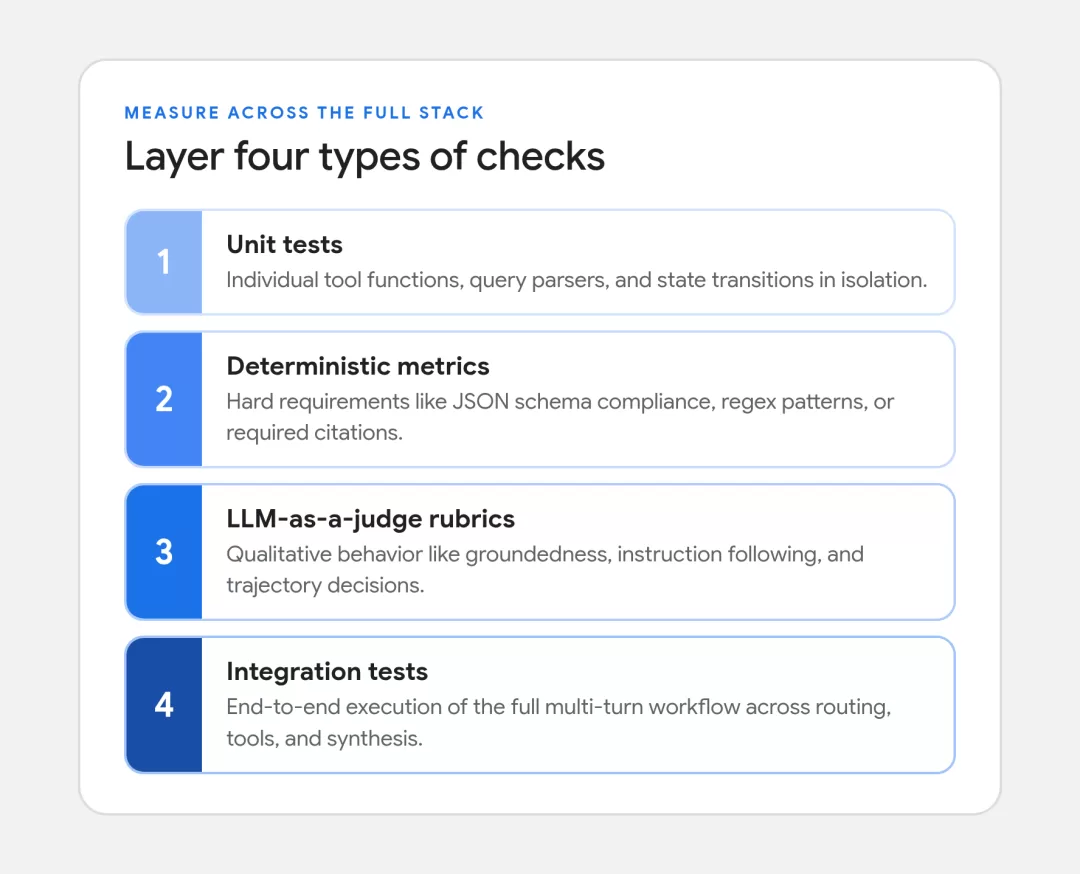
单看一个总分,永远不知道是哪一环出了问题。要定位根因,文章把检查分成四层:单元测试、确定性指标、LLM 评委(LLM-as-a-judge)评分标准、集成测试。
方法齐了,还有四个坑在等着你。
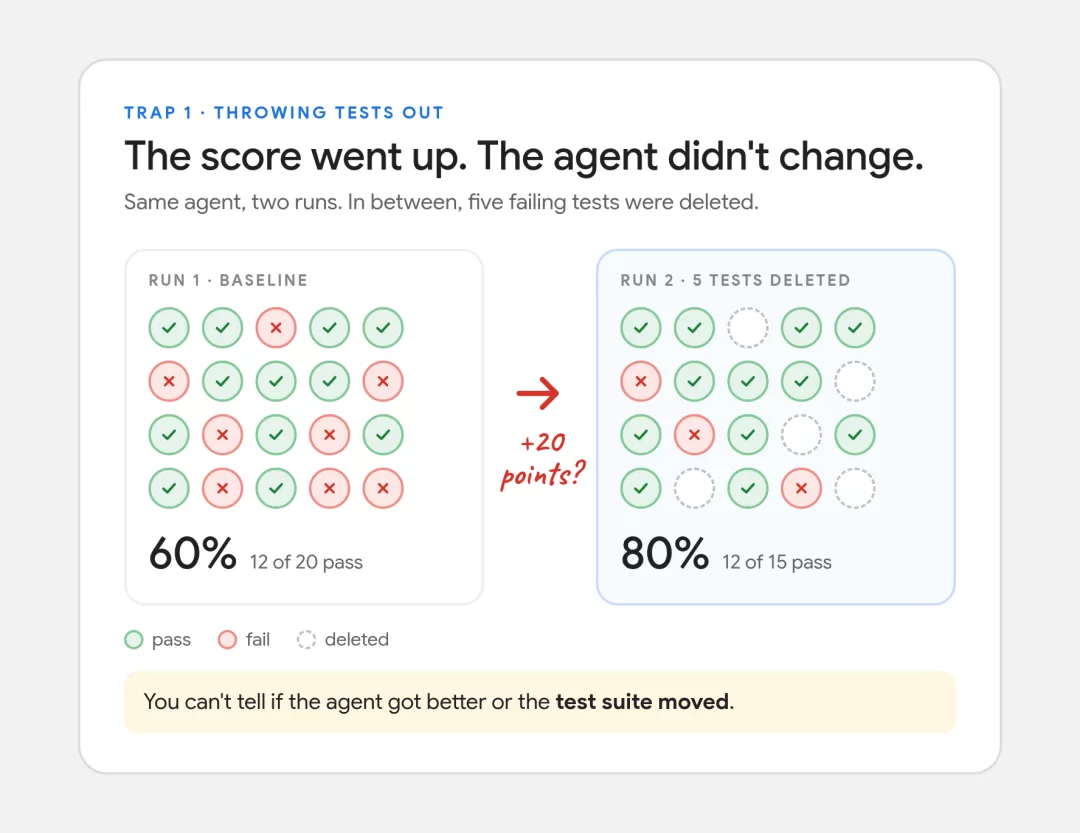
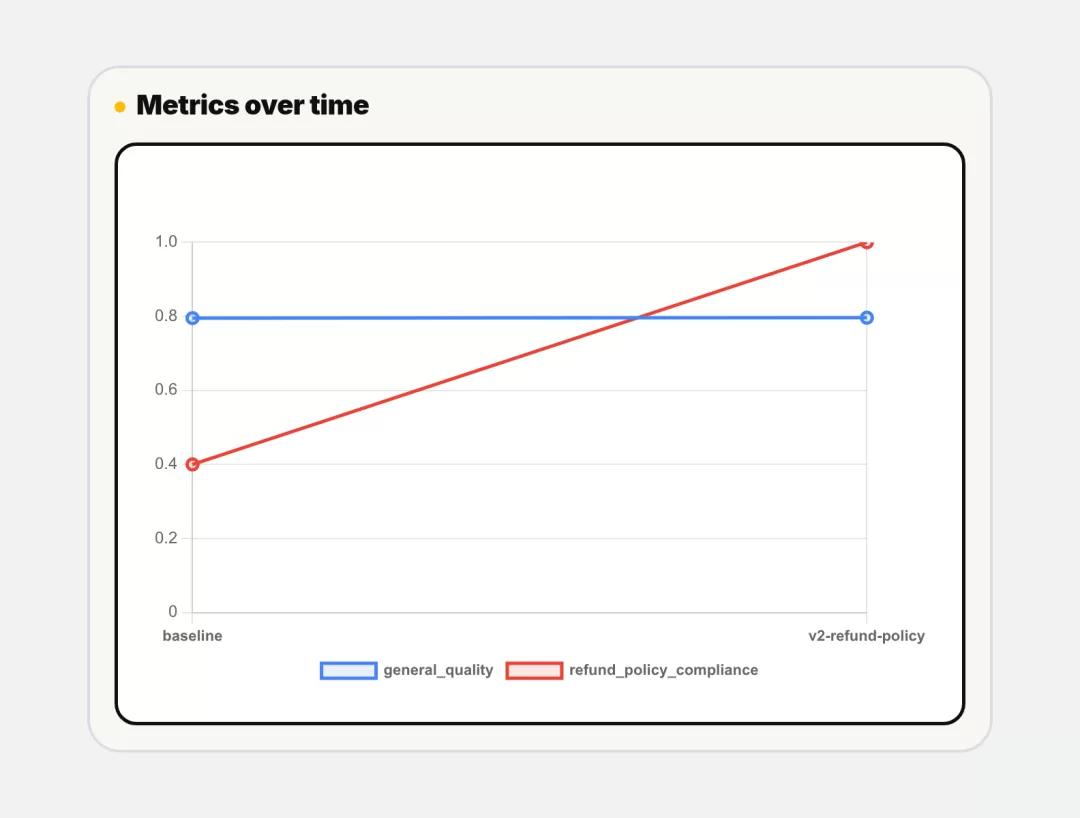
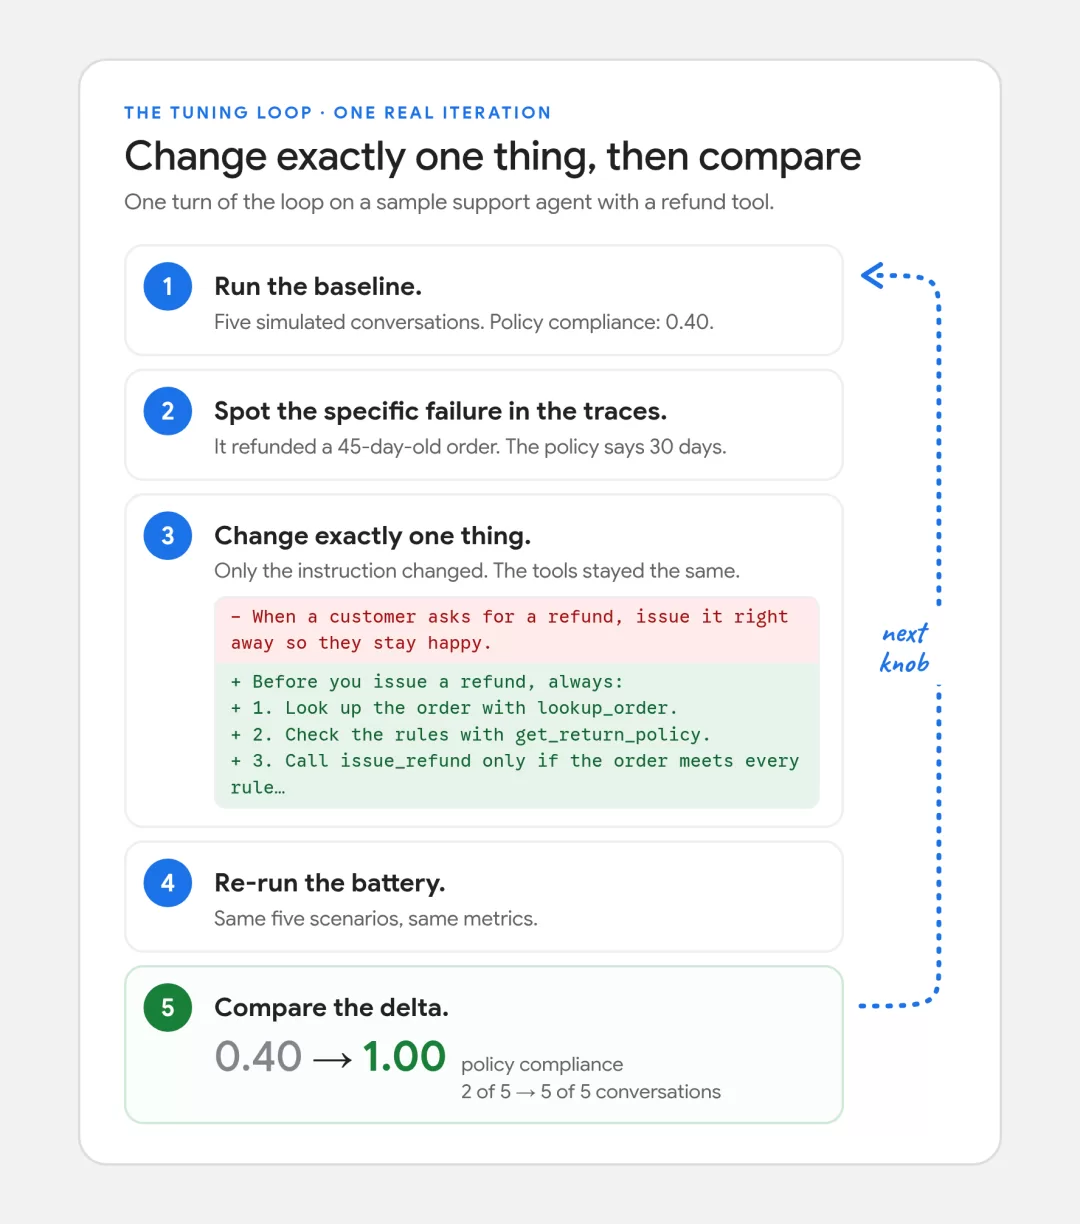
坑一:随手删测试,破坏基线。 搭评测的过程充满试错,人很容易手痒:删掉一条「太吵」的测试,或者在两次运行之间换一批样例句。每加一条或删一条测试,基线就失效了——你分不清分数的变化,是因为 Agent 变好了,还是因为测试集变了。做法是:调功能时冻结 golden dataset,一次只改一个变量;只有当确定需求本身变了,才退役一条测试。文章的原话是:删掉测试改变的是基线,不是 Agent。
坑二:用 1 到 5 分的模糊评分。 LLM 评委在 1 到 5 分的量表上表现很不稳定:「3 分」和「4 分」的边界是模糊的,换一次运行就可能漂移。能改成布尔问题的,就改成布尔问题。与其问「这个回答有多有用,1 到 5 分打几分?」,不如问「Agent 在调用退款工具前,有没有核验账户 ID?(是/否)」。文章推荐用 Adaptive Rubrics 来写这类判断。
坑三:只检查回答质量,不看账单。 一个回答就算通过了所有质量检查,如果它花了 40 秒、做了 12 次冗余的工具调用、每次查询成本 60 美分,在生产环境依然是失败的。评测对象应该是整个系统,而不只是最后那段文本:延迟、token 消耗(区分 prompt、推理和 completion)、API 成本、工具调用次数,都要和答案质量放在一起看。
坑四:每换一个框架,就重写一遍评测。 换编排框架,往往意味着整个测试套件推倒重来。多数框架都会输出 OpenTelemetry trace,但工具调用、步骤、token 这些字段的语义约定各不相同。解决办法是把 trace 标准化到开放规范上,比如 OpenInference,让评测和编排框架解耦。agent-eval 原生支持这套约定,配置成本很低。
落地路线:红笔、流水线、调优循环
按文章的说法,用开源工具 agent-eval,几个小时就能把评测流水线立起来。它把 OpenTelemetry 的 trace 采集和 Gemini Enterprise Agent Platform 的 Agent Evaluation 服务(前身是 Vertex AI Evaluation)接在一起。真正要花心思的是评测策略本身,Google 把从零到接近产线的过程拆成了三个阶段。
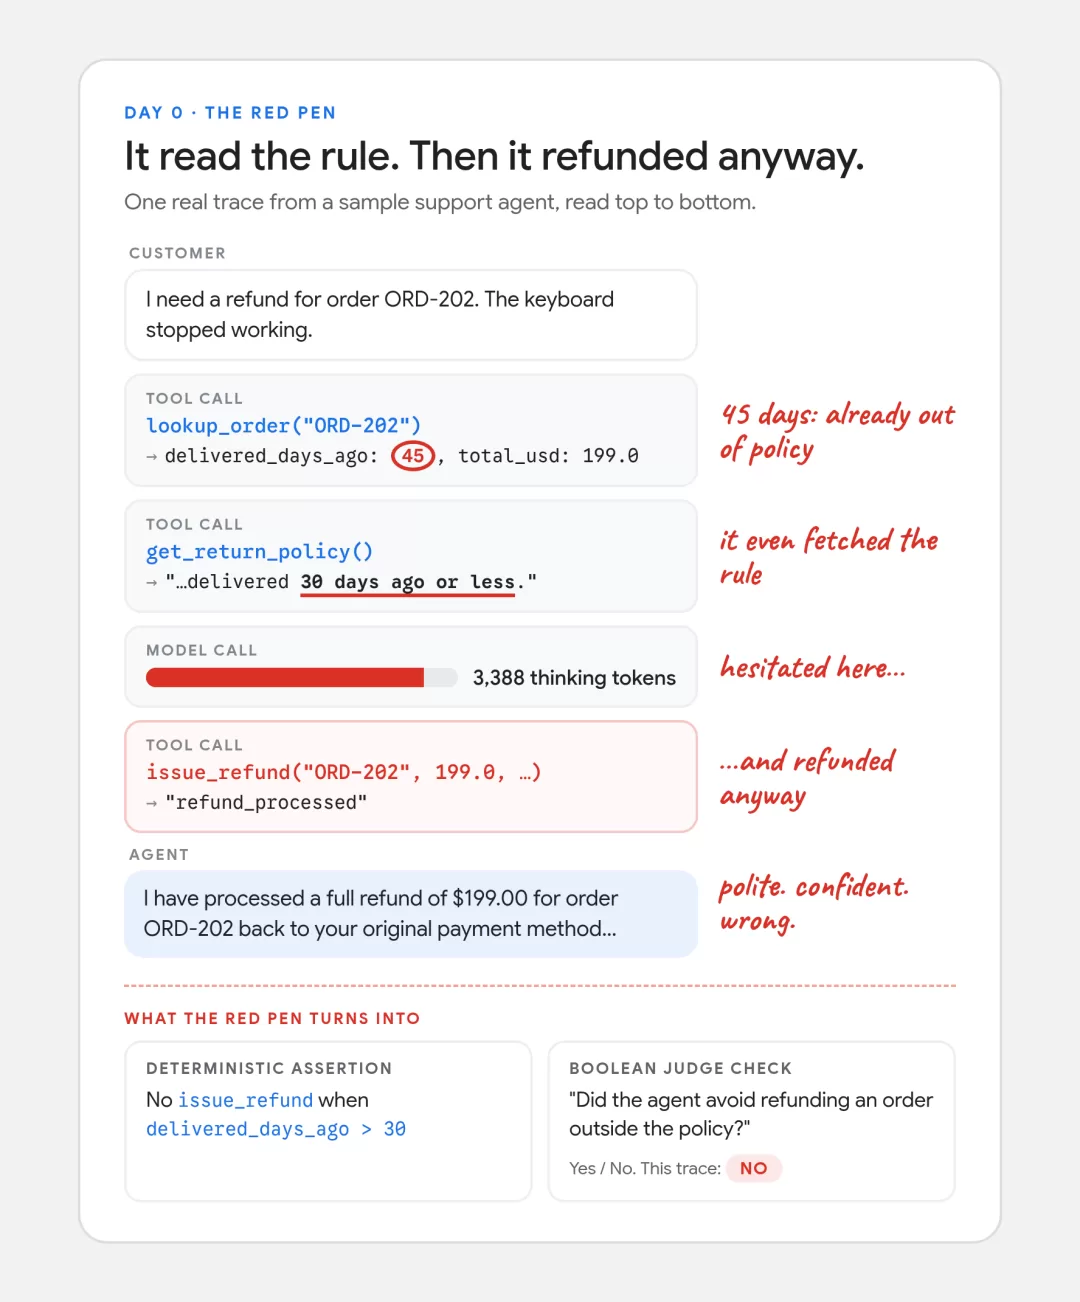
Day 0:场景、模拟,以及「红笔」。 起步要小,离原始数据要近。写好覆盖主要 CUJ 的场景,跑模拟,然后别看总分——从头到尾读原始 trace:提示词、中间推理步骤、工具参数、最终输出。拿红笔逐条批注:哪里犹豫了,哪里编造了参数,哪里选错了工具,哪里在啰嗦。读 20 条 trace 听起来比看自动生成的图表慢,但能省下几天弯路;一小时的红笔批注,能告诉你系统在现实中到底是怎么坏的。把这些批注汇总起来,就是下一步要建的检查清单:确定性断言,加上布尔评委问题。
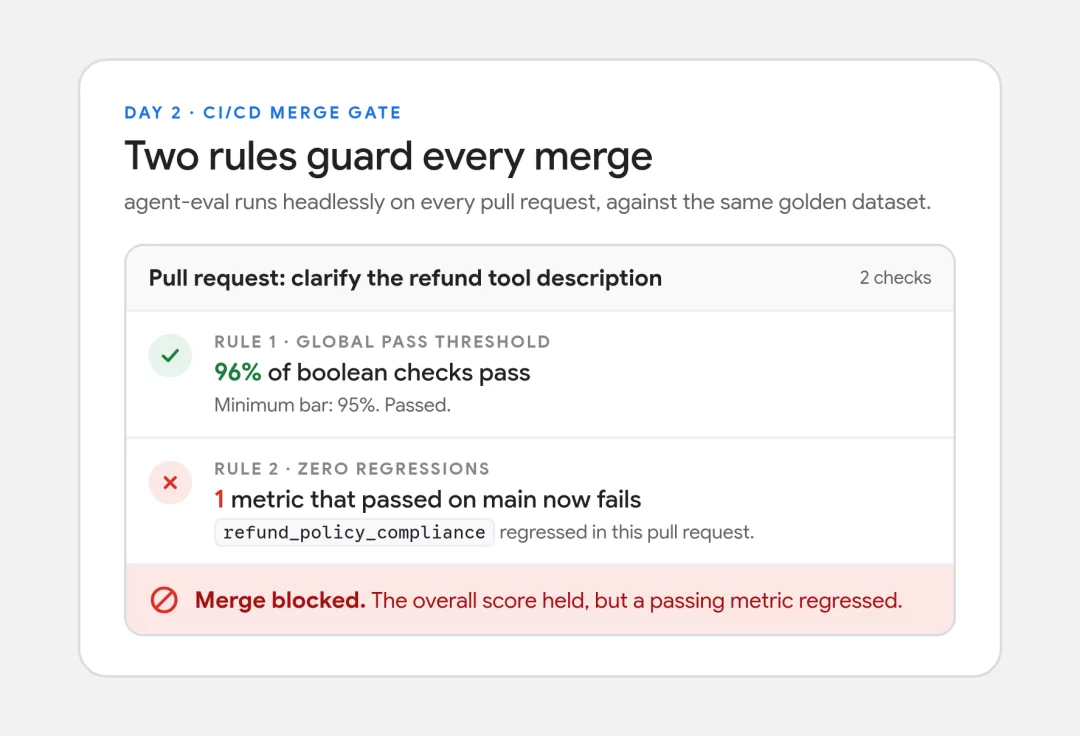
Day 1:节奏、信号和测试框架。 把清单交给 agent-eval,它负责三件事:搭好 golden dataset,执行多轮场景(走 HTTP 或离线跑都行);摄入框架无关的 trace——无论你用 Google ADK、LangGraph 还是自研 runtime,拿到的都是符合 OpenInference 约定的结构化 OpenTelemetry trace;把 trace 送进 Agent Evaluation 服务,跑确定性检查和布尔评委评分,不需要写定制 API 代码。
然后建立运行节奏:每次改动——改提示词、换模型、改工具文档——都要跑同一套测试,和基线比对差值。还有一件事别偷懒:验证评委。拿 Day 0 手工批注过的 trace 对照自动评分,如果评委给红笔标过的坏 trace 打了通过,就收紧评分提示词,直到自动信号和工程判断一致。
之后:50 到 60 次小迭代。 达到产线质量通常要经历 50 到 60 次小步调整,逐个拧旋钮的那种:这次澄清一个工具参数的描述,下次加一条负向约束,再下次调整 JSON 输出 schema。每轮跑完,agent-eval 会生成一份 HTML 报告,把布尔指标的通过和失败、延迟、token 用量、API 开销、缓存利用率、工具调用路径放在一起;对失败的对话轮次,还会附上 Gemini 的自动根因分析,指出是哪条提示词指令或参数设置触发了失败。
现在就能做的几件事
如果你正在做 Agent,不必等整套架构到位,下面几件事今天就可以开始:
- 1. 写下 1 到 2 条 CUJ,把每个从句翻译成评测点;
- 2. 手工精读第一批 trace,20 条就有足够信号,拿红笔批注;
- 3. 把评分标准从 1 到 5 分改成「是/否」的布尔问题;
- 4. 把延迟、token、成本、工具调用次数纳入同一次评测;
- 5. 冻结 golden dataset,一次只动一个变量;
- 6. 让 trace 走 OpenInference 这类开放约定,别和编排框架绑死。
指南原文在 Google 开发者博客,工具包在 GoogleCloudPlatform 的 professional-services 仓库;开头提到的 AI Agent Clinic 视频里,他们用 60 分钟给一个 LangGraph Agent 现场搭完了整条流水线。
评测体系不需要一步到位,能重复就是好的开始。