智谱上线 GLM-5.3-FlashX,推理速度最高 200 tokens/s,较 GLM-5.3-Flash 模型提速 5 倍,价格提价 2.5 倍,API 同步开放。这背后是在 10 万张国产芯片提供的推理算力基础上,进一步加大对 Infra 侧的投入与推理优化。
GLM 的 Infra,由 GLM 构建
跑 Flash 的这套 Infra,是由 GLM-5.3 驱动 Agent 构建的——从模型适配一路做到生产上线,前后不到两周,端到端吞吐做到了初始基线的 3 倍。
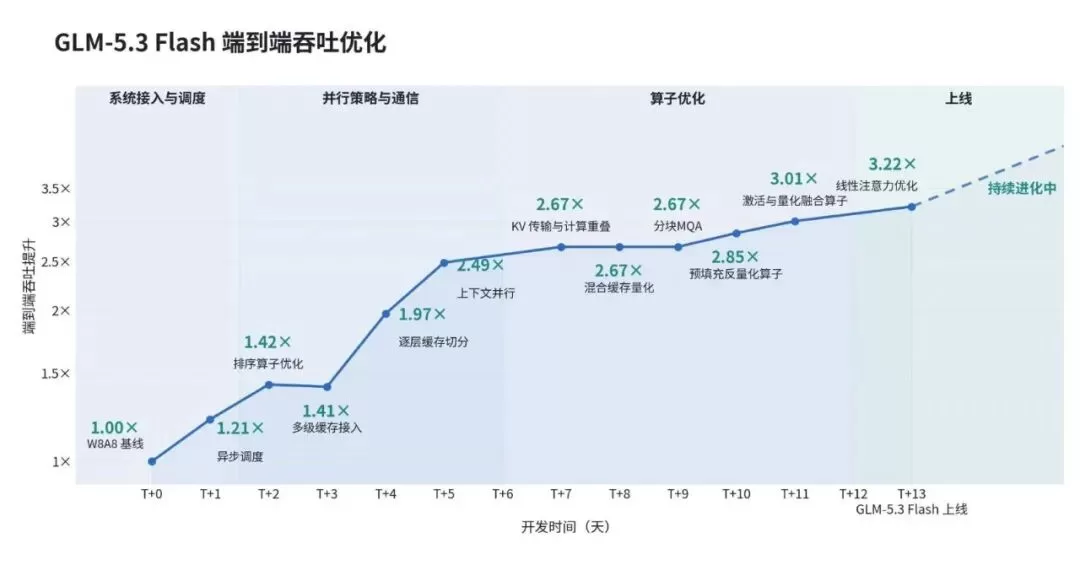
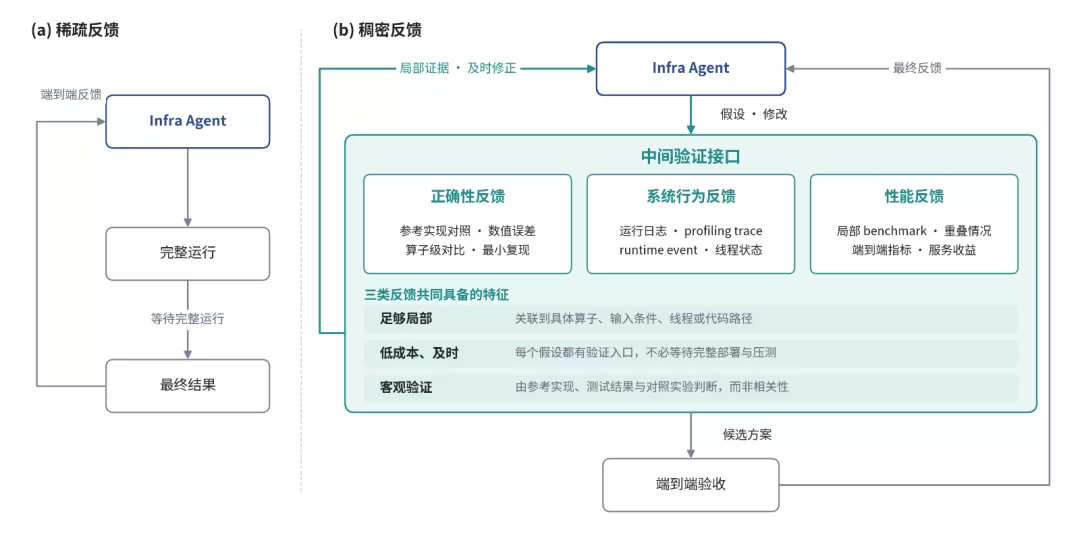
在构建过程中,人负责定目标、设边界、搭好反馈环境和关键修改审核,而测试、日志、Trace、微基准都交给 Agent。它自己查问题、改代码、跑实验,局部验证通过后再放回完整服务里验收,完成「稠密反馈」闭环。
三个优化案例
案例一:输入 FP32,计算却用了 TF32
KDA 的 CP 路径出现精度偏差,长上下文下尤其明显。Agent 顺着状态合并和更新过程排查,问题落在两处 tl.dot 上:输入是 FP32,计算却默认用了 TF32,误差逐步积累。修复方式是显式加上 input_precision="tf32x3",已合入 Flash Linear Attention 上游。
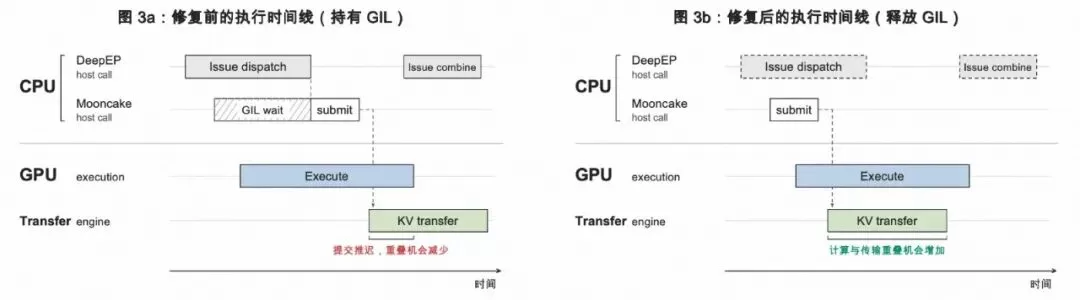
案例二:KV Transfer 被 GIL 卡住
同样的 workload,Prefill 加上传输后性能差距应不超过 5%,测试却跑出了 20% 以上。Agent 翻看 Trace,发现 KV Transfer 的 Python 侧执行始终没能和 DeepEP 的 dispatch/combine 调用重叠——DeepEP v1.2.1 的两处 C++ 调用没有释放 GIL,负责 Mooncake Transfer 的 Python 线程拿不到锁。修复后,性能差距降到 1% 以内。
案例三:同一组计算做了四遍
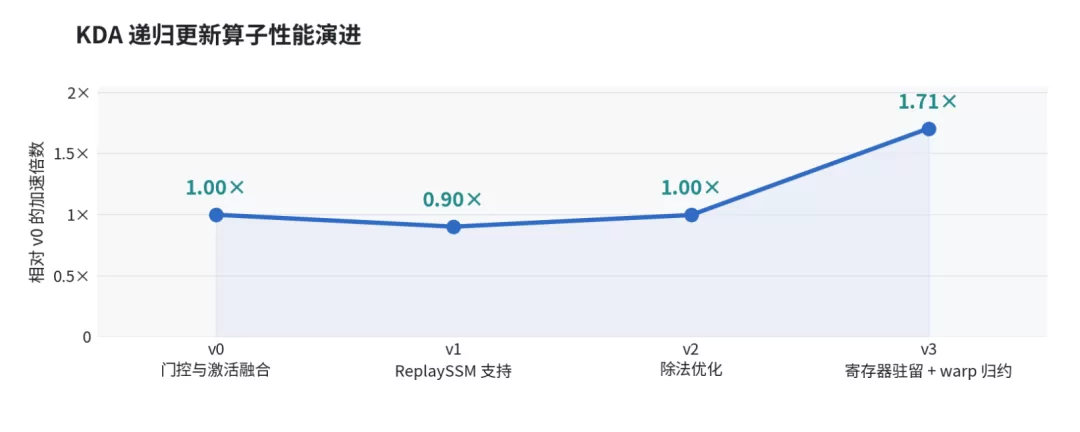
KDA Decode 沿 V 维度分块,同一组 FP32 归一化和门控计算被不同分块重复做了四遍。Agent 把分块合到同一线程块里,提前批量计算并共享中间结果——并行度少了一些,但重复计算去掉了,算子性能提高到优化前的 1.71 倍。