逛 GitHub 时发现一个有意思的开源项目——VoiceStudio,一款装在电脑上的本地语音工作室。用几秒录音就能克隆声音,然后用这个声音朗读文字、给视频配音、制作有声书,还能实时转文字。所有处理都在本地进行,不上传云端,不按字数收费,也不需要注册。

VoiceStudio 对标的是 ElevenLabs——一个按字符收费的云端语音合成服务。VoiceStudio 把这些能力搬回本地,装好就能用。项目已获 3.2 万 Star,支持 646 种语言变体。
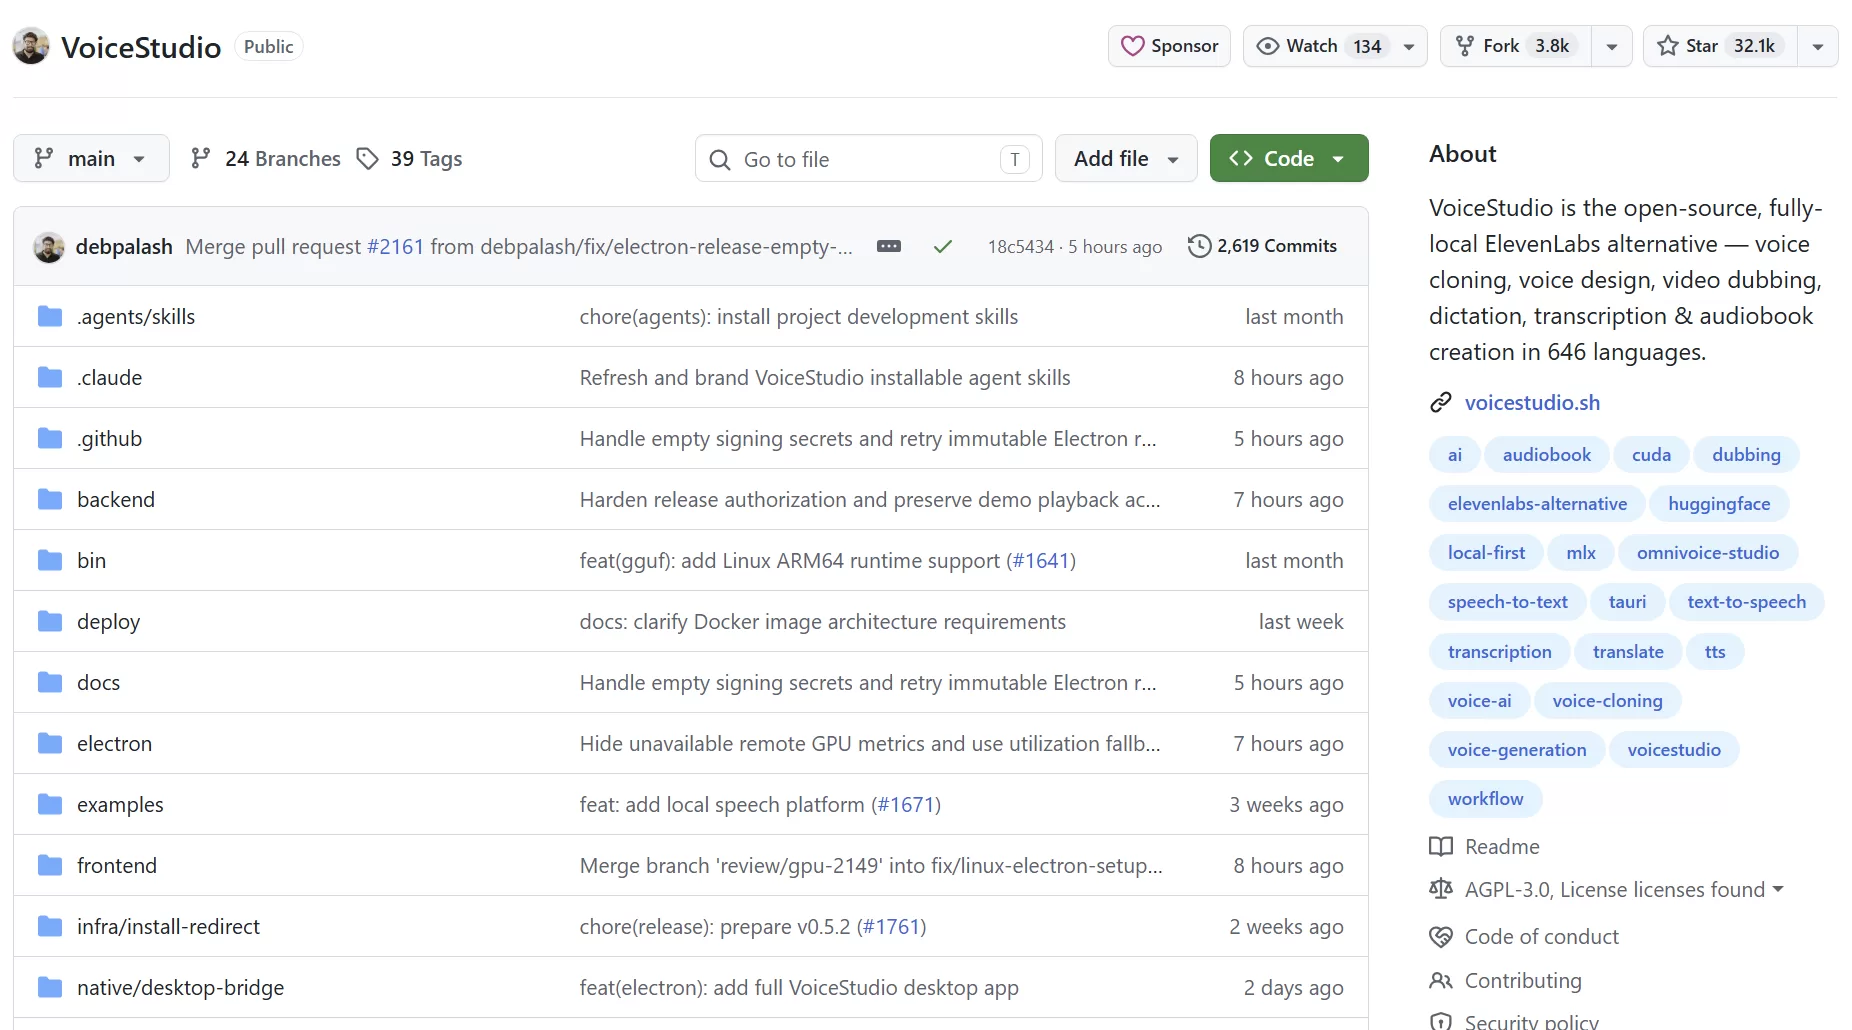
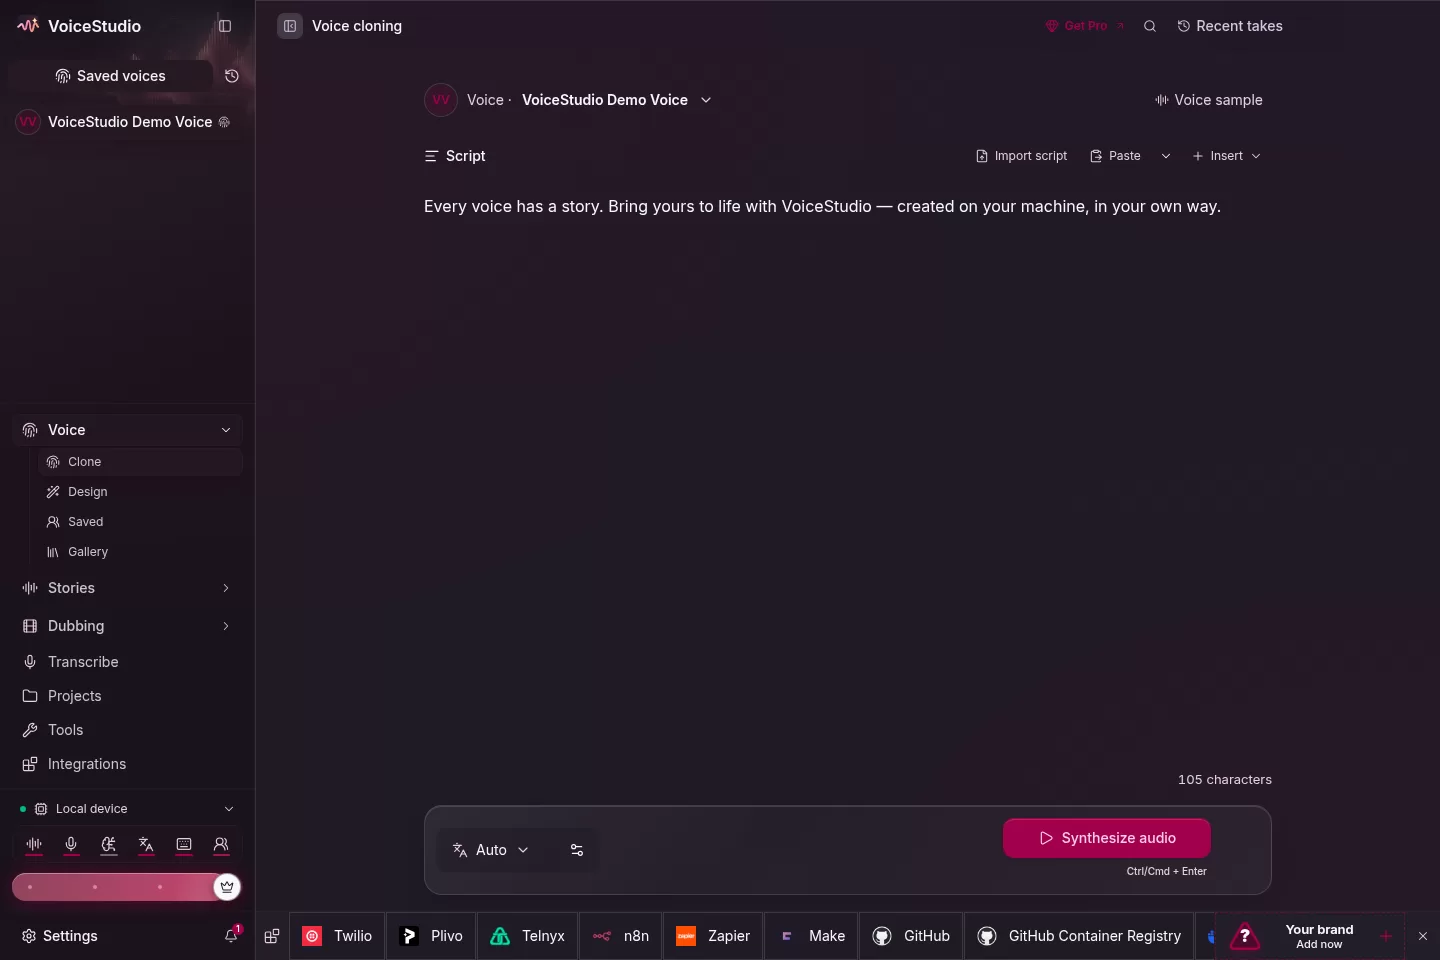
几秒钟录音克隆声音
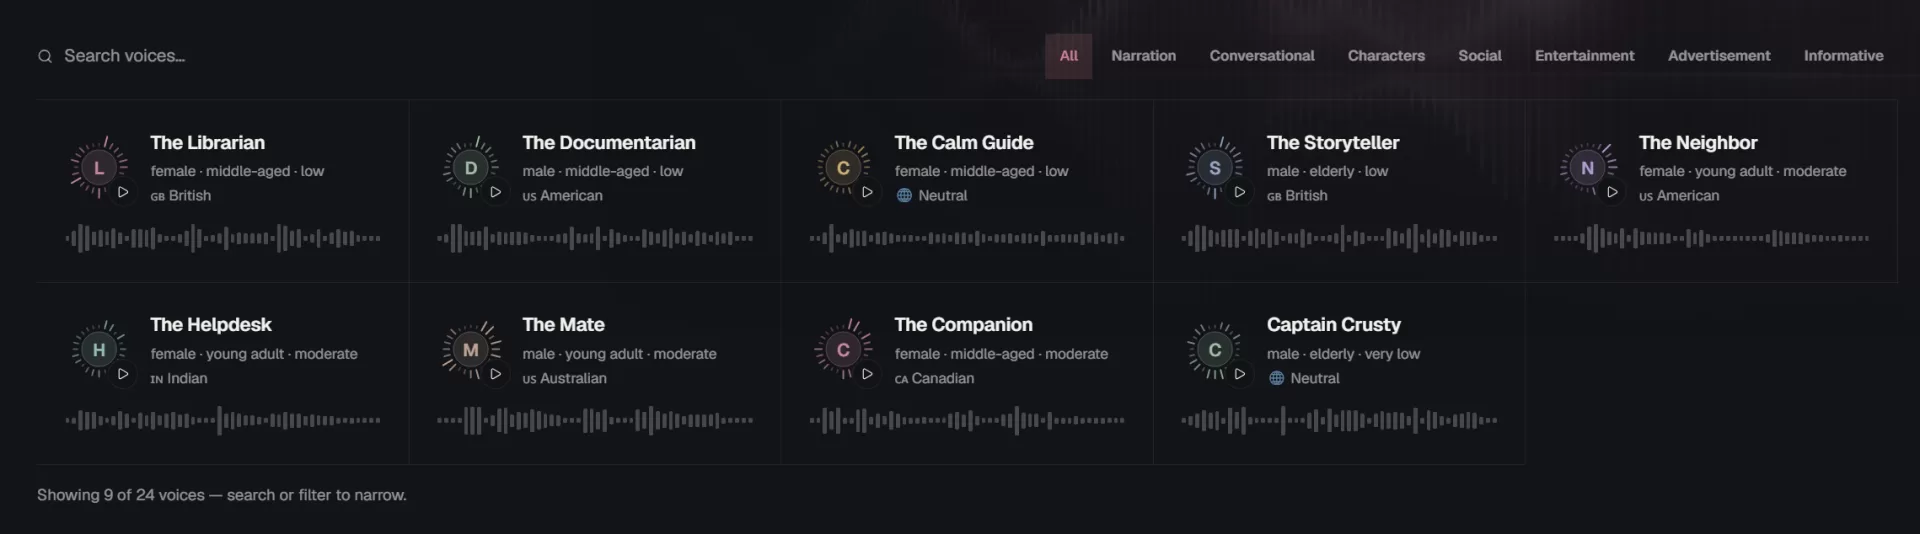
上传 3-15 秒的清晰录音就可以克隆声音。官方也提供了一些预置音色可选。然后输入任意文字,都会用这个声音读出来。
给视频换一种语言
导入视频后,自动转录、翻译、区分说话人,然后用克隆声音重新配音并导出。多人对话根据说话人分配不同声音,背景音和人声分开处理,保留原片环境音。还支持批量排队和文件夹监听,新视频丢进去自动入队。
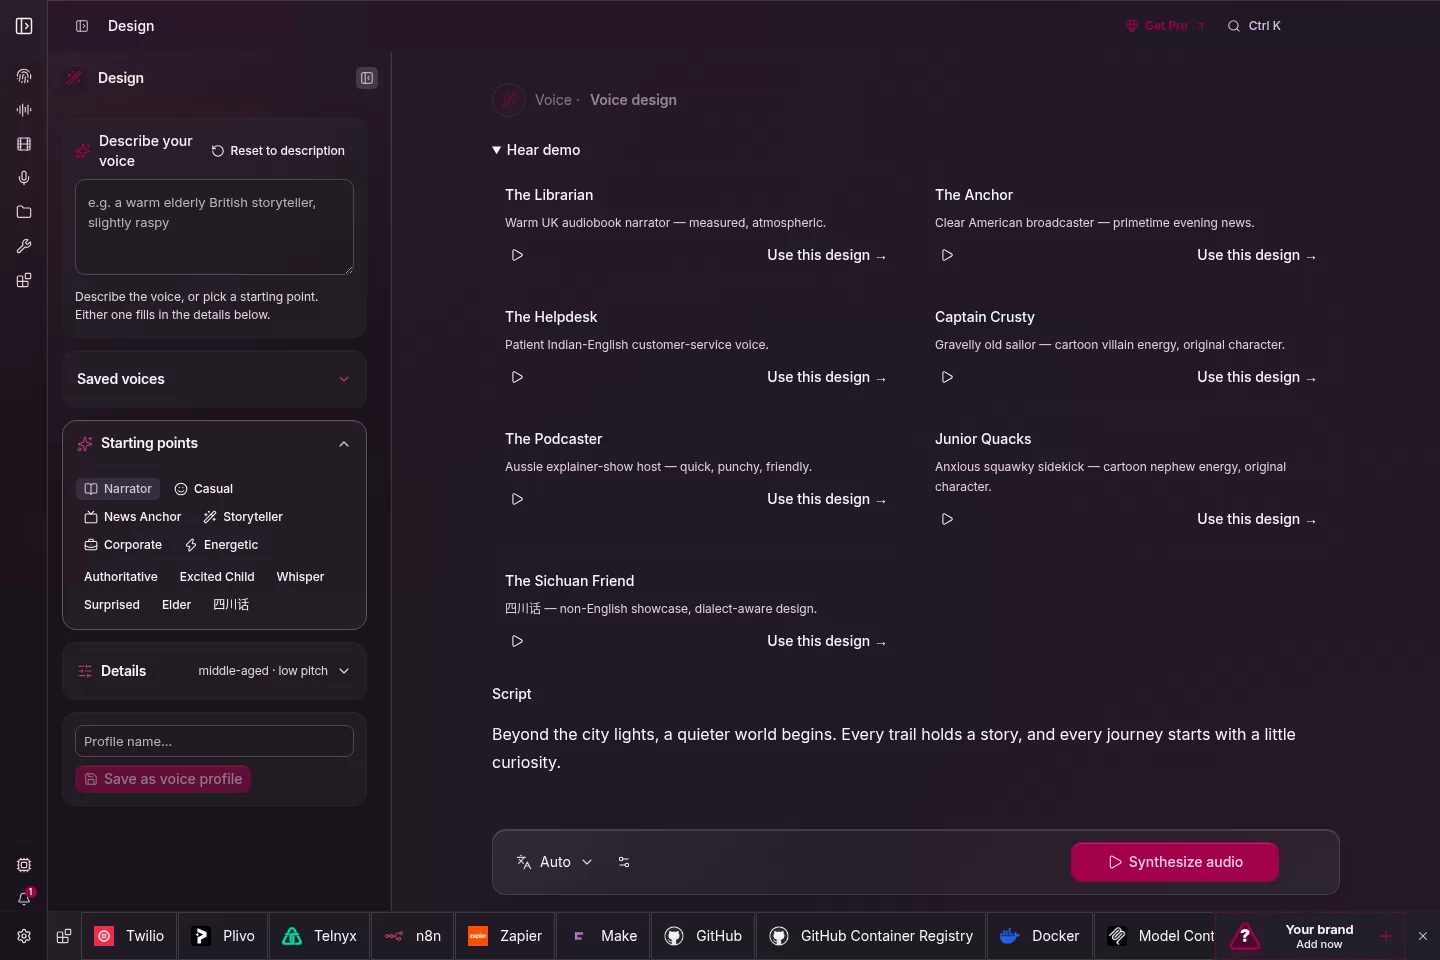
用文字描述一个声音
不想用自己的录音,可以用文字描述音色:性别、年龄、口音、音高、情感。它会生成一个全新的虚拟声音。
说话直接变文字
按下全局快捷键,屏幕上出现悬浮录音条,说完自动转录,文字直接粘贴到光标所在应用,无需切换窗口。还可以导入 EPUB 或 PDF,给不同角色分配不同声音,分章渲染导出带有章节标记的 m4b 文件,字词跟随朗读高亮。
安装与上手
Windows、macOS(Apple Silicon)、Linux 都有桌面安装包,也可以源码运行或用 Docker 部署:
docker run -d --name voicestudio --restart unless-stopped -p 3900:3900 ghcr.io/debpalash/omnivoice-studio:0.5.2装好后先去模型目录下载引擎——内置 16 个语音合成引擎和 11 个转录引擎,一键安装,断点续传。
模型可从 Hugging Face 或国内镜像下载。还提供 OpenAI 兼容的本地 API,把客户端地址改成 http://localhost:3900,原来的 TTS 脚本就能指向本地引擎。也有 MCP 服务,Claude Code、Cursor 等助手可直接调用。
注意事项
许可证:应用本身 AGPL-3.0 开源,但模型权重各有许可。默认引擎预训练权重是 CC-BY-NC(不可商用),商用配音请换 Apache-2.0 许可的引擎如 CosyVoice 3 或 VoxCPM2。
硬件门槛:最低 8GB 内存、10GB 硬盘,CPU 可运行但较慢。推荐 16GB+ 内存、8GB+ 显存,大引擎单个模型需 12GB+ 磁盘。
伦理底线:克隆声音需取得本人同意,生成内容的责任由使用者承担。