做文档解析的模型,主流要 8B、14B 起步。
OXR 只用了 1.3B。
10 月 5 号开源,SoMark 团队做的,现在 1155 Star。
三大基准全拿第一,olmOCR-Bench、OmniDocBench、DocParsingBench。开源模型里,它解析速度也最快。
它把 PDF 和文档图转成 Markdown 或 JSON,带布局坐标,直接喂给 Agent。
1.3B 小模型,三榜第一,免费 API 直接调。
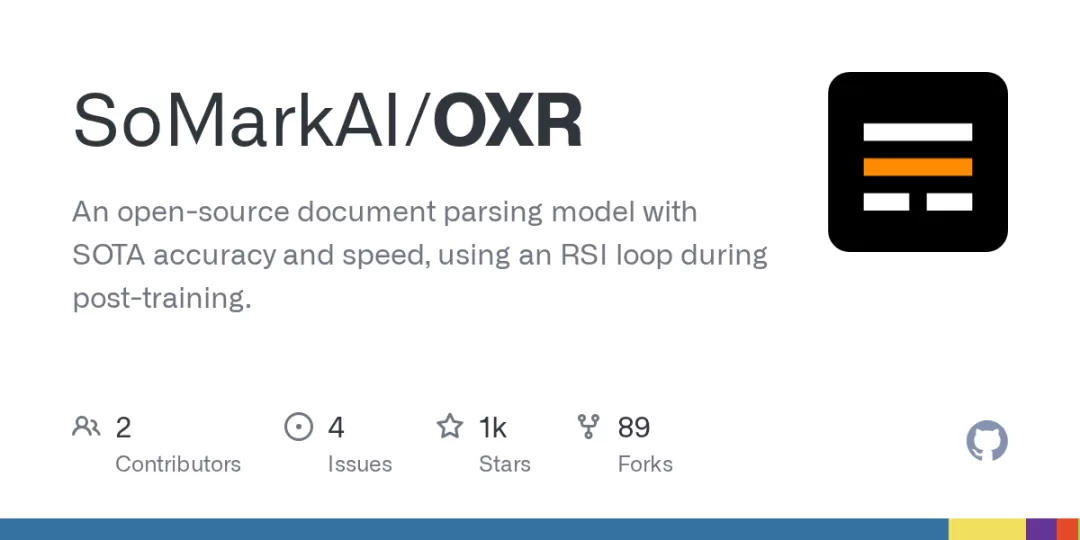
▲ OXR 仓库,1.3B 参数,三大文档解析基准第一。
0101 它解决什么
你想把 PDF、扫描件、试卷喂给 AI Agent 当资料库。
第一步永远是解析,把版式、表格、公式、图片位置都抽出来,变成结构化的 Markdown 或 JSON。
现在做这步有三个痛点。
模型大。 主流文档解析模型动辄 8B、14B,本地跑不动,云端调用贵。
布局写死。 大多数工具把版面分析焊死在识别模型里,换一套文档就得重训整套。
后训练靠人工标注。 错一个样本,人工标一遍,标注成本随规模涨。
OXR 把这三点都处理了。
1.3B 小模型,布局分析独立成可插拔模块,后训练用 RSI 自改进,模型自己找错样本补,不靠人工标注。
0202 它怎么做到 SOTA
2.1 双模型架构,布局分析可插拔
OXR 内部是两个模型分工:版面分析模型 + OXR 识别模型。
版面分析模块单独拆开,你可以换成自己训练的布局模型,识别和阅读顺序能力不变。
这是它设计上最有想象力的一点。
版面分析是最随场景变的。同样一份财报,做财务分析要拆出表格区,做归档要保留原文顺序。OXR 把这块做成接口,你换模型不用动主流程。
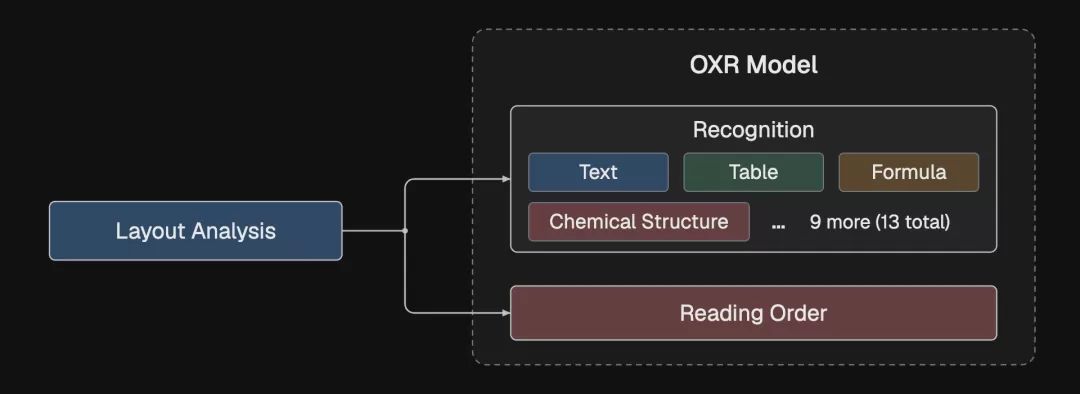
▲ 版面分析模型和识别模型各自可插拔,数据在中间流动。
2.2 RSI 自改进后训练
后训练阶段不靠人工标注。
模型先跑一遍,把识别弱的样本筛出来,喂回自己再训,循环往复。
注意,RSI 不是"模型训练完自己改代码",是在固定架构下自动找弱点再补。
迭代速度比人工标注快一大截。
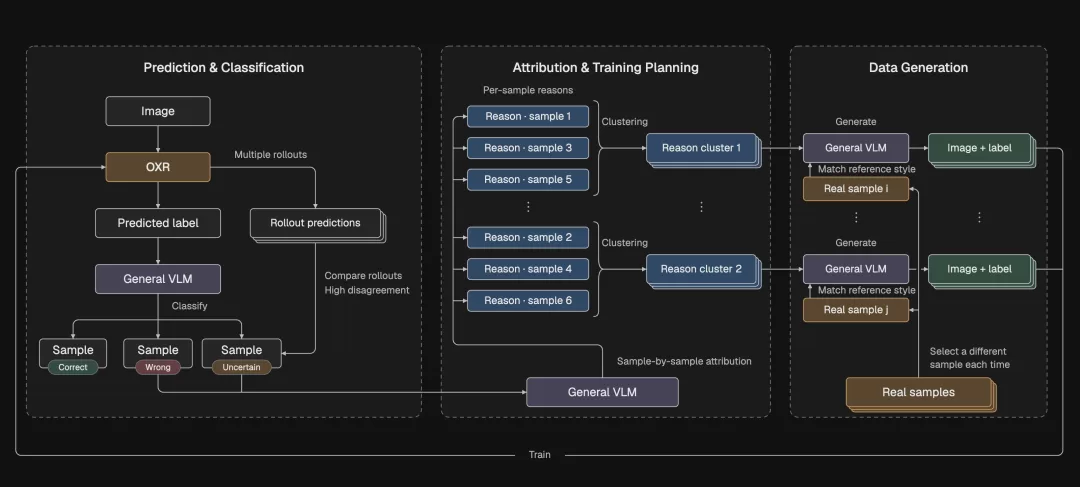
▲ RSI 循环:跑 → 找弱样本 → 补训 → 再跑,不靠人工标注。
2.3 13 类文档元素全认
正文之外,公式、化学式、代码块、表格、印章、手写体都识别,坐标齐全。
A3 试卷、复杂多栏这种难版面也测过。
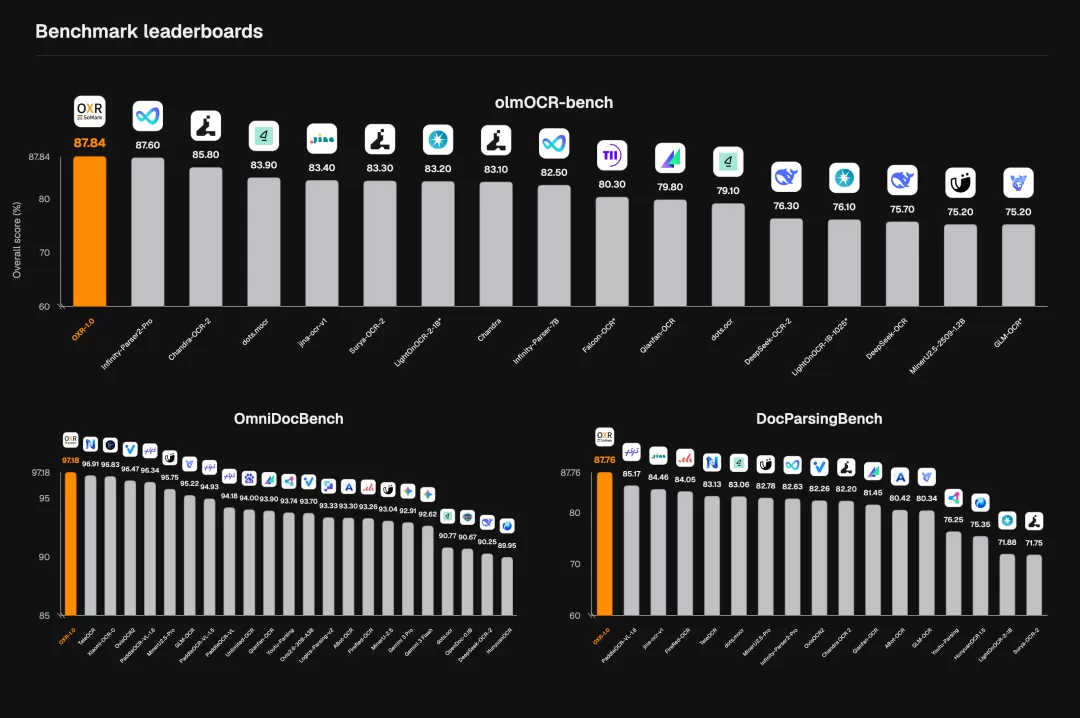
▲ olmOCR-Bench、OmniDocBench、DocParsingBench 三张榜单成绩。
0303 免费 API 怎么调
这是它上手最快的地方,不用申请 key,不用注册,curl 一条命令就调。
curl --fail-with-body https://free-oxr.somark.cn/api/v1/parse/sync \
-F 'file=@document.pdf' \
-F 'api_key=***' \
-F 'output_formats=markdown'
API 兼容 SoMark 官方 CLI,pip install somark 装好直接改 base URL。
somark --base-url https://free-oxr.somark.cn/api/v1 --api-key *** \
parse document.pdf --formats md,json --out ./parsed-output/
官方明说,免费 API 不保证稳定性,请求会排队,生产环境走本地部署。
0404 本地部署
硬件门槛不高。
NVIDIA GPU 24GB 显存起步,48GB 推荐,跑长文档 48GB 更稳。操作系统要 Linux,驱动支持 CUDA 13.0,Python 3.12。
git clone https://github.com/SoMarkAI/OXR.git
cd OXR
hf download SoMarkAI/OXR-1.0 --local-dir ./models/OXR-1.0
三种启动方式,按需选。
Docker 一键。docker build + run,最省事。
三服务拆分。 OXR 模型、版面分析、解析 API 各占一个进程,适合精细控制资源。
vLLM 推理。 官方 vLLM 还没原生支持,SoMark 给了个插件,vllm==0.25.1 直接用。
本地跑起来后访问 http://localhost:8000/demo,网页传 PDF 出结果,能看 Markdown 预览、布局框、阅读顺序。
实际用法,丢一份 50 页的财报进去,出来的 JSON 里每个表格、每个图的位置坐标都在。喂给 RAG 之前省掉整条版面分析链路。
0505 适合谁
适合。
想把 PDF 或扫描件批量转成 Agent 可消费数据的团队,免费 API 就能开始验证效果。
做 RAG、知识库、文档问答的产品,正缺底层文档解析能力。
需要自定义版面分析的开发者,可插拔设计比写死方案灵活。
显存只有 24GB 还想跑文档解析的个人,1.3B 参数刚好够。
不适合。
需要生产级 SLA 的场景。
要识别 13 类以外特殊元素的,比如医学影像、地图,得自己扩展。
在意 license 的商用项目。仓库协议是 NOASSERTION,非 MIT 或 Apache,商用前先把 LICENSE 文件通读一遍。
06写在最后
文档解析一直是 AI 工具链里偏脏的环节,没人愿意碰。
OXR 用 1.3B 的参数量做出三榜第一。可插拔布局、RSI 自改进、免费 API。
你手上有几百份 PDF 想喂给 Agent,先拿这个试一下。