大家好,今天介绍一个 NVIDIA 最近开源的项目 SoL-Pi——它做的事情很直接:想办法让 Coding Agent 少烧 Token。
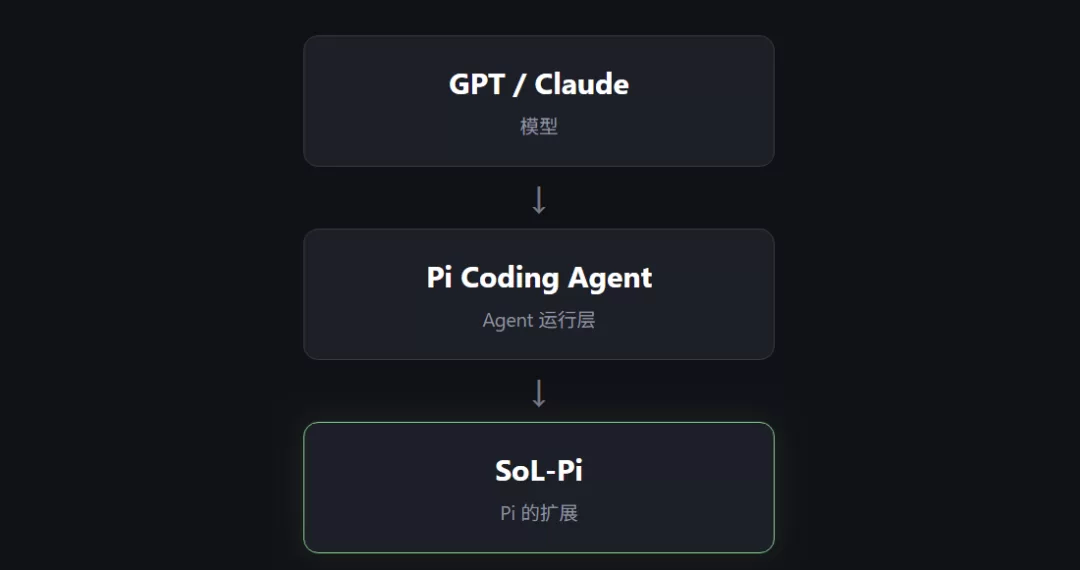
不过先说清楚:目前 SoL-Pi 并不是 Codex、Claude Code、Cursor 等通用插件,它只能作为 Pi Coding Agent 的扩展来使用。你可以让 Codex 帮你安装,但最后真正跑任务的,还是 Pi。
关系大致是:SoL-Pi 作为 Pi 的扩展层,优化其 Token 使用。如果你平时完全不用 Pi,目前这个项目还不能直接接入 Codex 或 Claude Code。
但它做的这套优化思路仍然值得了解。NVIDIA 自己测试下来,长任务中的 Token 使用量能减少 45%~49%,成本下降约三分之一,同时保留 Pi 约 94% 的平均任务得分。也就是说,它省的主要是重复工作,而不是少干活。
先让 Agent 研究如何优化 Agent
SoL-Pi 的几个核心功能不是随意添加的。NVIDIA 先让 Agent 自己去寻找答案:当前的 Coding Agent 到底哪一部分最浪费?最初,Agent 找到了 152 个优化点,经过一轮又一轮试验、验证和淘汰,最后留下了 4 个机制。
改完代码,顺手把测试也跑了——Action Fusion
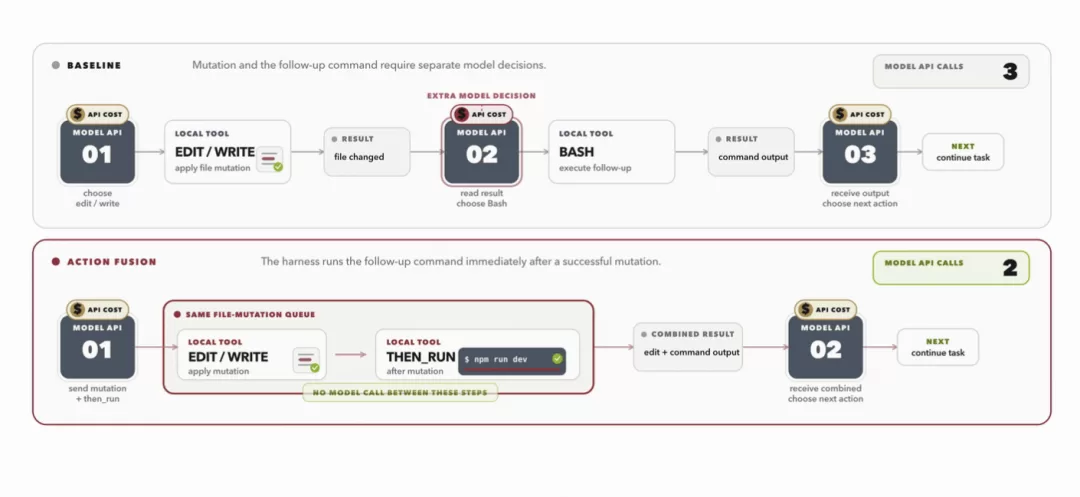
第一个机制叫做 Action Fusion。Agent 修改完代码后,通常下一步就是跑测试。
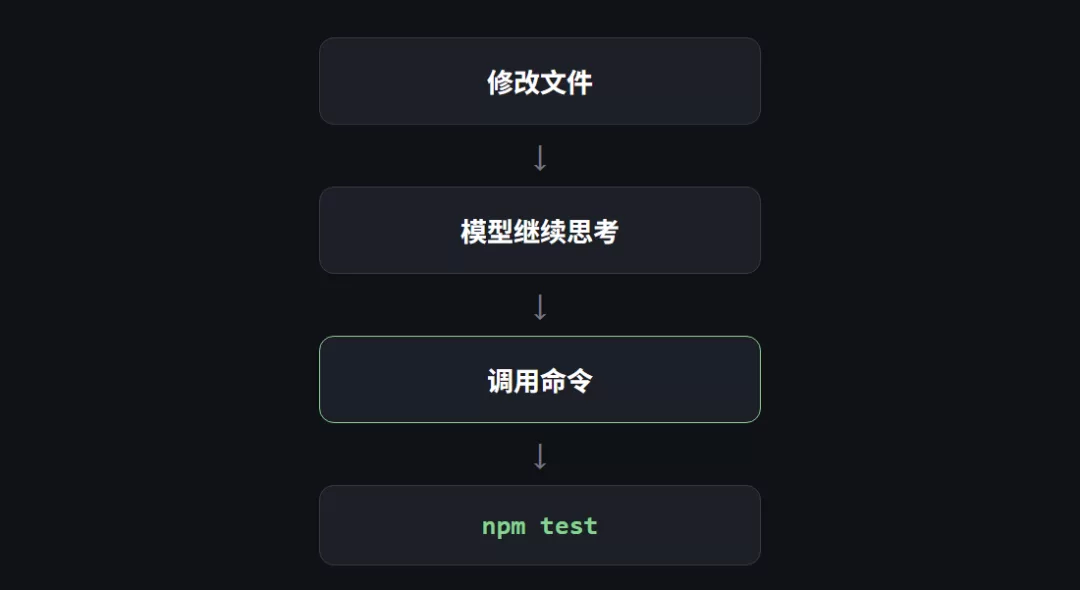
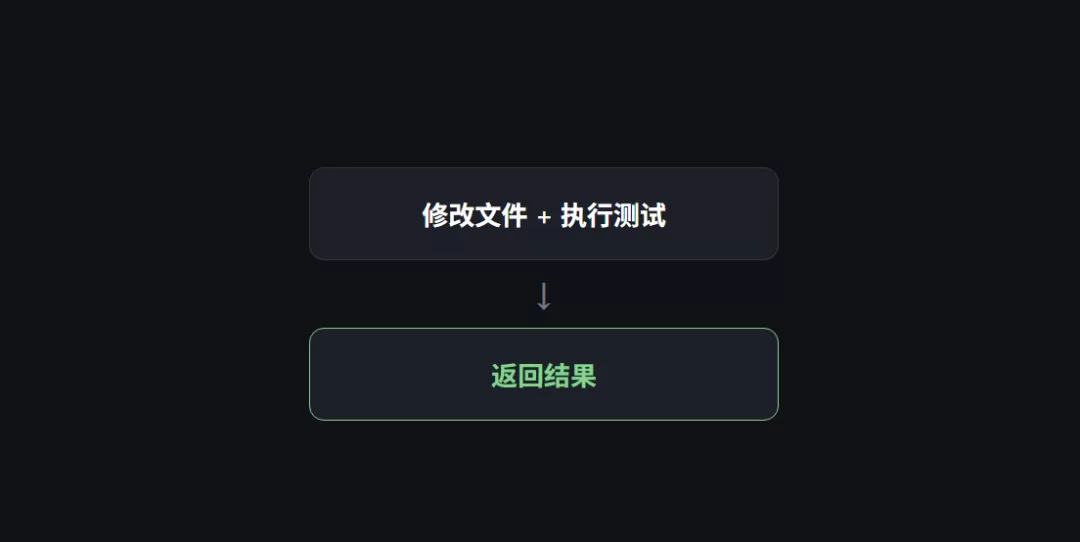
SoL-Pi 会把"修改代码"和"运行测试"两个动作合并为一个动作,这样就少了一次模型决策。单次看不多,但在一个长任务中这样的操作会反复出现。
几千行日志,不用每轮都重新塞给 AI——ObservationPack
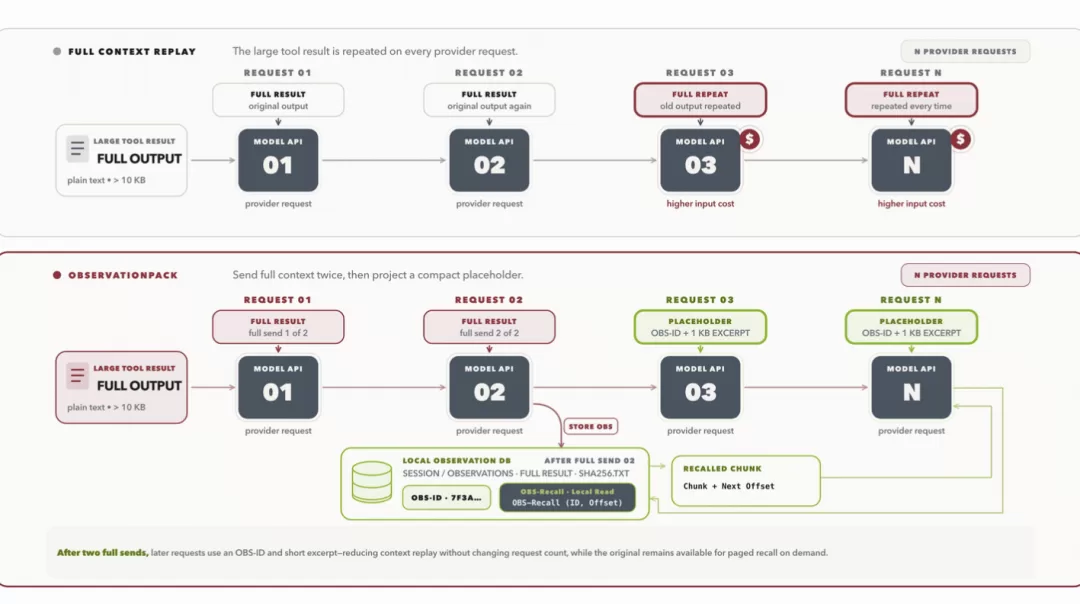
第二个机制叫 ObservationPack,非常实用。比如 Agent 刚刚读完了 4000 多行的编译日志,一般情况下在继续执行任务时,这些内容会再次被加入到上下文中。
SoL-Pi 会把完整答案保存在本地,只在上下文中留下一个索引和少量摘要,类似:
[observation: build-log-032]
共 4287 行
需要时读取:1200-1250 行
原始内容没有丢失,但不需要在每一回合中都把几千行的内容重新发送给模型。官方对 ObservationPack 单独测试的结果是:API 费用降低约 24%,请求数量没有太大变化——节省下来的正是每次请求中重复的上下文。
5000 行日志,先挑出真正有用的——Evidence-Preserving Reducer
第三个机制叫做 Evidence-Preserving Reducer。比如一次编译输出 5000 行日志,真正有用的可能只有几行。SoL-Pi 会先让成本较低的模型在长日志中挑选出关键内容,再回到原始日志中进行核对,只有能对上才会把结果交给主模型。
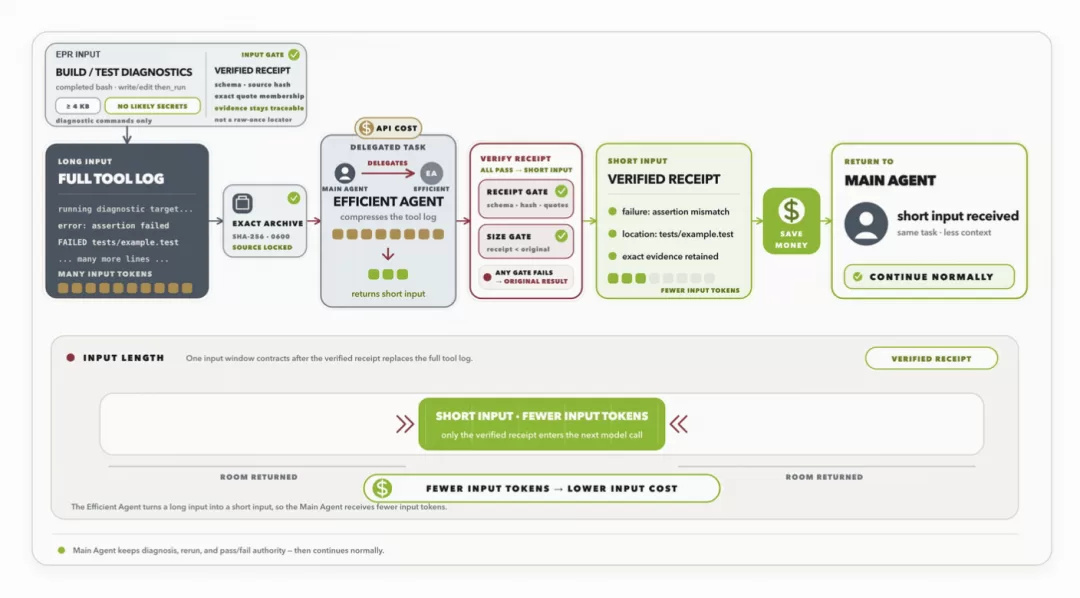
这样主模型就不需要每次都从几千行日志里找信息,也不会因为压缩而丢失重要错误。
最后到底省多少?
前面三个机制解决的其实是同一个问题:不要让最贵的模型去做已经做过的活。NVIDIA 在 EdgeBench 长任务上测试,SoL-Pi 相比原版 Pi:
- Token 使用量减少约 45%~49%
- 成本降低约三分之一
- 平均任务得分保留到 94% 左右
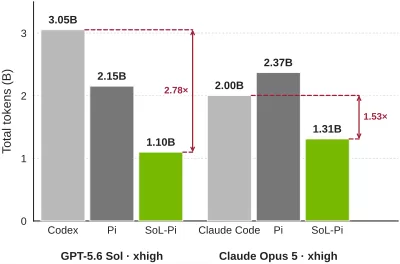
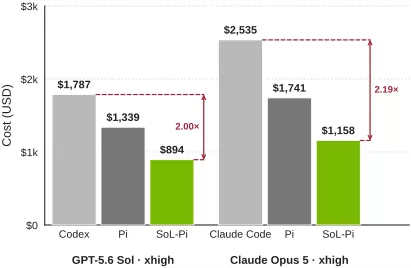
Agent 跑复杂任务时,Token 很容易浪费在几个地方:读的文件越来越多,日志也越来越多,前面看过的部分后面又反复出现。SoL-Pi 就是把这些地方一点一点地砍掉。
安装方法
SoL-Pi 需要运行在 Pi Coding Agent 中。官方测试环境:
- @earendil-works/pi-coding-agent 0.84.2
- Node.js ≥ 22.19
安装 Pi:npm install --global @earendil-works/pi-coding-agent@0.84.2
安装 SoL-Pi:pi install git:github.com/NVlabs/SoL-Pi
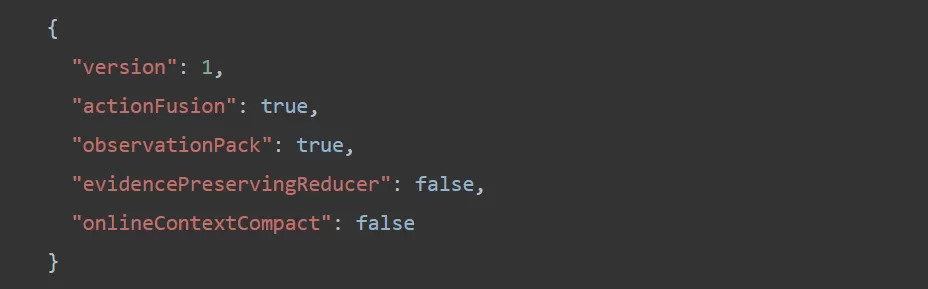
安装后优化默认不会全部打开。首次使用建议先开启两个效果明显的机制:ObservationPack(大结果回放)和 Action Fusion(减少重复调用)。
写在最后
SoL-Pi 目前最大的遗憾是只能和 Pi 一起用。如果后续官方能把 Codex、Claude Code、Cursor 等也接入进来,这套 Token 优化思路的价值会大得多。