10+年产品经理专注分享AI 工具、AI 资讯、AI Coding、Vibe Coding与下一代产品创新,按 Ctrl+D 收藏我们
关于我 留言板 标签云 排行榜

苏米客

  • 首页
  • AIGC
    • AI最新动态
    • AI学习教程
    • AI工具集合
    • AI产品百科
    • AI编程开发
    • AI提示词
    • AI开源项目
    • AI智能体
  • Axure
    • Axure动态
    • Axure教程
  • 产品
    • 用户体验
    • 产品设计
    • 苏米杂谈
  • 资源
    • 产品UI组件库
    • 开源图标库
    • 中后台框架
  • 书单
    • AI书籍
    • 用户体验
    • UI视觉
    • 产品研究
    • 其他类型
  • 下载
    • Axure组件
    • Axure原型
    • 文档报告
    • 素材资源
  • 登录
  • 首页
  • AIGC
    • AI最新动态
    • AI学习教程
    • AI工具集合
    • AI产品百科
    • AI编程开发
    • AI提示词
    • AI开源项目
    • AI智能体
  • Axure
    • Axure动态
    • Axure教程
  • 产品
    • 用户体验
    • 产品设计
    • 苏米杂谈
  • 资源
    • 产品UI组件库
    • 开源图标库
    • 中后台框架
  • 书单
    • AI书籍
    • 用户体验
    • UI视觉
    • 产品研究
    • 其他类型
  • 下载
    • Axure组件
    • Axure原型
    • 文档报告
    • 素材资源
当前位置: 首页 » AI最新动态

本地部署开源大模型最新王者 Qwen3.5 原生视觉语言模型,24G显存的本地模型优选

7月前 AI最新动态 2244 0

作为一个长期在一线体验和落地AI工具的产品经理,我最近把本地可部署的大模型又系统跑了一遍。

目标很明确:在24G显存的设备上,选择一款稳定、覆盖面广、能支持文本和图片的统一模型,用来支撑我的日常原型验证和智能体开发。

前面我分享了:手把手教你部署 OpenClaw + Ollama + GLM-4.7-Flash 的纯本地方案,实现无需服务器、无模型调用费用、离线可用的 AI 助手

Qwen3.5系列发布并开源之后,我觉得本地24G显存新选择多了一个:Qwen3.5-27B,也是不错的OpenClaw 搭配的本地方案,而且还多了视觉方案。

核心观点

  • 在24G显存下,Qwen3.5-27B表现更均衡:官方测评显示它与Qwen3.5-35B-A3B整体性能接近,但参数规模更小,更适合本地部署。
  • 相较GLM-4.7-Flash,Qwen3.5-27B在公开对比数据中更优,且是文本-视觉一体化模型,减少了文本模型与多模态模型切换的复杂度。
  • 实际使用中需控制上下文长度(建议不超过32k),否则在24G显存环境下容易因显存不足崩溃。

为什么现在写Qwen3.5

近期出现了更贴近国内使用习惯的本地智能助理(例如 CoPaw 这类),它们偏好在本地使用可开源、可控的模型做多模态任务。
Qwen3.5系列开放后,本地部署路线变得更完整:我可以用Ollama拉起一个统一的文本-视觉模型,替代之前“文本模型 + VL模型”的组合方案,减少切换、路由和工程复杂度。

Qwen3.5时间线与型号

  • 2026-02-16:Qwen3.5-397B-A17B(旗舰)发布。
  • 2026-02-24:开源Qwen3.5-122B-A10B、Qwen3.5-35B-A3B、Qwen3.5-27B三款模型。

从官方测评图(原文提供)看,Qwen3.5-35B-A3B和Qwen3.5-27B整体差距不大,Qwen3.5-27B在部分指标占优,且模型更小,因此更适合24G显存的本地部署。

差异化与适配性:我怎么选

模型 模态能力 显存要求(24G) 上下文长度建议 定位/适配 备注
Qwen3.5-27B 文本+视觉 可部署 建议 ≤32k 本地多模态统一;智能体调用图片与文本混合任务 官方评测优于GLM-4.7-Flash(来源于原文对比);模型体积更小
Qwen3.5-35B-A3B 文本+视觉 可部署(更紧张) 建议 ≤32k 性能接近27B;24G下更容易触发显存瓶颈 和27B性能接近,但体积更大
GLM-4.7-Flash 文本为主 可部署 更长上下文支持 需要更长上下文时的备选 此前在本地24G显存为优选;上下文能力强
Qwen3-30B-A3B-Thinking-2507(量化) 文本 可部署 中等 思维链场景、文本推理 早期结论的24G优选,后被GLM-4.7-Flash替代

选择建议:

  • 需要统一处理文本与图片:优先Qwen3.5-27B。
  • 需要更长的上下文窗口:考虑GLM-4.7-Flash。
  • 纯文本且强调推理链:可尝试Qwen3-30B-A3B-Thinking-2507(量化)。

说明:性能结论基于原文引用的官方数据与横向对比;不同评测基准、任务分布和量化方案会影响结果,落地前建议进行小样本验证。

本地部署步骤(Ollama)

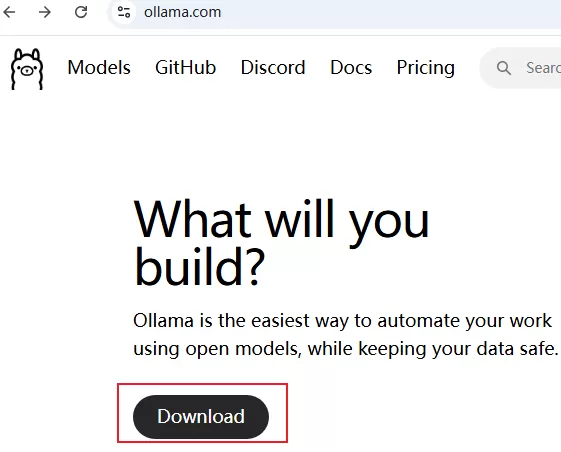
安装Ollama:前往官网 https://ollama.com 下载并安装。
下载模型:终端执行

ollama run qwen3.5:2

下载过程中若速度明显变慢,可 Ctrl+C 终止后重试;Ollama支持断点续传,通常能恢复到正常速率。

启动与使用:在Ollama界面或终端直接对话。
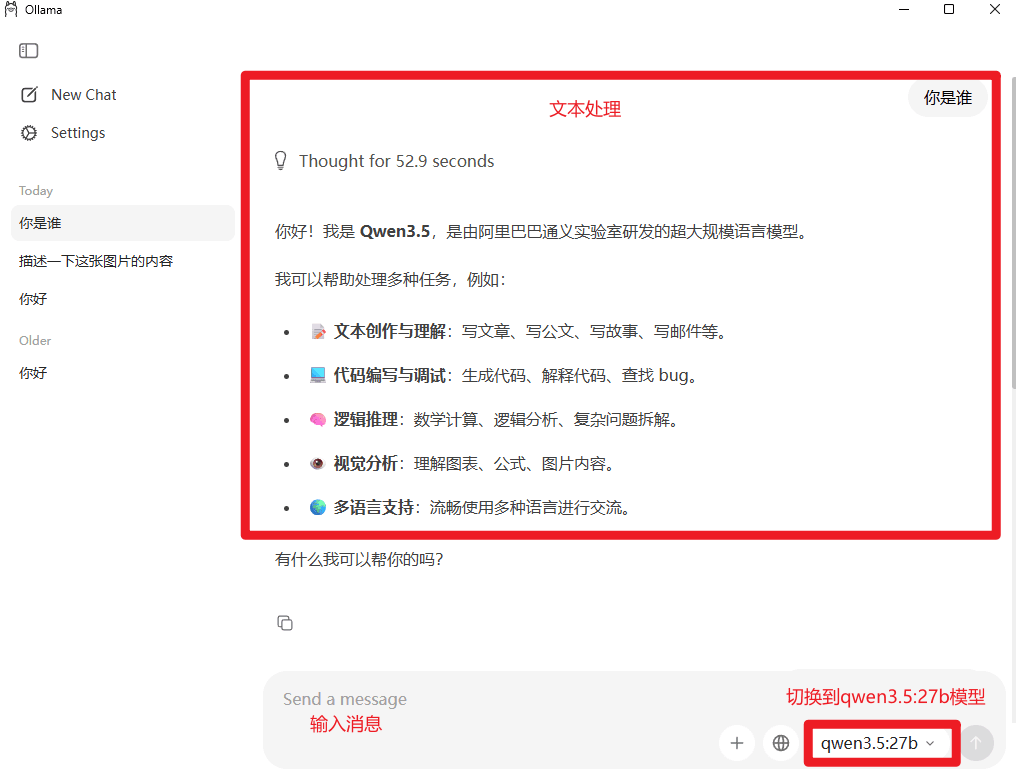
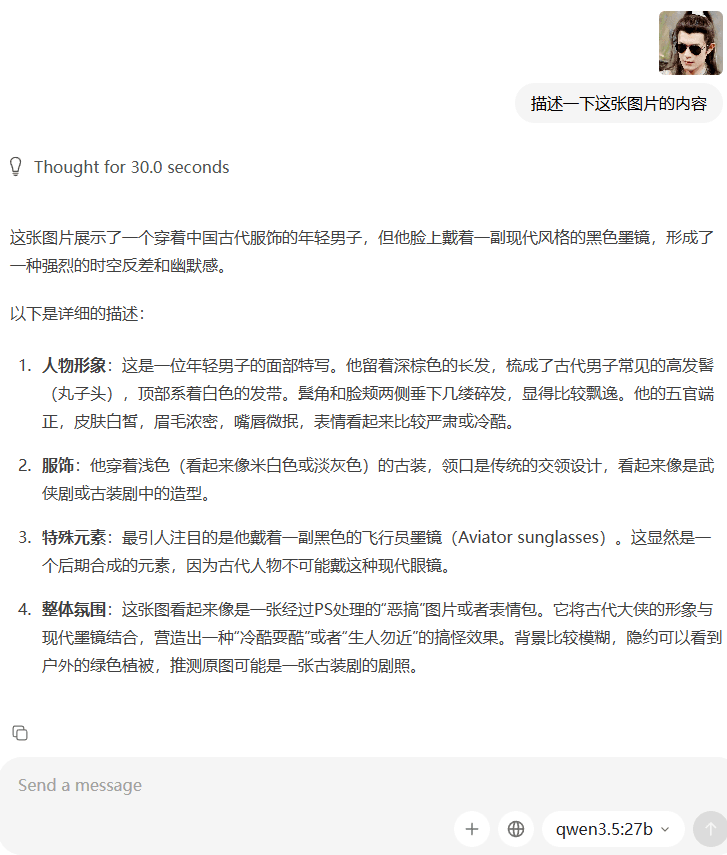
文本与图片混合任务可在同一模型内完成(图片理解)。
使用中的注意点

  • 显存与上下文:Qwen3.5-27B在24G显存下建议将context length设置在32k内,避免因显存不足崩溃(35B-A3B同理)。
  • 任务拆分:长文档或多图任务尽量分批处理(分chunk),减少显存压力,提高稳定性。
  • 量化与并发:若需并发或长会话,考虑量化版本与降低并发数;监控GPU显存波动。
  • 更大上下文需求:对长文检索或长会话,GLM-4.7-Flash依然是可选项。

我的实践体验

过去我在本地智能体里常用“两套模型”:文本模型负责理解、生成,VL模型负责图片解析,路由与切换较复杂。

换成Qwen3.5-27B后,工程链路更简单:一个模型即可完成截图+文本混合任务(例如在原型演示中,对界面截图进行结构化描述,再结合需求文档生成测试用例)。

体验中的问题也很直接:一次把上下文开到大于32k,几次触发显存不足导致中断。后来通过限制上下文、对长输入做chunk化、降低并发,稳定性明显提升。

生成速度上,27B的延迟可接受(与35B-A3B相近),但在图像解析时仍需给模型足够时间,不适合极端低延迟场景。

结尾总结

如果你和我一样,在24G显存的机器上做本地智能体原型迭代,Qwen3.5-27B是当前更稳妥的统一选择:性能与体积平衡、支持文本与视觉、减少工程复杂度。

上限更高的需求(更长上下文、更强并发)可以有GLM-4.7-Flash做补位。

我的原则是不追“绝对最强”,而是选择对目标任务和资源约束最合适的组合——在这点上,Qwen3.5-27B值得优先尝试。

相关链接:

官方博客:https://qwen.ai/blog?id=qwen3.5
GitHub:https://github.com/QwenLM/Qwen3.5
Hugging Face:https://huggingface.co/Qwen
在线体验:https://chat.qwen.ai/
API服务:https://modelstudio.alibabacloud.com/
声明:本站原创文章文字版权归本站所有,转载务必注明作者和出处;本站转载文章仅仅代表原作者观点,不代表本站立场,图文版权归原作者所有。如有侵权,请联系我们删除。
未经允许不得转载:本地部署开源大模型最新王者 Qwen3.5 原生视觉语言模型,24G显存的本地模型优选
#Qwen3.5 #开源大模型 #视觉语言模型 
收藏 1
手把手教你如何在 OpenClaw + Docker 本地电脑部署实操教程
别把时间耗在选择上:OpenClaw 新手10问10答,部署路线推荐(直接照抄)
推荐阅读
  • Qwen3.8-Max 评测:自主编程 16 天、2.4 万亿参数,能否挑战 GPT?
  • OpenAI Workspace Agents 发布:GPTs 已死,云端龙虾限时免费至 5 月 6 日
  • Grok Build 被曝偷偷上传用户代码仓库,含 SSH 密钥和 API 凭证
  • Qwen-Image-3.0正式上线千问AI平台:Arena.ai文生图榜单国内第一,4.5k token复杂版面一次生成
  • ChatGPT Pro 降智应对指南:网页版被偷偷换模型?投屏方案解决降智问题
评论 (0)
请登录后发表评论
分类精选
Cursor 限制国内使用 Claude 等模型解决方案!
34358 1年前
学生/非学生:如何申请Cursor Pro免费会员,如何通过SheerID验证快速激活全攻略
30950 1年前
即梦AI图片2.1:一句话快速生成带中文的海报图,免费AI文生图、视频工具、AIGC创作工具
23614 1年前
注意!Cursor单设备登录新规:一个账户最多可以3台设备登录,且限制单点登录
23106 1年前
腾讯ima知识库skills上线:教你如何把腾讯 IMA 知识库接入 OpenClaw 一步打通
21501 6月前
国产大模型横向对比:Kimi K2.6、GLM-5.1、Qwen3、MiniMax M2 四大模型选型指南
19150 5月前
字节推出Trae CLI :Claude Code 和 Gemini CLI的国产平替 ?手把手教你如何安装Trae Agent
18758 1年前
Trae国内版,搭载 doubao-1.5-pro、DeepSeek R1/V3模型,对比 Trae 国际版有什么不同
18515 1年前
DeepSeek宣布:降价,最高降价75%!别错过这个优惠时段,赶紧充值
18296 1年前
刚刚!Cursor风控又加强了,可能是因为这个原因!
16690 1年前

文章目录

关于苏米客
分类排行
1 a16z 最新 AI 应用报告:美国 AI 付费用户仅 4.5%,头部 1% 贡献 20% 消费额
2 Anthropic 推出网络安全验证计划:三档权限开放 Claude 完整攻防能力
3 谷歌 Nano Banana 2.1 上线:基于 Gemini 3.6 Flash,价格减半但排行榜未超 OpenAI
4 Nano Banana 2.1 发布:设计感提升、蒙版编辑、主体一致性,价格减半
5 Cloudflare Agent 基础设施一站式配齐:Clef 决策模型 + Clef-flash + cf CLI
6 Anthropic 投入 1 亿美元成立 Claude 前沿学院,2027 年底前培训 1 万名 FDE 工程师
7 Claude Fable 5.5 疑似偷跑:路由灰度机制解析,一句话自测验证
8 DeepSeek Harness 加入 Claude Code Mods 兼容:一切皆插件的架构验证
9 Karpathy 提出 AI 输出四级玩法:约束文字、生成图表、交互网页、解释视频
10 Karpathy:当AI产出超过人类阅读速度,别再让模型写更多文字
苏米客
登录 注册
显示
没有账号? · 立即注册
显示
已有账号? · 直接登录
登录代表你已同意 用户协议 和 隐私政策
©2015-2024 苏米客XMSUMI 版权所有 · WWW.XMSUMI.COM 闽ICP备14005900号-6 网站地图 百度地图
微信文章助手 程序库 免费影视APP 免费字体下载 产品经理导航 爱克硕儿 产品经理AI资讯 Axure元件库下载 申请友联