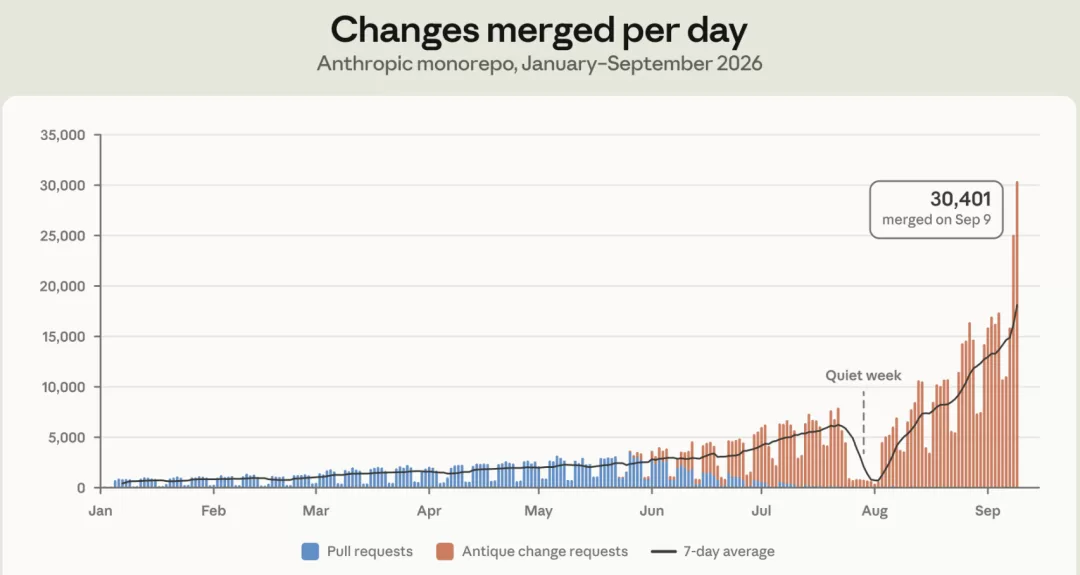
当 AI 编程效率呈指数级增长,原本为人类开发者设计的工具链开始全面失效。Anthropic 内部每天代码合并次数从 2500 次暴涨到 30000 次,Git 直接被撑爆——每天 600PB 流量,谁受得了?
Anthropic 的解法是:7 个人用 Claude 在 5 个月内从零自研了一套全新的版本控制系统 Scion,彻底抛弃 Git 的基本假设。这不是优化,是重构。
Git 为什么被撑死
Anthropic 使用超大单体仓库(Monorepo)模式,主分支历史接近 100GB,压缩后的工作副本超过 25GB。为支持密集的 CI 测试、研究任务和智能体沙盒,每天执行约 2500 万次代码检出(checkout)。如果直接用 Git,每天产生的网络流量会超过 600PB。
Git 的核心设计假设是"每个客户端都是独立完整的仓库",适合人类在离线环境下工作。但 Anthropic 几乎所有客户端都是永远在线的 AI 智能体,Git 的去中心化特性反而成了规模扩张的最大障碍。
他们尝试过所有常规方案:浅层克隆、稀疏检出、对象存储快照、甚至在内网部署了几百个 Git 镜像节点。最终发现,镜像越来越多,机器内存和磁盘开始顶不住,快照更新速度跟不上代码合并速度。
Scion 的四大核心设计
1. 客户端不存完整副本
Scion 把所有计算推给服务端:历史查询、行变更定位、代码合并、变基(rebase)全在服务端跑完。客户端只维护有限的本地对象缓存,其余数据随用随取。
2. 变更集(Changeset)代替树指针
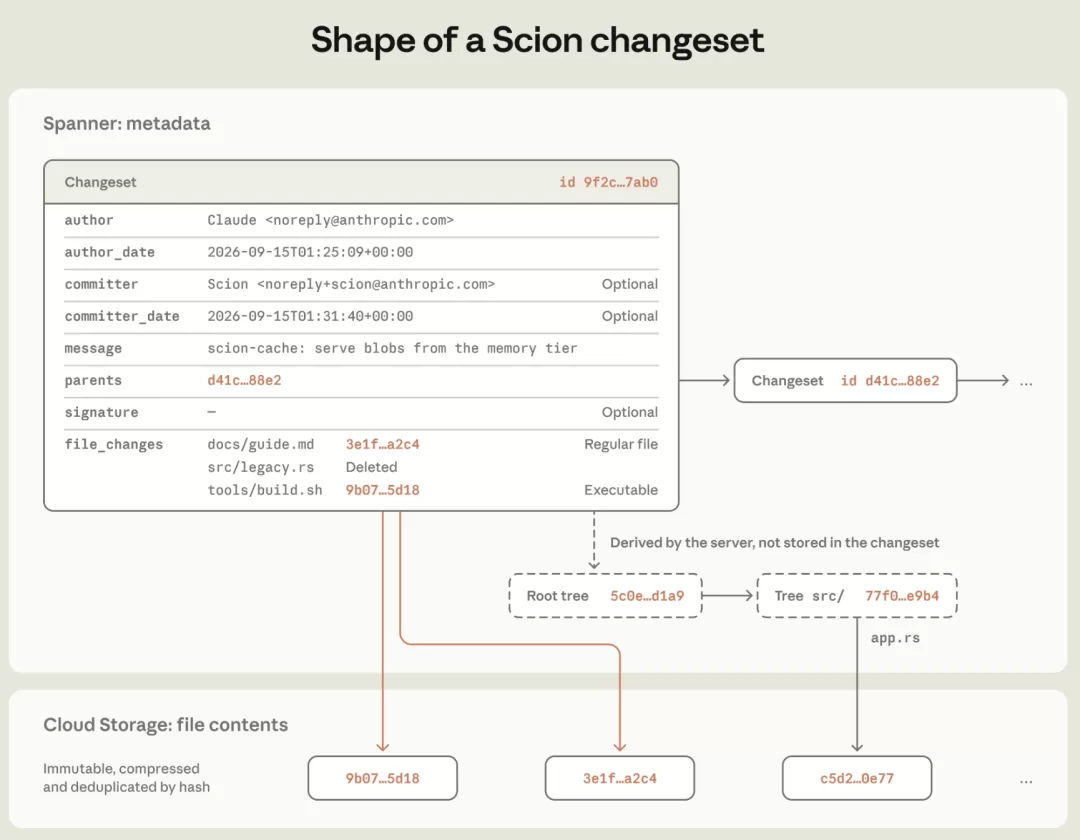
Git 每次提交都要保存对整棵目录树的指针。Scion 的最小工作单元是变更集——只记录当前变动相对于父节点的修改文件列表,以及指向云存储中压缩文件内容的指针。修改分支只需要在 Spanner 数据库里执行一次单行 CAS 操作。
3. 按需加载,无需全局拉取
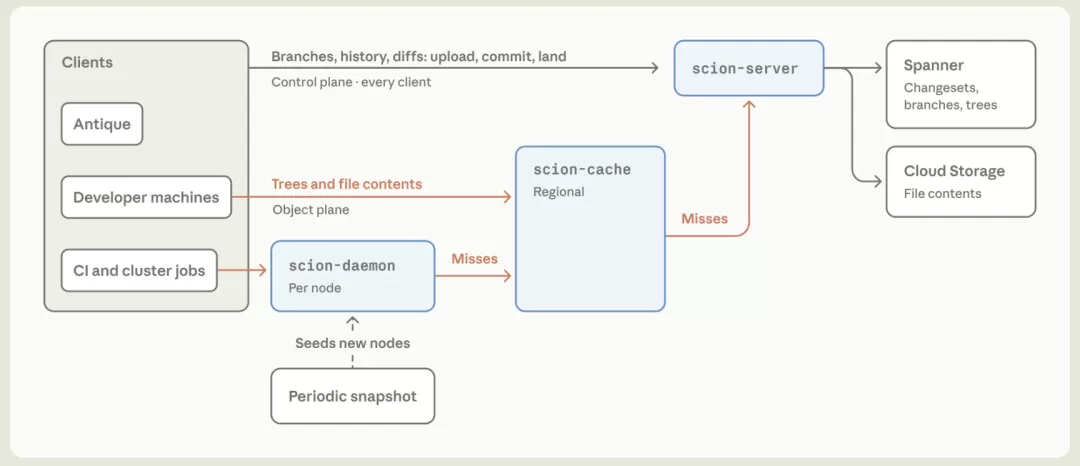
CI 跑自动化任务如果只需要看某次提交的 diff,直接通过 API 向服务端要结果。就算需要把文件落到本地磁盘,也采用虚拟化和稀疏检出机制——读到哪个文件才拉取哪个文件。
4. 层级缓存消灭流量
本地客户端 scn 只和本机的 scion-daemon 通信,daemon 向区域缓存服务器 scion-cache 请求数据,最后才兜底到核心的 scion-server 和数据库。每一层都实现了超过 99% 的缓存命中率。
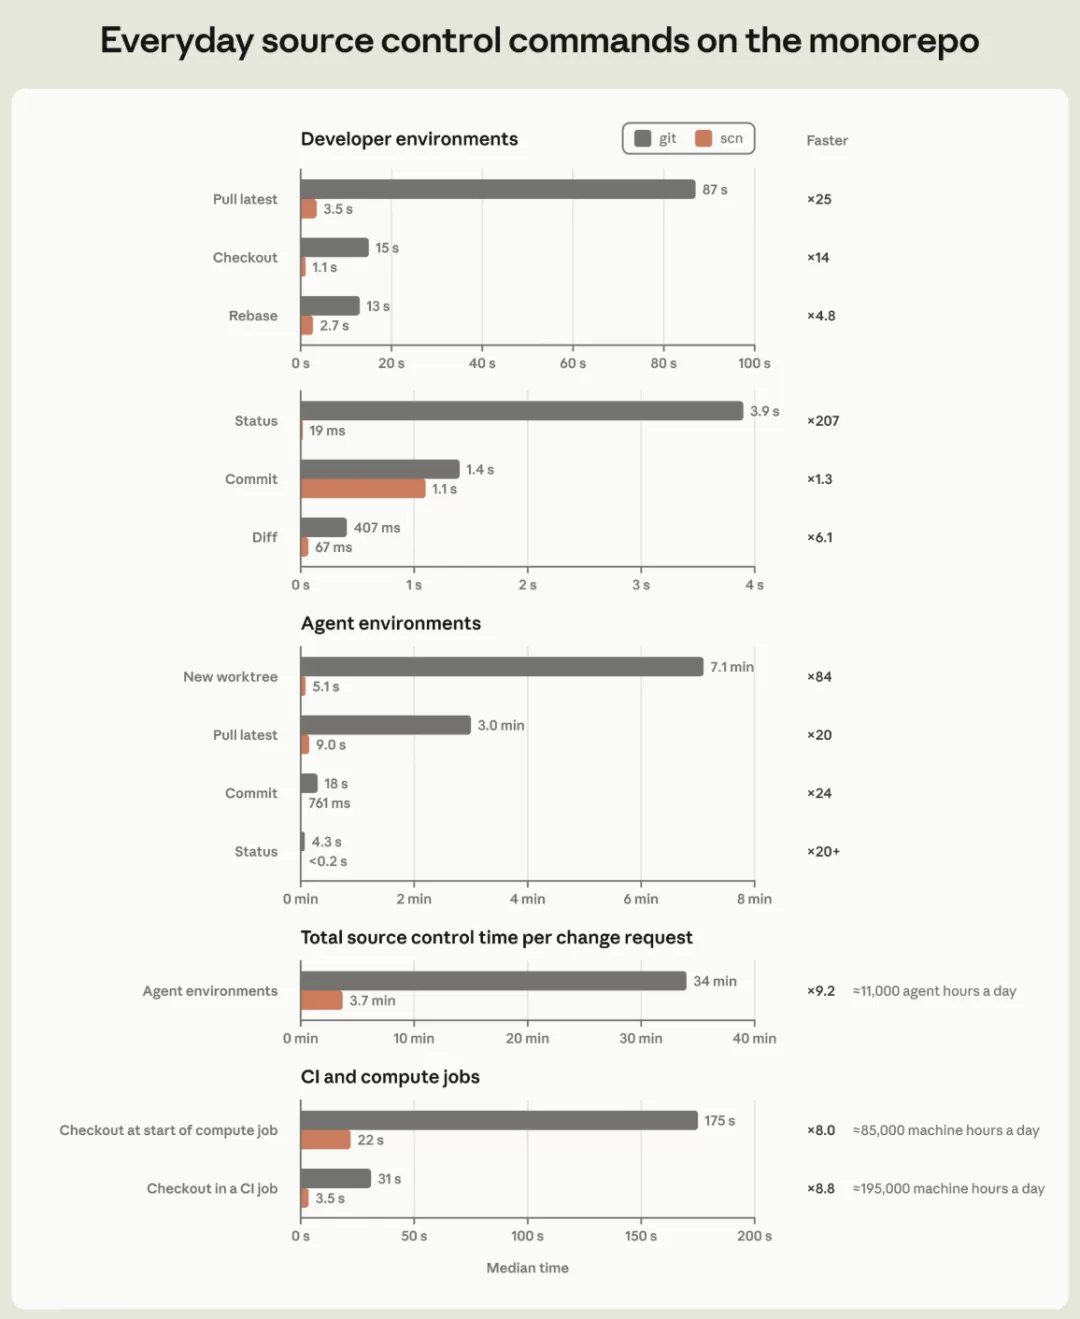
落地效果:代码检出速度从几分钟缩短到几秒钟,服务器 CPU 和内存占用缩减到原来 Git 镜像集群的 1/200,仅 CI 环节就省出了 25% 的 CPU 计算资源。
7 个人用 Claude 造出来的
整套系统的研发本身也是 AI 写代码的试验场。7 个人,5 个月,不仅完成了 Scion,还顺带自研了代码审查平台 Antigue 和代码搜索等半打系统。
典型例子是数据迁移流水线:团队最初手写了一版从 Git 到 Scion 的数据摄取管道原型,拿到 Claude Mythos 预览版权限后直接让模型重写。在没有任何额外提示词的情况下,Claude 重写的版本内存占用减少到 1/20,运行速度提升 4 倍,原有数据结构和摄取顺序规则完好无损。
参与项目的工程师表示:在写代码这件事上,Claude 现在的水平已经超过了自己。人类工程师的核心工作变成了"向 Claude 说不"——纠正 AI 为了局部需求而破坏底层约束的行为,把控跨系统设计的权衡,审核每次提交的意图,不再逐行肉眼挑刺。
传统工作流的瓦解
合并队列失效:当每分钟都有海量代码并发合并时,全局加锁排队会让 CI 系统瘫痪。Anthropic 取消全局合并锁,改成先合入、部署前跑自动化回归测试。代码冲突概率确实大幅增加,但 Claude 自动解决冲突的速度比人类看懂冲突发生在哪里还要快。
AI 当运维:团队利用 Claude Tag 在 Slack 里建了一批组件监视频道,每个频道进驻一个专门的 Claude 实例(称为 superfans),专门盯着 scion-daemon、scion-cache、合并队列等。这些 AI 拥有完整的日志和监控指标权限,能捕捉传统静态报警规则无法识别的微小异常。
Git 要被淘汰了吗?
Anthropic 明确表示没有把 Scion 开源替换 Git 的打算。Scion 完全绑定了极度庞大的单体仓库、海量 AI 智能体并发编程、以及远超普通企业承受极限的 Token 消耗量。对于绝大多数普通开发场景,Git 依然是极其优秀的版本控制工具。
但 Anthropic 判断:随着 AI 编程工具的扩散,接下来的 6 到 12 个月里,其他依赖 AI 写代码的团队也会陆续撞上这堵墙。