昨天刚分享了一篇国产模型订阅方案的对比,发完就有不少朋友问这几家国产模型要怎么选?刚好豆包工作已经把主流的国产旗舰模型基本都接进来了:豆包 2.1 Pro、DeepSeek V4 Pro 与 V4.1 Flash、Qwen 4 Max、Kimi K3.1 Pro、GLM 5.3 系列都能切换。
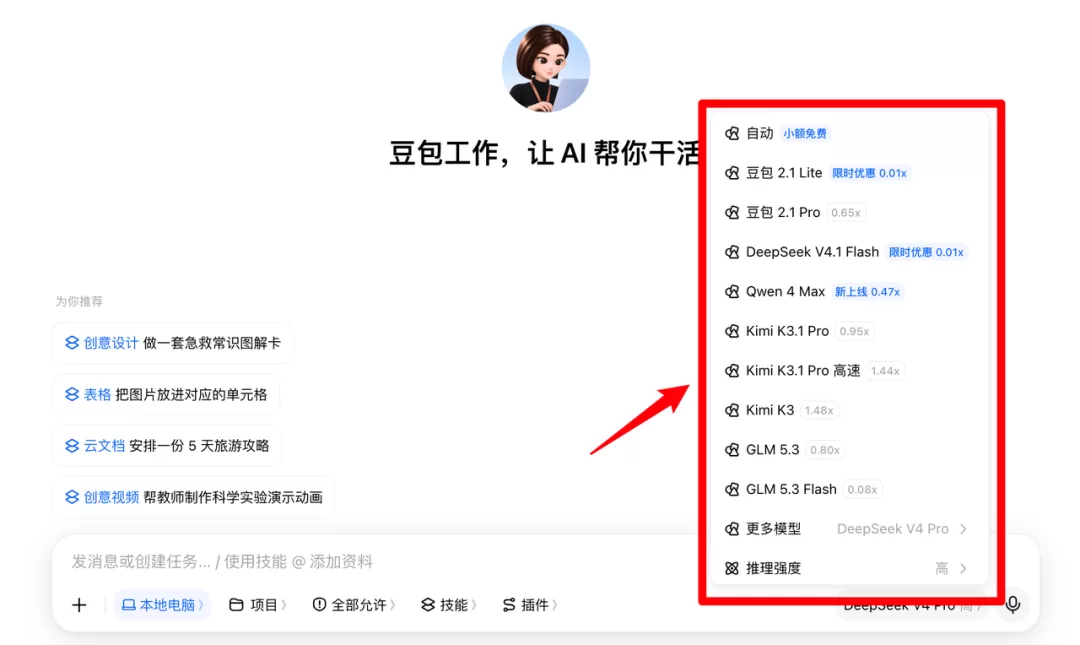
看到这么多模型,真的头大。我平时选模型主要就考量两件事:性价比和写作能力。性价比这块 DeepSeek V4.1 Flash 很能打,写作方面确实豆包 2.1 Pro 会更有人味一些。日常分工很固定:
- 日常编码:DeepSeek V4.1 Flash
- 主力写作:豆包 2.1 Pro
- 遇到卡点:Kimi K3.1 Pro 或 Qwen 4 Max
借着豆包工作这次升级,我决定给这几款模型做一个简单的横向测评。就发送一模一样的提示词,看一下它们的代码和写作水平到底如何。
测试前提
这轮评测全程在豆包工作里完成,分别切换 7 款模型:豆包 2.1 Pro、DeepSeek V4 Pro、DeepSeek V4.1 Flash、Kimi K3.1 Pro、Qwen 4 Max、GLM 5.3 和 GLM 5.3 Flash。每次测试都统一开启最高推理强度,发送完全相同的提示词:用 Three.js 程序化实现一只鹈鹕在 3D 场景中骑自行车的完整 HTML 文件,具备协调的肢体与机械运动。中途不追问,一次输出结果。
为了避免只凭一个人的印象下结论,所有产出的代码和文档,都采用了「个人主观体感 + 第三方裁判模型量化」结合的方式来测评。第三方裁判模型会从空间数学、图形质感、运行性能、引擎规范、工程六方面测评代码,从活人感、harness 遵循、逻辑、去 AI 腔、人设五方面测评写作。
代码实测
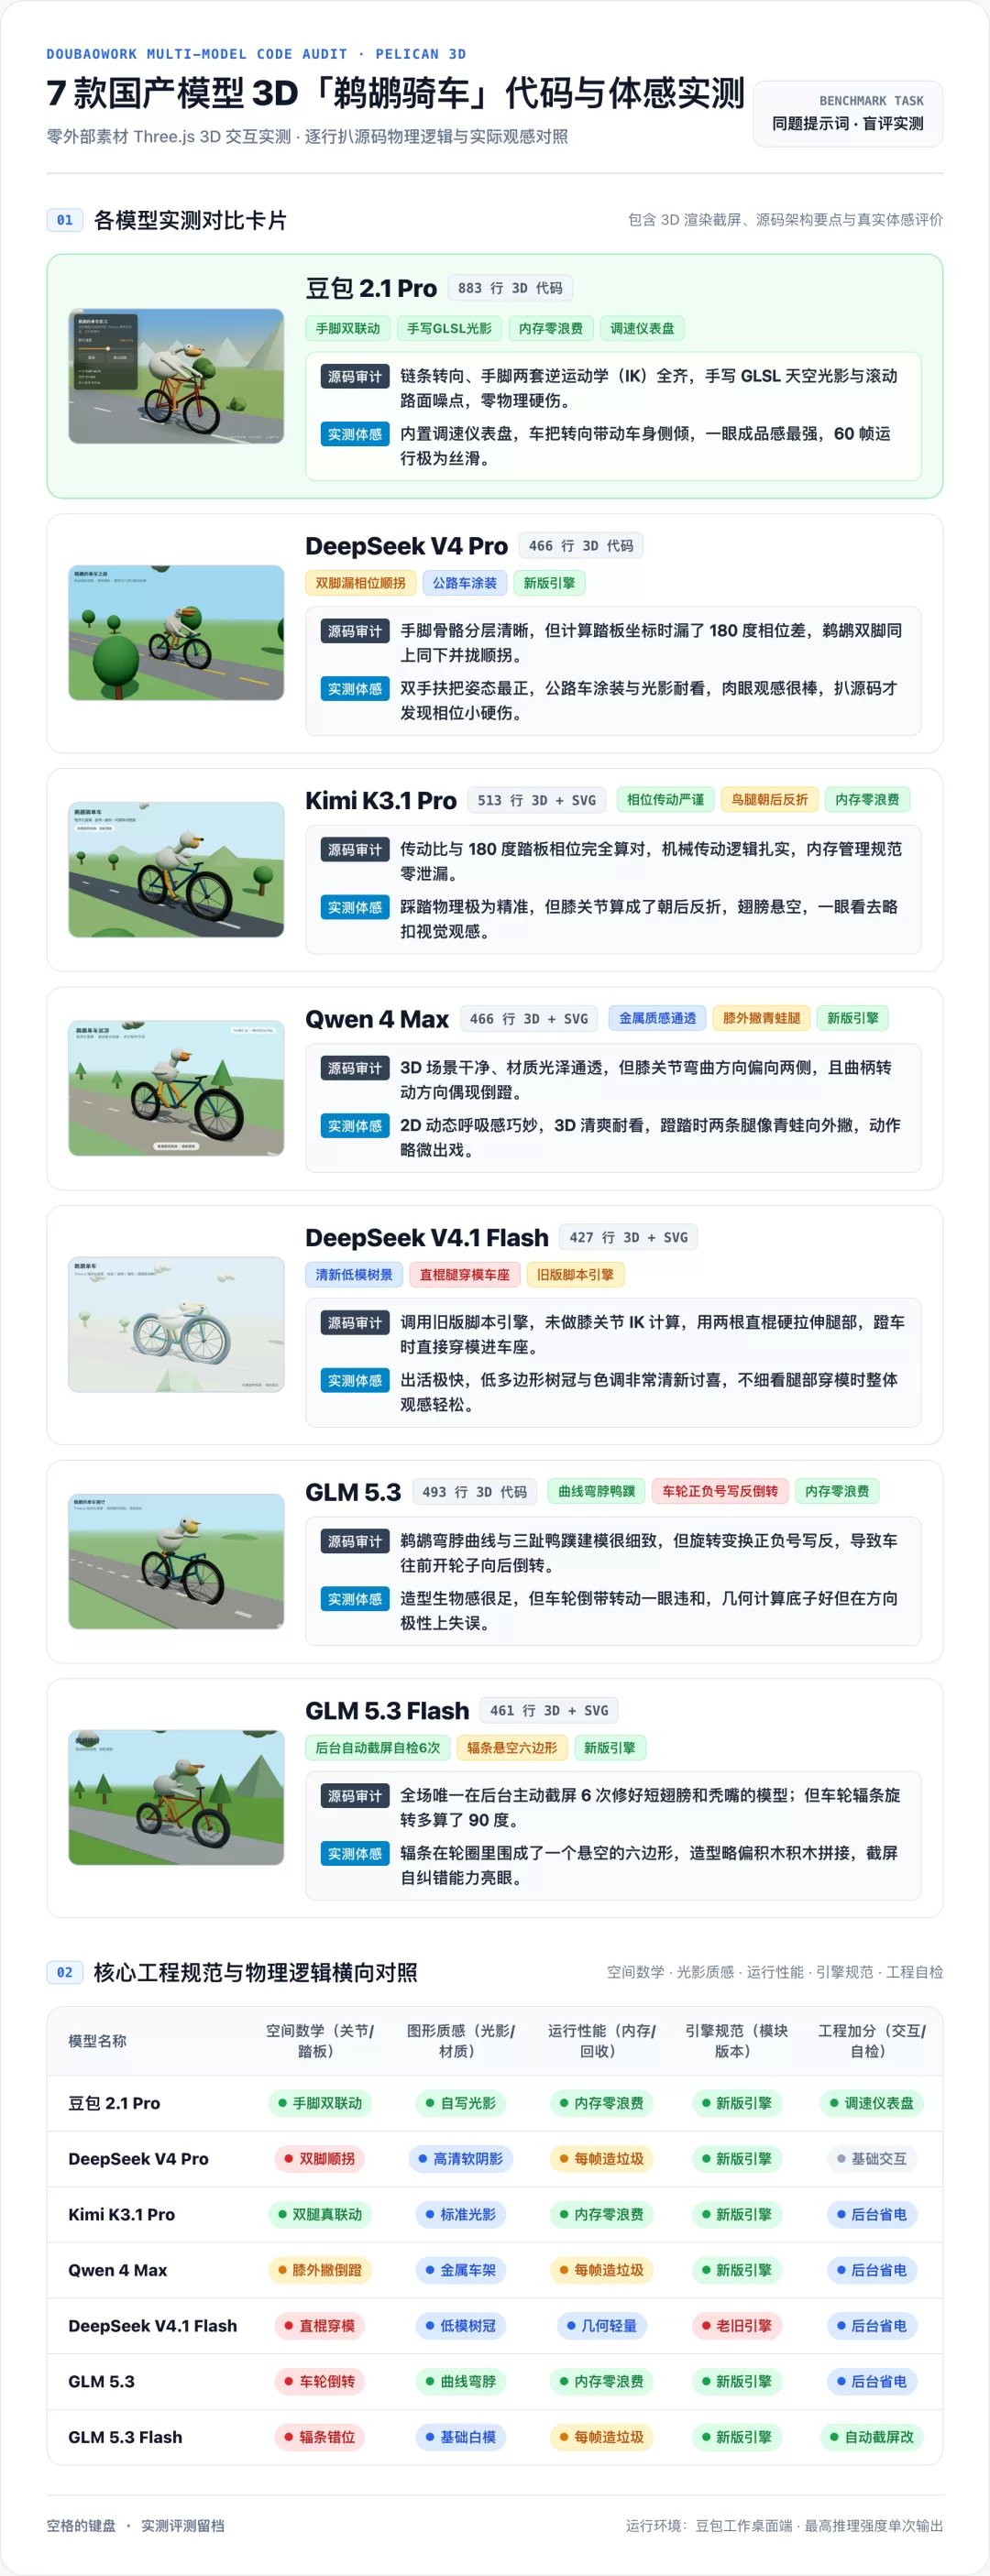
代码方面选了零外部素材手写「鹈鹕骑自行车」Three.js 3D 交互网页。结果可以明显看出模型差距,鸟的弯脖子和喉囊效果、两条腿能不能跟着踏板、车轮转动方向对不对。
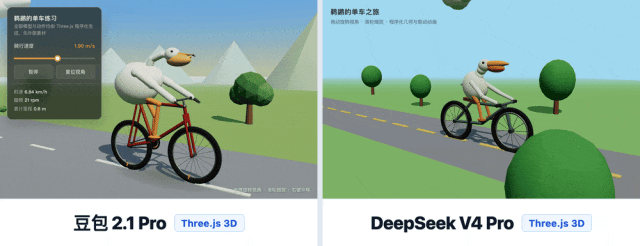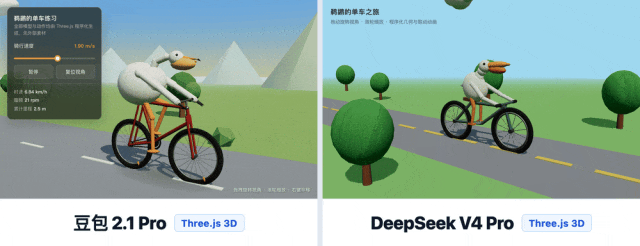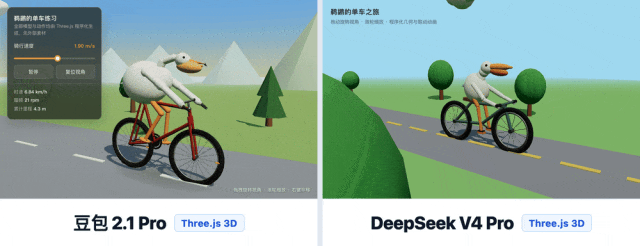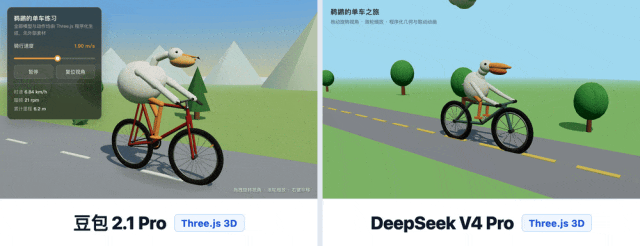
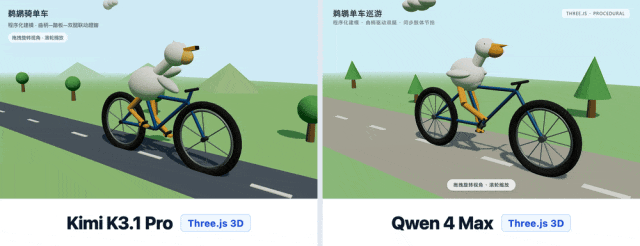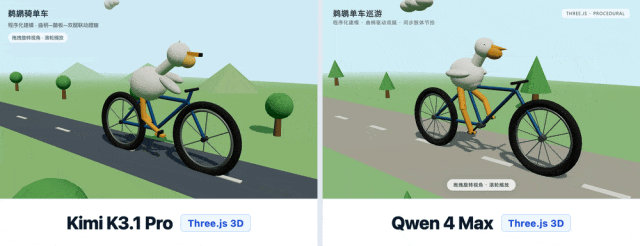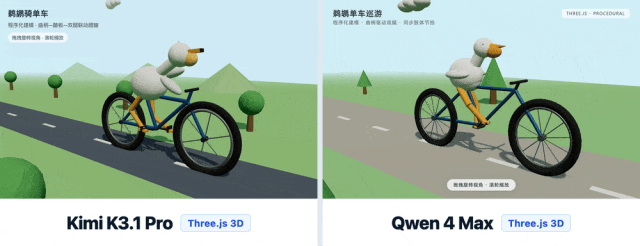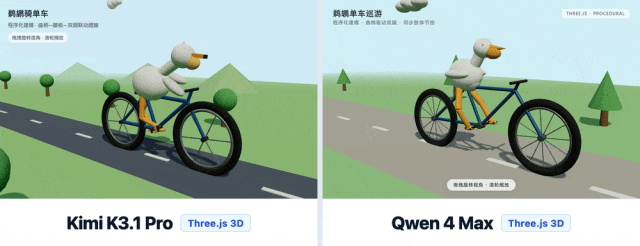
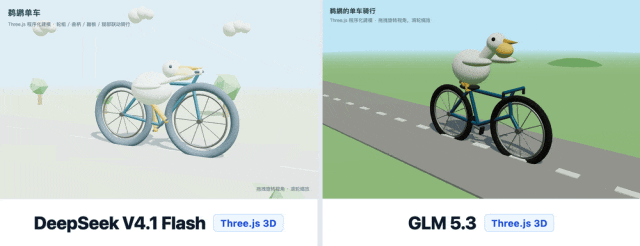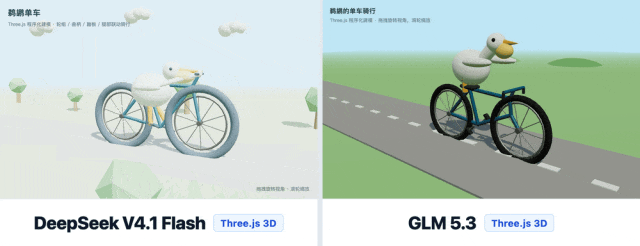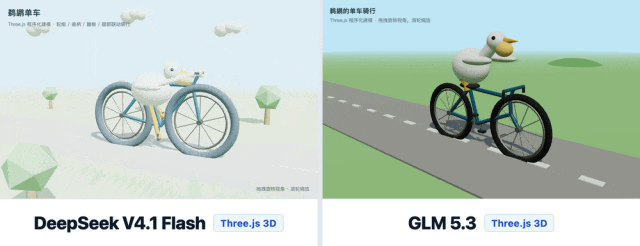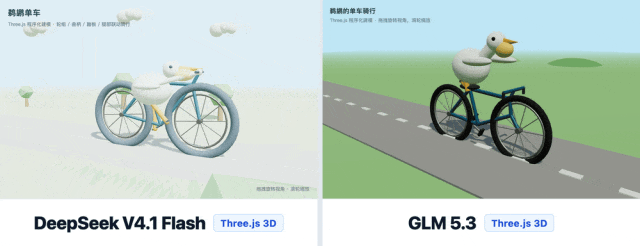
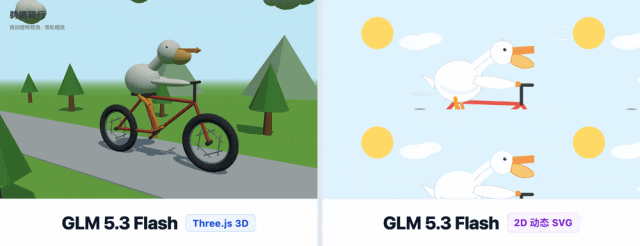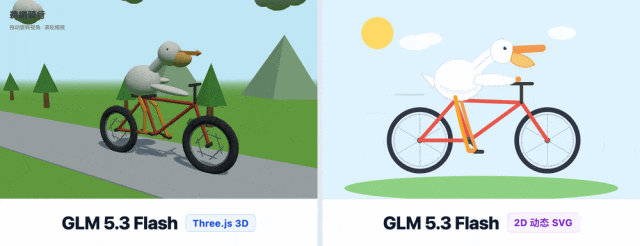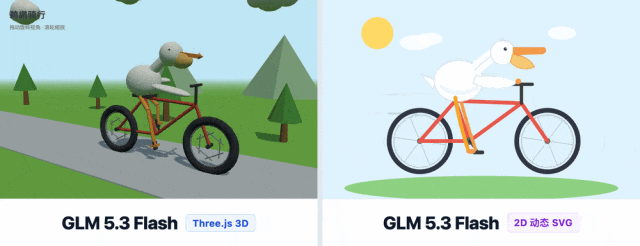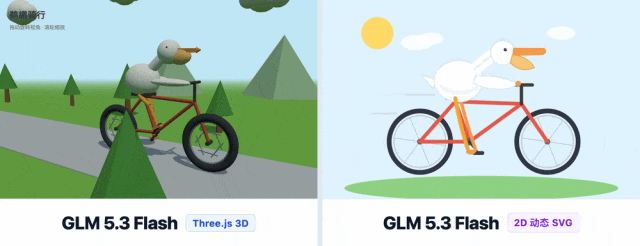
等第三方裁判模型逐行扒源码后就清晰了不少。让它从五个方面评价:空间数学(关节联动和踏板相位)、图形质感(光影纹理精细度)、运行性能(每秒 60 帧表现)、引擎规范(用的是新版模块还是旧脚本)、工程加分(有没有交互控制台或主动截屏自检)。
同时按第一眼观感写了个人评价,把源码分和体感分放在一起看,出现了几个挺有意思的反差:豆包 2.1 Pro 在这里表现很突出,别家大多写四百多行,它一口气写了 883 行,手写 GLSL 天空光影、滚动路面噪点、18 根辐条加链条,连车把微转向带动车身侧倾、手脚两套关节联动都做齐了。
DeepSeek 两款属于肉眼观感高于底层源码分。V4 Pro 算脚踏坐标时漏了 180 度相位差,鹈鹕其实是双脚并拢同上同下顺拐蹬车;V4.1 Flash 低多边形树景很清爽,但底层没写膝关节,拿两根直棍硬伸缩还穿模进了车座。
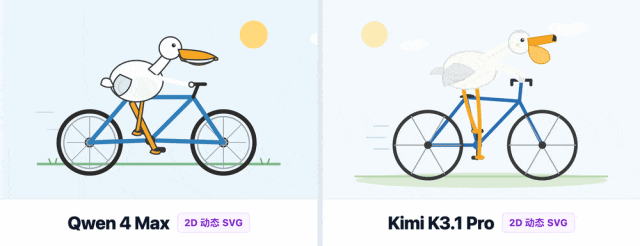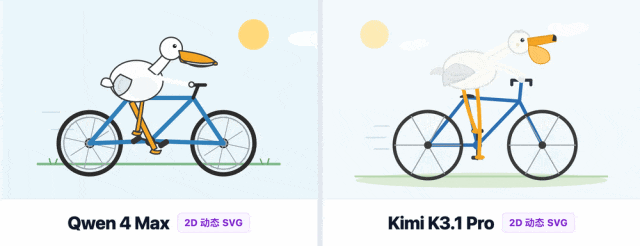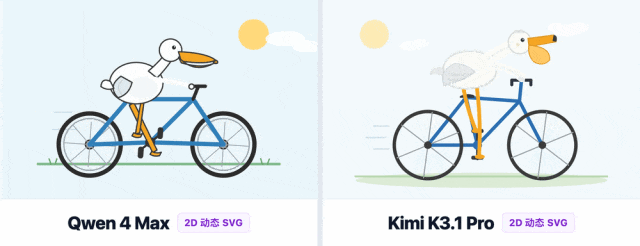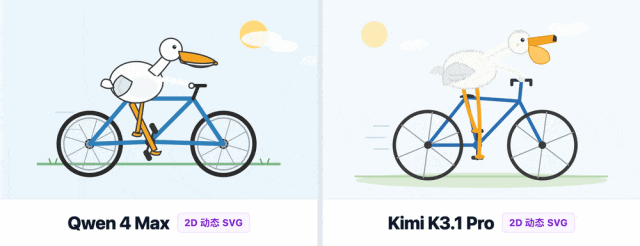
Kimi K3.1 Pro、Qwen 4 Max 和两款 GLM 看上去都差不多,审美相似,且出现的问题都挺像。Kimi 传动比与相位全对,但鸟腿朝后反折扣了观感;Qwen 4 Max 把膝盖弯曲方向算到了两侧,蹬起来像青蛙外撇;GLM 5.3 做了流畅弯脖子和三根脚趾,但正负号写反导致车往前走轮子倒转;GLM 5.3 Flash 是全场唯一主动在后台截屏 6 次看图修好短翅膀和秃嘴的模型。
写作实测
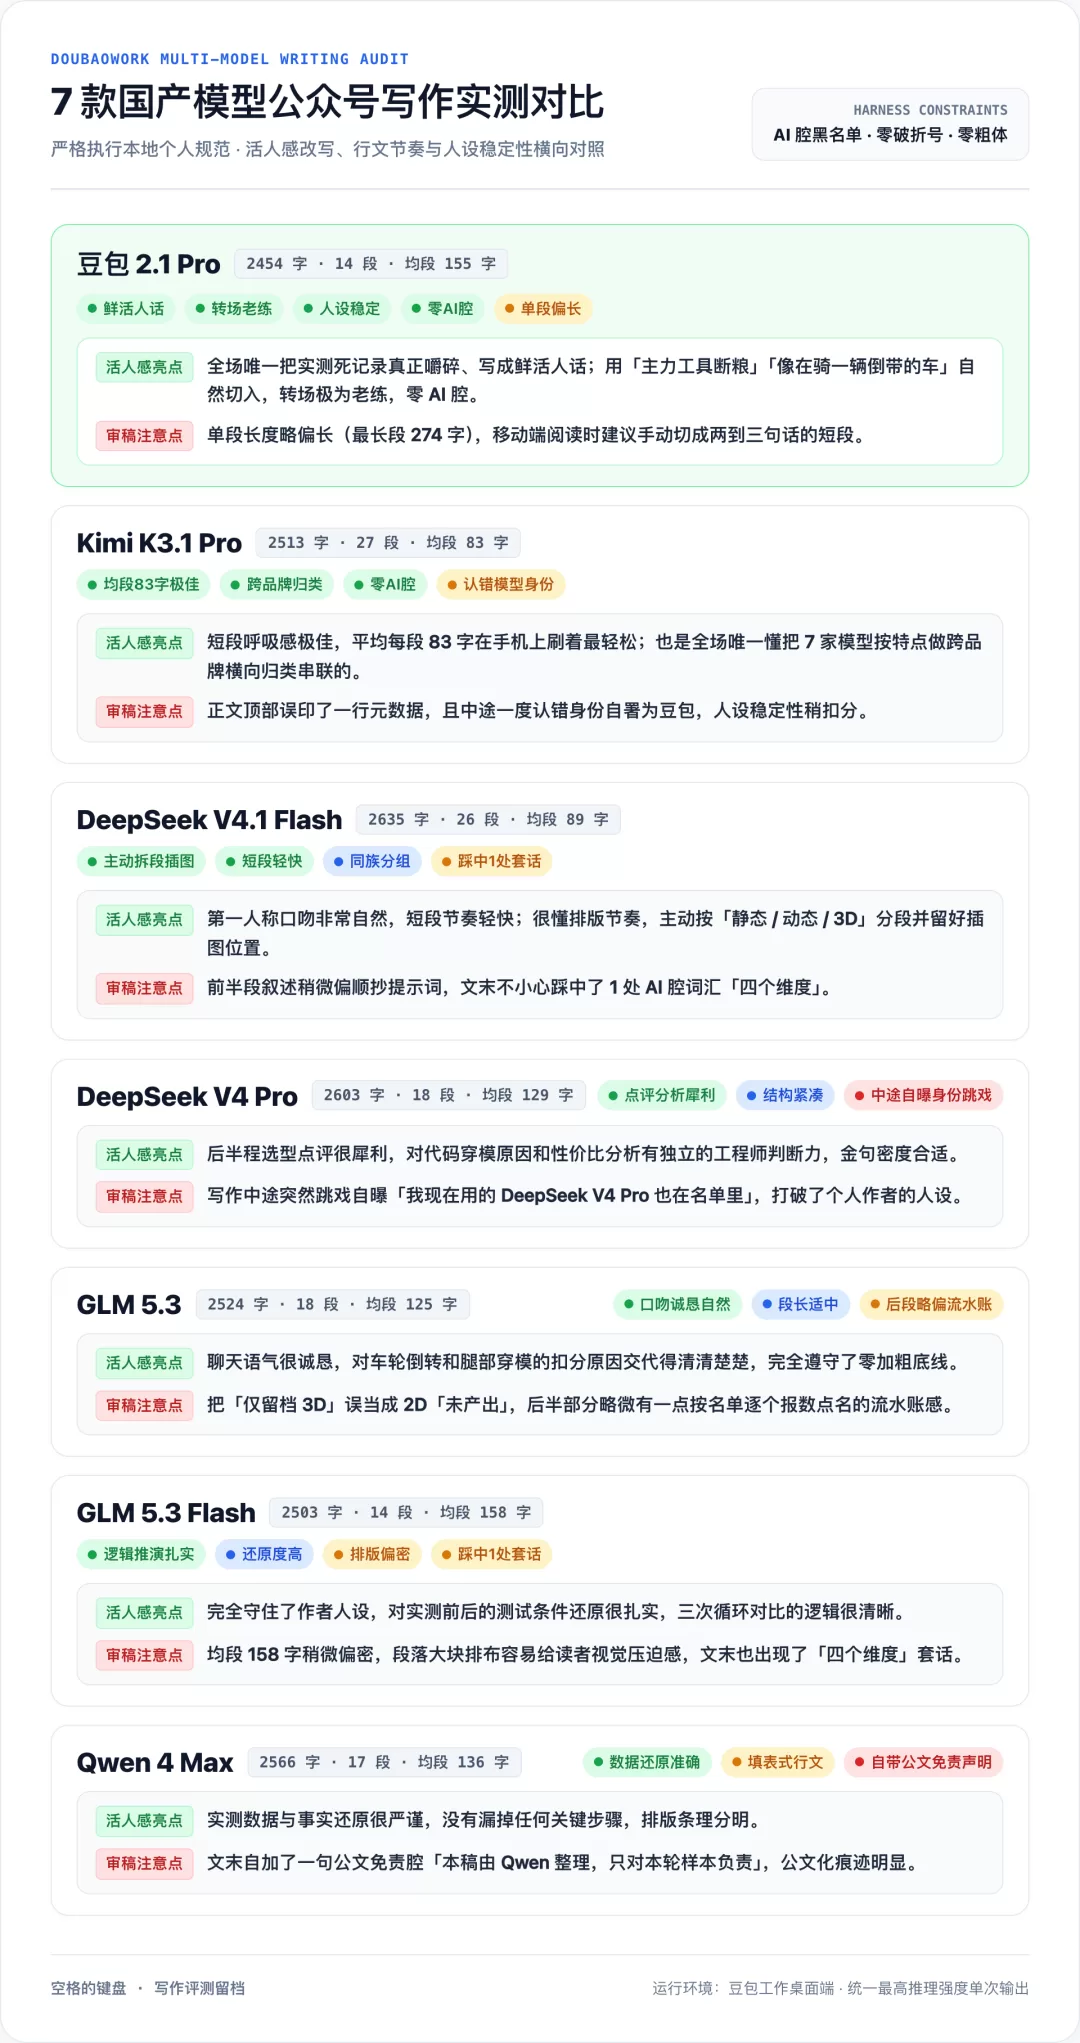
写作方面,我最看重模型写出的内容能不能符合本地个人规范。测试时 7 款模型先读取本地规则,统一以同一个题目输出 Markdown 文档。7 家模型输出了 7 篇 1600 字以上的文章,都采用第三方模型评价。
结果很清晰:给足规则后,7 家都能守住写作规则。真正拉开差距的是优化改写。五家基本只是把原始记录换个标点顺一遍,豆包 2.1 Pro 嚼碎之后写出的内容更具活人话,Kimi K3.1 Pro 的短段节奏读起来很舒服。
额度消耗与选型推荐
实际掉的额度和开头菜单里标的官方倍率基本一致。单轮消耗比较高的是 Kimi 系列(0.95x 到 1.48x)和 DeepSeek V4 Pro,其次是 GLM 5.3(0.80x)。
对照前面的实测体感,推荐选型如下:
- 复杂前端、3D 交互与主力写作:选豆包 2.1 Pro(倍率 0.65x,代码和写作都省心)
- 日常高频编码与轻任务:用 DeepSeek V4.1 Flash(限时 0.01x)
- 长文短段编排与逻辑复核:找 Kimi K3.1 Pro 交叉验证
现在在豆包工作里就能随手切换这几家国产主力模型,再配上顺手的桌面 Harness,除了直接读写本地文件跑代码和写文章,图片生成、视频生成、画布编辑、插件和定时任务也都齐了。