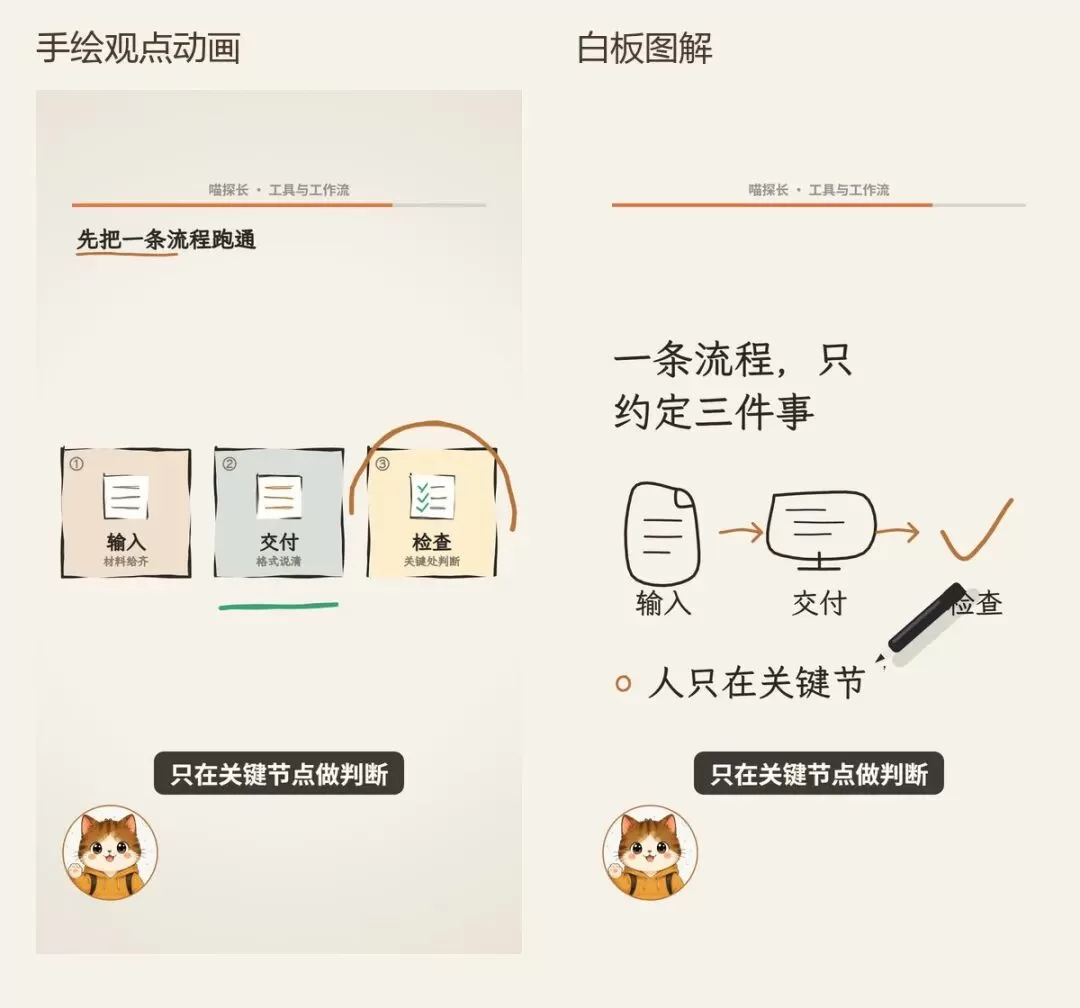
同一段观点,做出了两条约 32 秒的竖屏解说视频:一条是手绘卡片,一条是白板图解。配音和文案相同,画面却有两种讲法。
这次用的是 rayskills 仓库里的 ray-explainer。它把文章或观点拆成解说稿,再让画面跟着讲述展开,最后合成视频。更关心的是,这套流程能不能装进自己的表达方式:固定一个人物,保留自己的观点,持续做成能看懂的视频。
01|先把一段观点,做成看得见的结果
这次的主题是:"为什么 AI 工具越多,反而越忙?"制作要求很具体:同一份文案、同一份配音,分别用手绘和白板画法,做两段竖屏预览。底部沿用固定头像。
把内容拆成四幕:工具之间反复切换;发现缺的是流程;约定输入、交付和检查;最后落到一个行动建议。实际得到的是两份 1080×1920、24 帧的视频文件,每条约 32 秒,包含旁白和字幕。
手绘版会依次展开路径、交换卡片位置,再对正在讲的内容圈注和推近;白板版则用一支笔,把图标、箭头和要点逐步画出来。这里值得看的,是一句观点怎样变成几个有先后关系的画面。
02|它为什么能让画面跟着话走
普通的配视频方式,经常是先写稿,再找几张图,最后把图片放到时间轴上。ray-explainer 多做了一层:每幕要说明"讲什么""依次出现什么",以及"哪句话触发哪个动作"。
例如,说到"写稿、生图、剪辑",对应的几个节点依次出现;讲到"其实缺的是流程",画面里的重点也随之变化。按照项目文档,配音经过校对后会生成文字时间信息,字幕和画面事件据此对齐。
画面主要由代码绘制,浏览器逐帧渲染,再用视频工具合成。内容可以是手绘图形、关系箭头和图表,也可以走 HyperFrames 模式,加入真实截图、录屏和照片。这也说明了它的边界:它擅长把一件事讲清楚,并不是让代码替代所有实拍或角色表演。
03|固定个人 IP,不必每次重新生成整个人
它对自媒体比较有用的一点,是把固定部分与每期内容分开了。固定部分可以是人物形象、声音、主色和字幕习惯;每期变化的,则是观点、素材与画面关系。
项目提供的小主持人方案,会使用同一套人物图层,按文字时间切换嘴型,并加入眨眼和轻微摆动。需要更明显的手势和表情时,还有另外调用视频模型的大机位方案。
如果你准备做观点号,可以先想清三个问题:
- 观众每次靠什么认出你:人物、声音,还是稳定的视觉习惯?
- 这段话最需要表现什么:因果、对比、步骤,还是一次认知反转?
- 哪些内容必须用真实材料证明,哪些适合画成图解?
把这些定下来,再选画法,比每次重新挑一套漂亮模板更容易形成自己的系列。
04|值得试,但先跑一小段
这次两段样片已经能看画法和节奏,但还不是最终发布片。系统配音、动作幅度和画面密度,都有继续打磨的空间。
环境也有门槛。原版的一些路径、语音校对和本地声音方案偏向 macOS;在 Windows 上跑通了画面渲染,不能因此说原版所有功能都已验证。如果想尝试,建议先拿一段已有观点,控制在半分钟左右。先检查画面能否解释内容,再考虑复刻音色、人物嘴型和更复杂的镜头。
先把一段话讲顺,再把这套做法变成自己的内容流程。