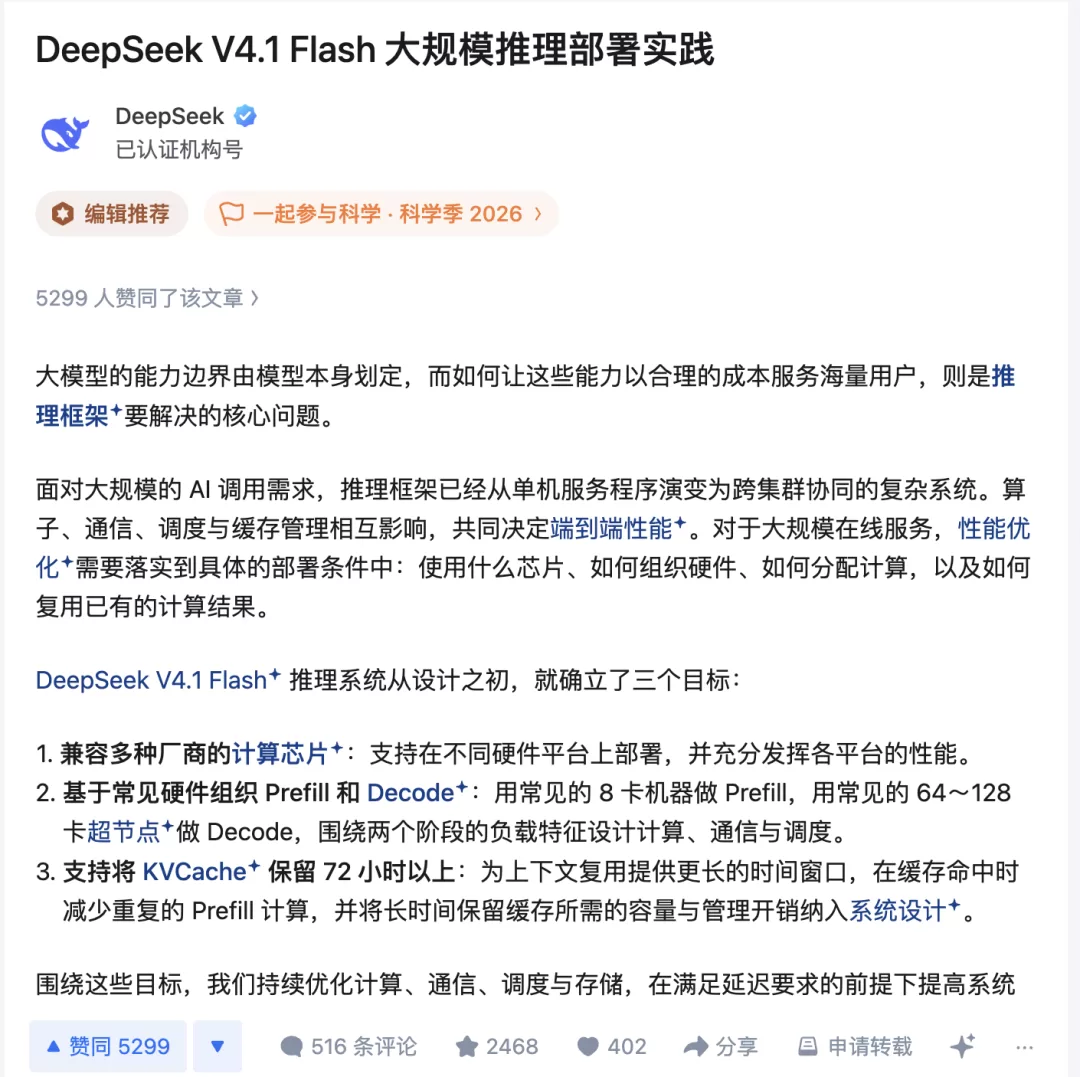
继 DeepSeek 开源内部大规模生产级推理框架后,官方又在知乎发布了技术报告,将超大规模集群调度的底层设计完整公开。最引人注目的是:单一集群服务吞吐达 155 万亿 Tokens/天,单卡每小时收入 38 美元(按谷价),在极低 API 售价下仍保持高达 80% 的服务毛利率。
为什么别人烧钱,他们赚钱?
大模型推理的最大痛点在于用户增多后集群吞吐上不去,算力闲置和通信排队严重。DeepSeek 给这套系统定了三个目标:
- 同时兼容英伟达和华为昇腾硬件
- 将 Prefill 和 Decode 任务完全分离:用普通 8 卡机器跑 Prefill,用 64 到 128 卡的超节点处理 Decode
- 将用户历史会话的 KVCache 延长保留到 72 小时以上,消除重复计算
Prefill 阶段采用较小的专家并行(EP2 到 EP8),Decode 阶段拉满到 EP64 甚至 EP128。多模态图片编码独立部署,单卡即可处理。
用 Rust 重写分词器
DeepSeek 将 API 协议适配、输入编码和输出解析全部用 Rust 重构。对于特殊标记,记录绝对位置,只对普通文本做并行切分编码,杜绝注入攻击。模型流式输出时编写跨切片解析的状态机,即使 UTF-8 字符被切断也能在内存中暂存拼合,首字返回速度推到极致。
四层负载均衡
- Prefill 负载均衡:将输入长度切为四档,按二次方模型预测耗时,纳秒级倒推最佳 Token 数
- Decode 负载均衡:同时监控每张卡的请求数和缓存总长,长短请求交替搭配
- MoE 专家并行负载均衡:每卡预留备用位,自动迁移热点专家权重,最慢卡和平均卡偏差压缩至 10% 以内
- 弹性伸缩:按实际算力需求缩容,遇节点故障就地重组通信域
100PB 分布式存储
DeepSeek 将缓存分为 Block KVCache 和 SWA KVCache 两部分。核心的 Block KVCache 以 128 Token 为一页,全部存入 3FS 独立分布式文件系统。该文件系统配备 100PB 固态存储,峰值聚合读取带宽达每秒 10TB。智能体场景缓存保存 3 天,普通对话保存 7 天。
SWA Bounded Replay
SWA KVCache 不写硬盘,只在内存中保留约 180 秒,命中率维持在 98% 以上。超时后系统直接触发截断重算:只重算最近 128 个 Token,产出算完即弃,Prefill 计算量近乎缩减一半。
投机解码变长验证
DeepSeek 采用 DSpark 投机解码,加了一个置信度预测头,模型边猜边算概率,每次生成 5 个候选,按接受率动态排序,只挑预期收益最高的前缀交给模型验证,线上实际吞吐净增 6%。同时消除 CPU 调度的等待时间,GPU 执行当前步骤时 CPU 已同步跑完下一步调度,全程无缝流水线运转。
通过整套软硬件架构重构,DeepSeek 把大模型服务变成了极高吞吐的工业流水线,证明低价 API 不仅不会亏本,反而拥有惊人的利润空间。