很多人觉得本地部署模型容易,但参数小的模型干不了活,上千亿参数的大模型又跑不起来。
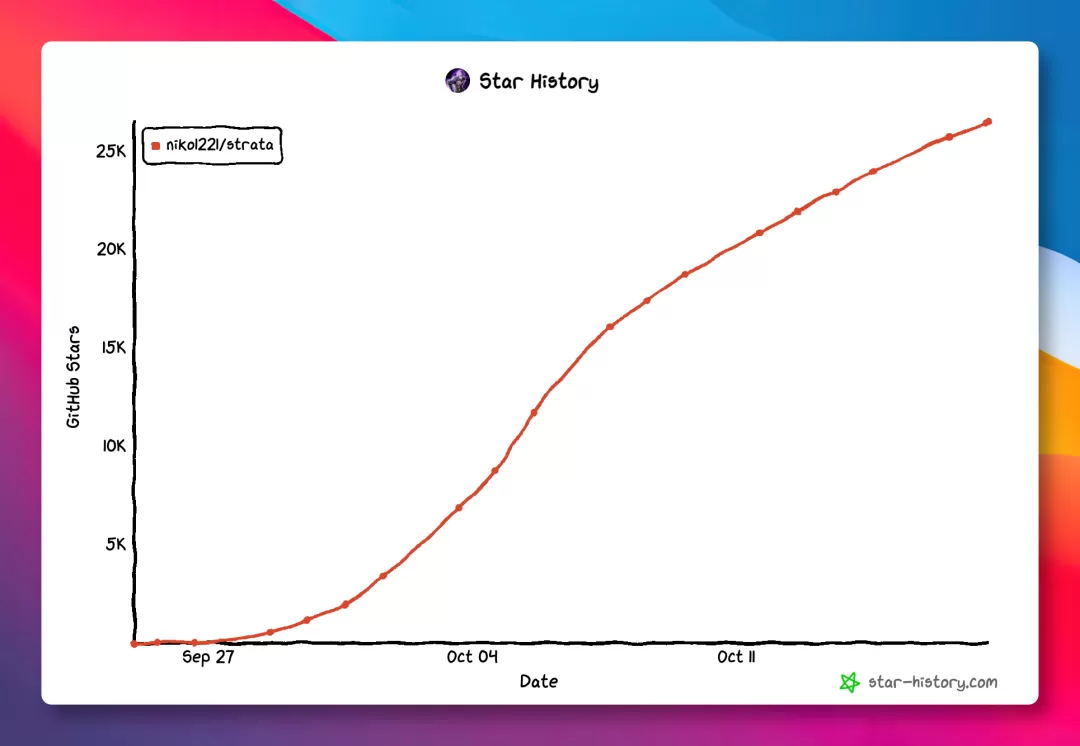
正巧这两天,GitHub 上有一个很火的开源项目Strata,已狂揽了 26000+ Star。使用它,能让我们在一台普通配置的游戏电脑上,也能跑起 1250 亿参数的大模型——比如 Qwen3.8-Flash-Next 这种平时需要几百 GB 显存服务器才能运行的模型。
Strata 只要一张 12GB 显存的 N 卡或 A 卡,Windows 和 Linux 都能装,数据全程留在自己电脑上。
速度方面,作者拿两台普通的游戏电脑测过:RTX 5070 显卡配 64GB 内存的版本,每秒能写出 53 到 94 个 token。
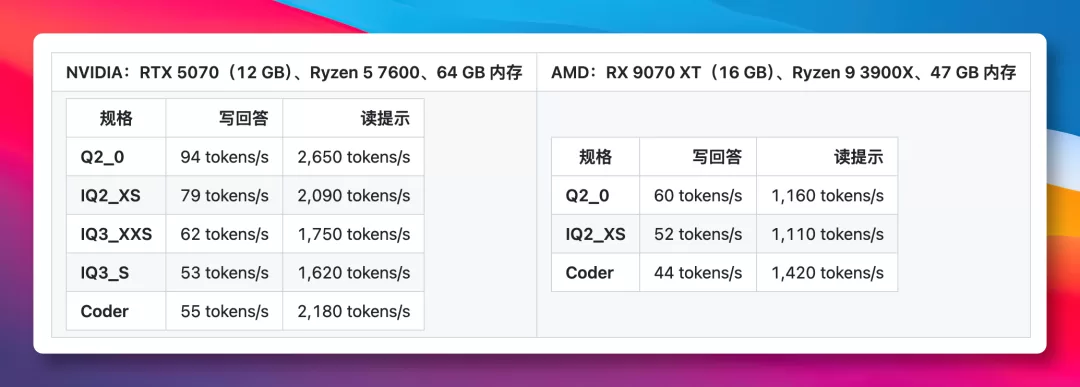
按 README 里的说法,每秒 60 个 token,就已经比我们看字的速度还快了。若是换成 AMD 的 RX 9070 XT 更低性能配置的显卡,也能跑到每秒 44 到 60 个。
在 RTX 5070 上跑的模型,只用一句提示词,就写出了一个用小方块搭起来的宝塔花园,直接在浏览器里就能跑。
一张 12GB 显卡怎么装下千亿模型?
用通俗易懂的例子,就像在厨房做菜:常用的东西摆在台面上,其余的先收进储藏室。
这个模型其实是由 24576 个"小专家"组成的(MoE 架构),每写一个字,只需要叫上其中 10 个。
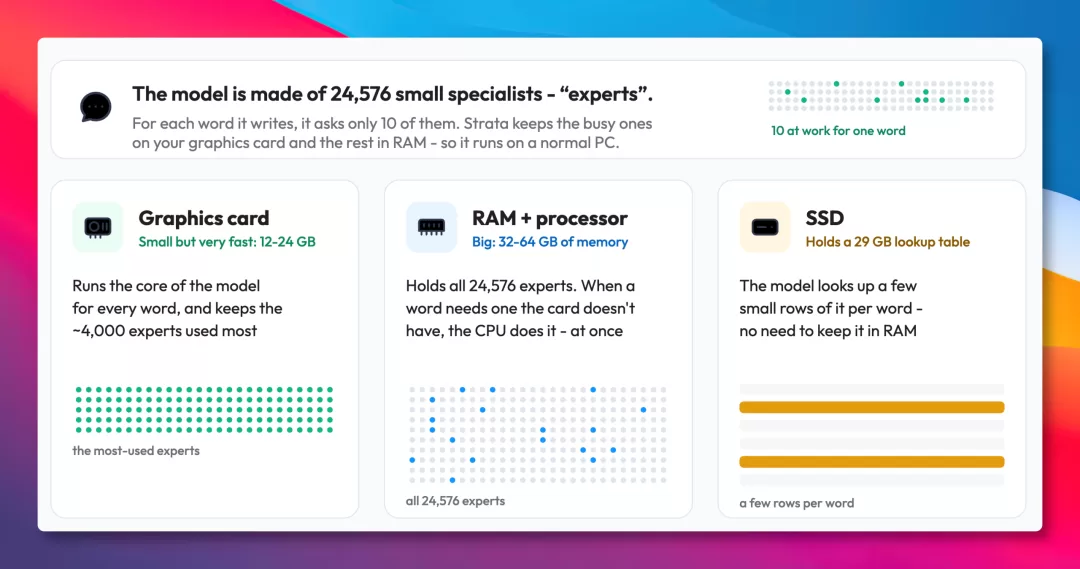
所以 Strata 把最常被叫到的几千个专家放在显卡上,全部专家都放进内存,显卡上没有的那部分就交给 CPU 同时来算。而且聊得越久,它越清楚哪些专家用得多,显卡上放哪些专家也会跟着对话来调整。
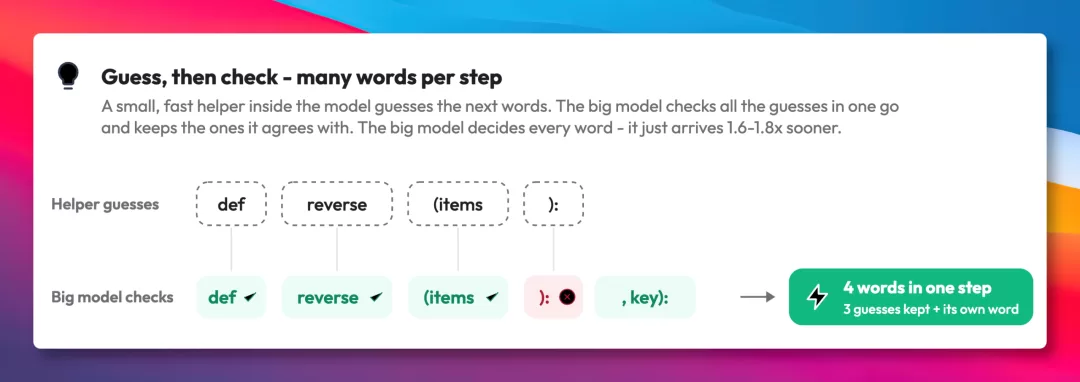
另外还有个"先猜后验"的办法(Speculative Decoding):让一个小帮手先猜后面几个字,大模型再一次性检查,猜对的直接留下。这样做,能够让回答的速度快 1.6 到 1.8 倍,最后给出的答案还是一样的。
使用方式
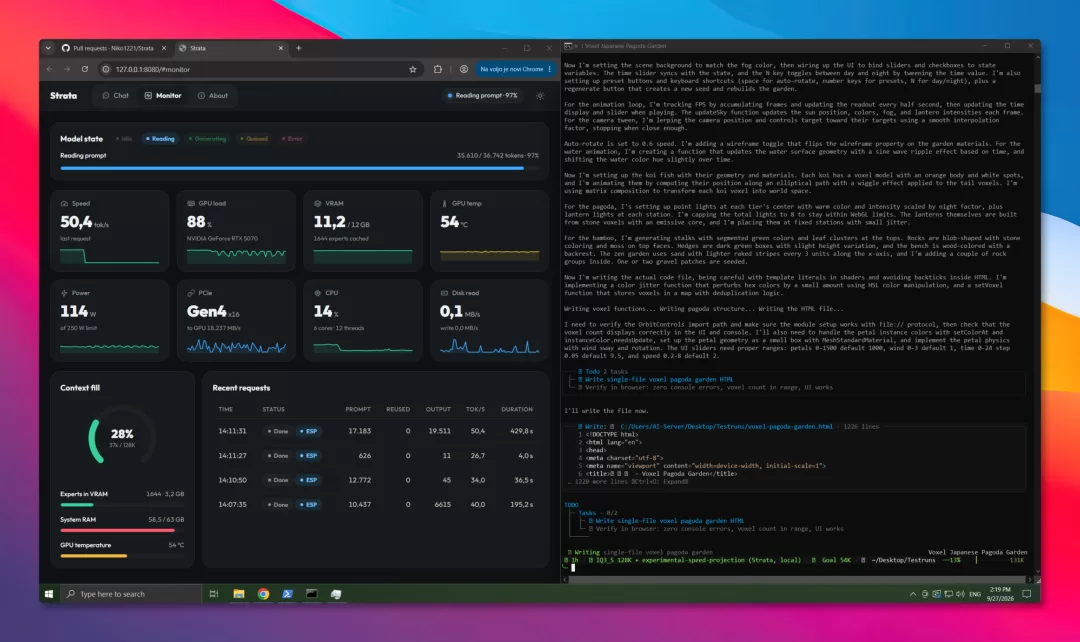
装好之后,浏览器打开本地页面就能直接聊天,旁边还有个监控面板,能实时看到模型的运行情况,以及显卡、内存的占用。
更实用的是,它提供了跟 OpenAI、Anthropic 一样的接口,Claude Code、Codex 这些工具把地址改成本地的就能接上。
比如 Claude Code,只需要设置环境变量:
ANTHROPIC_BASE_URL=http://127.0.0.1:8080其他支持 OpenAI 兼容接口的应用,地址填 http://127.0.0.1:8080/v1,API Key 和模型名随便填都行。
安装时选上识别图片的话,还能把图片丢给它看,思考强度也能调,分关闭、低、中、高四档。
同一个模型,Strata 还准备了好几种压缩程度不同的版本,安装时会根据电脑内存推荐一个。
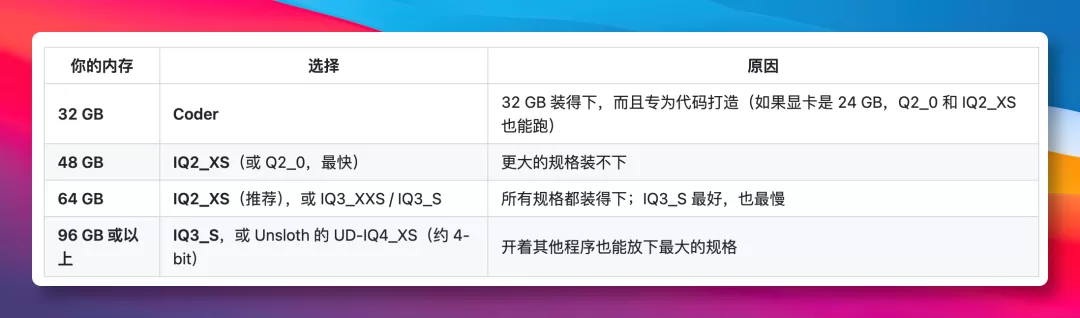
平时主要拿来写代码的,可以选专门的 Coder 版,按作者测的,能拿到完整版 91% 的 SWE-bench 编程得分。不过 Coder 版砍掉了一半的专家,写代码以外的事会弱一些,中文也是,日常聊天写东西还是选完整版更合适。
安装方式
在自己平时用的 Agent 工具上,把下面这句话丢给它就行:
帮我在这台电脑上装好 Strata,项目地址是 https://github.com/Niko1221/Strata ,按仓库里 docs/AI_SETUP.md 的步骤来。它会先检查显卡、内存和硬盘,挑好合适的模型,装好再启动,最后告诉我们怎么接到自己的应用里。
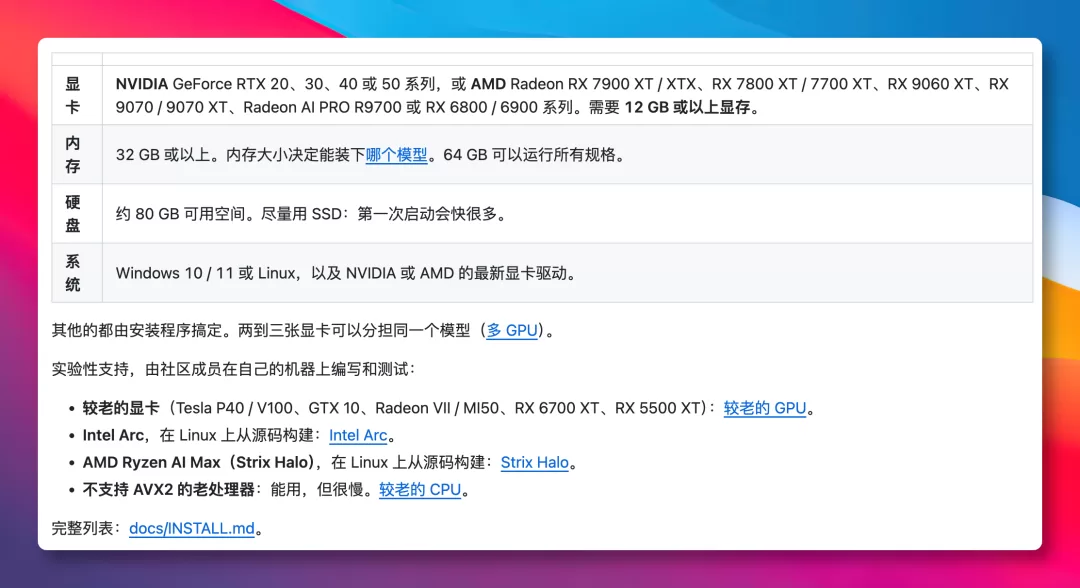
手动安装也很简单:Windows 双击 START-HERE.bat,Linux 运行 ./setup.sh 就行。在安装的过程中会问几个问题,比如用哪个版本、要不要识别图片,一路用推荐选项也可以。
接着会下载模型,大概有 70GB 大小,若中途断了也不要紧,重新运行一次还会接着下载。第一次启动时,电脑可能会花 1 到 3 分钟往内存里加载模型,等着就好,别急着把窗口关掉。
用 Mac 电脑的朋友需要注意,目前 Apple 芯片的适配还是实验阶段,问题估计不少。
写在最后
以前想在本地跑大模型,要么就是跑一个小模型凑合着用,要想跑上千亿参数的大模型,得购买服务器或十几万的设备。现在 Strata 把电脑的显卡、内存、CPU 和硬盘各个配置都调动起来,各干各的活,充分利用电脑的资源,让绝大部分人在游戏性能级别的电脑里,也能本地部署跑起千亿参数大模型。
项目刚开源不足一个月,便连续发了 52 个版本,目前正在快速迭代更新当中,值得持续关注一下。