想让楼道里的摄像头自动发现垃圾,再把现场截图发给管理人员,第一反应是找一个能识别垃圾的模型。但模型找到后,视频怎么接入?哪些区域需要检测?发现一次就提醒还是持续一段时间再报警?几路摄像头一起跑设备能不能撑住?真要做成一套能用的系统,模型之外还需要一串配套工作。
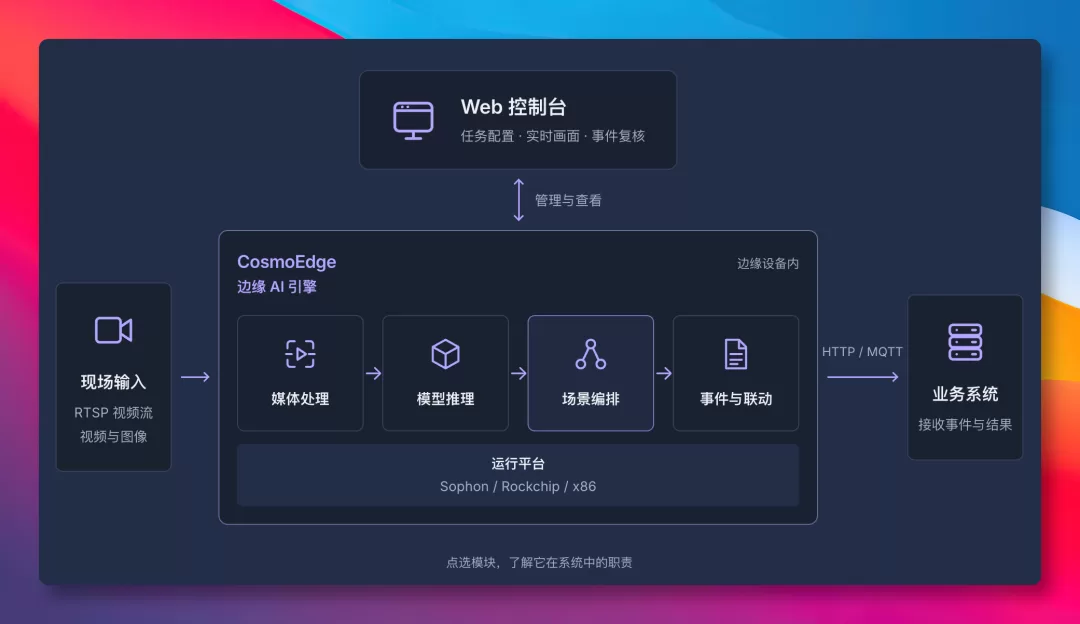
开源项目 CosmoEdge(御宇智能团队开发)专门解决这些问题。首个正式版本开源仅三个多月,已在 GitHub 斩获 1300+ Star。它把视频接入、模型推理、规则配置、实时画面和告警推送整合到了一套边缘 AI 引擎里,核心引擎和网页控制台均已开源。
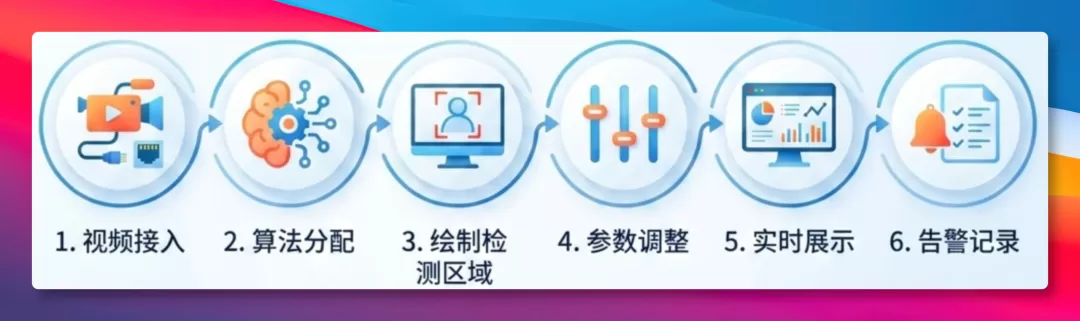
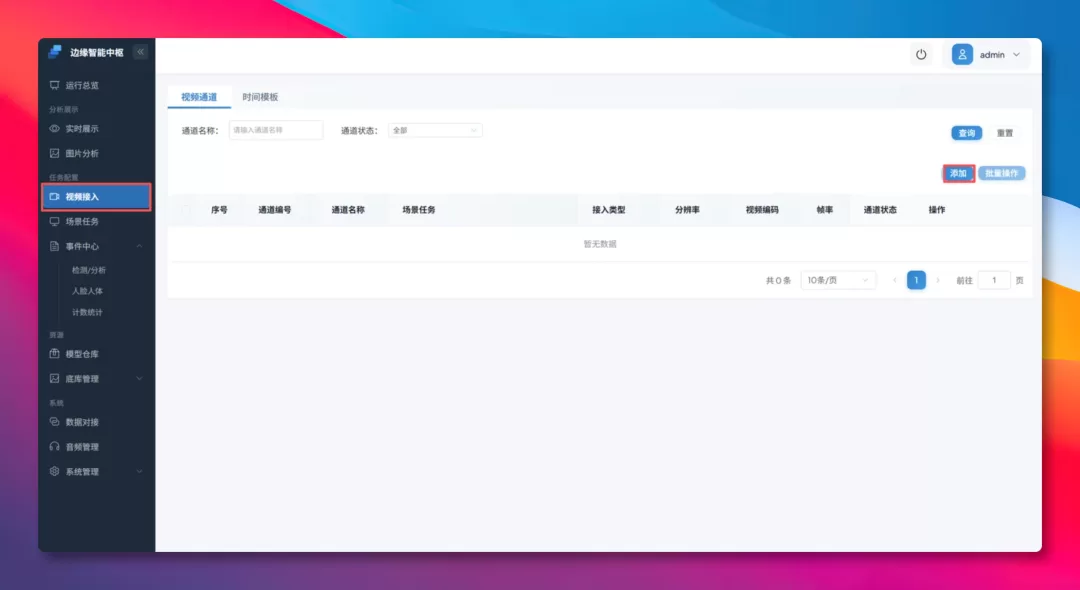
接上摄像头,在网页里搭好分析流程
使用 CosmoEdge,可以先接入一段视频或一路摄像头,再到网页控制台里选择模型、添加处理组件,配置分析流程。以未戴安全帽检测为例,先检测人员,再判断是否佩戴安全帽,最后根据区域和告警条件生成事件。模型、规则和上报组件都能在可视化界面中配置。
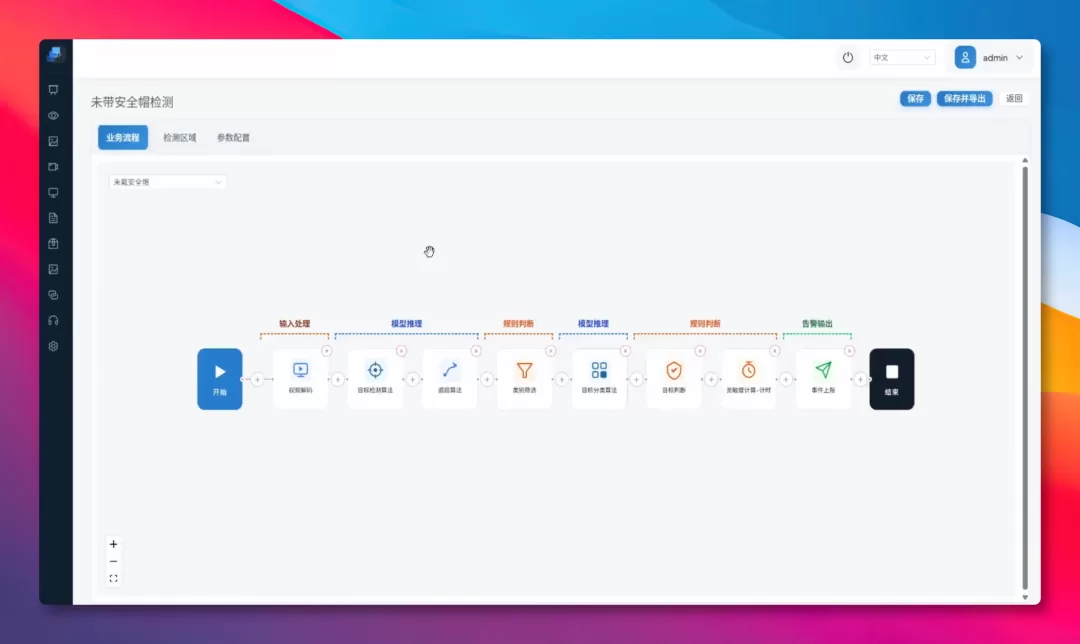
配置完成后,识别框会叠加到实时画面上,满足规则的结果会留下截图和告警记录。后续要调整检测区域、过滤条件或提醒频率,也可以继续在界面里修改。
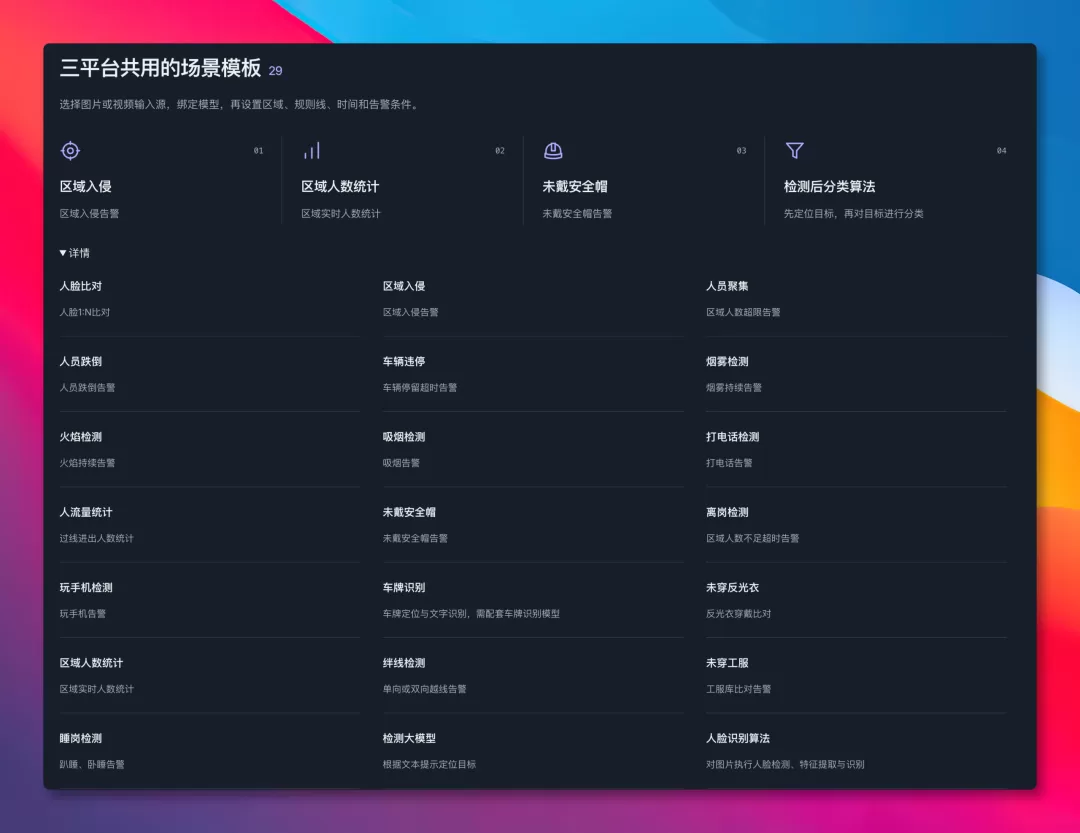
项目还提供了 29 类场景模板,覆盖区域入侵、人员跌倒、车辆违停等常见需求。选好模板、配上对应模型,再按现场调整区域和参数,就能开始测试。
已有自己训练的模型,也可以按平台接入,复用这些视频处理和应用功能。需要定制模型时,配套的 Training Skill 还能让 AI 助手协助完成数据检查、训练和应用接入。
给画面一句提示词,试试新的识别任务
遇到现有类别之外的目标,可以先试试 CosmoEdge 接入的 GroundingDINO 开放词表检测。比如楼道垃圾,输入 "garbage",就可以尝试让模型在画面中找出对应目标,再结合区域规则触发提醒。
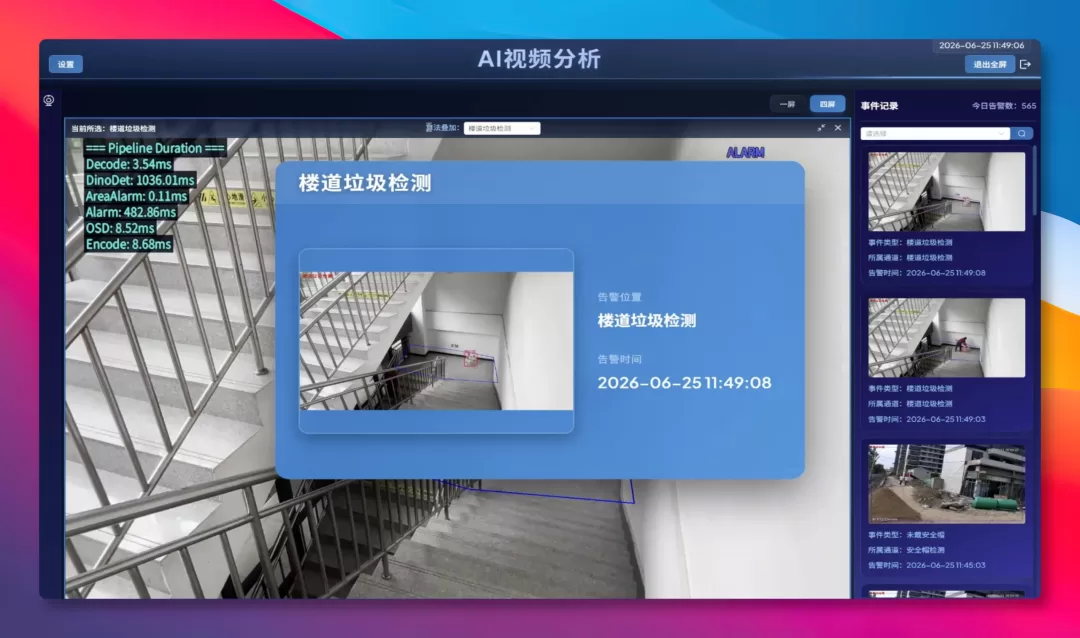
视觉大模型还能进一步判断画面中的状态:消防柜门有没有关好、垃圾桶是不是满了、河面上有没有漂浮物。这些问题可以先通过提示词验证,再按实际效果调整。最近,CosmoEdge 还接入了 Laya、MiniCPM-V 4.6 等视觉模型。
模型判断也能参与告警复核:常规检测触发疑似异常后,再让视觉大模型结合提示词看一眼画面,帮助过滤部分误报。
把识别结果送到真正需要的地方
CosmoEdge 可以通过 HTTP、MQTT 等接口,把告警和截图信息推送给已有的管理平台,接入通知、工单或业务流程。配套的 CosmoEdge Connect 还提供了 MCP 接口——可以让 AI 助手"查一下昨天的告警,再取一张现在的画面",由助手调用 CosmoEdge 查询、取图并整理材料。
公开测试:多路并发 + 72 小时长稳
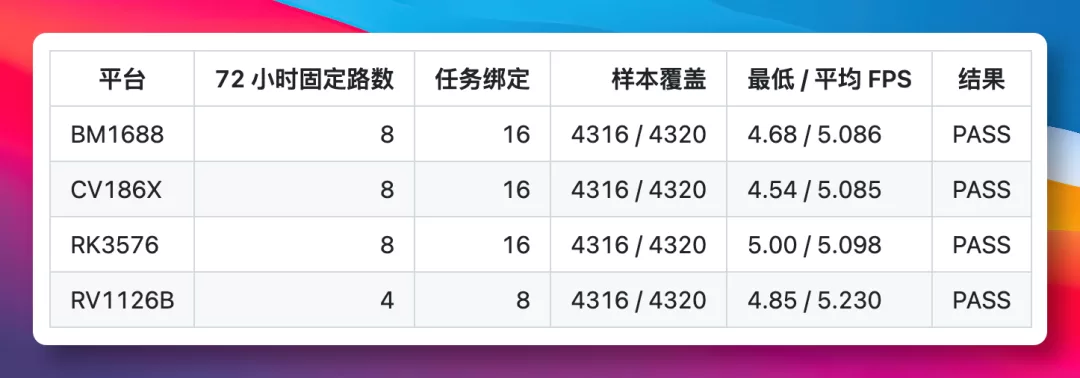
CosmoEdge 把性能问题做成了公开测试,让开发者在部署之前就有具体数据可以参考。测试内容覆盖 49 个小模型用例、三个平台的视觉大模型验证,以及四个芯片平台的 72 小时长稳测试。
在 72 小时连续测试中,每路同时运行人员检测和未戴安全帽分析两个任务,每个任务目标为 5 FPS。BM1688、CV16X、RK3576 三个平台使用 8 路、16 个任务,RV1126B 使用 4 路、8 个任务,均通过了测试。
项目支持 Sophon、Rockchip 和 x86 平台。换用其他受支持的芯片,匹配对应的安装包和模型后,仍然可以沿用同一套界面和任务配置方式。
快速上手
Linux x86_64 电脑装好 Git 和 Docker Compose 后,执行以下命令:
git clone https://github.com/cosmo-wander-ai/cosmo-edge.git
cd cosmo-edge
sudo docker compose -f docker-compose.x86.yml up -d --build
Windows 用户使用:
docker compose -f docker-compose.x86.windows.yml up -d --build启动后在浏览器打开 http://localhost:8080,跟着教程选模型、接视频、设规则即可体验。苹果芯片 Mac 也提供了 Docker Preview。
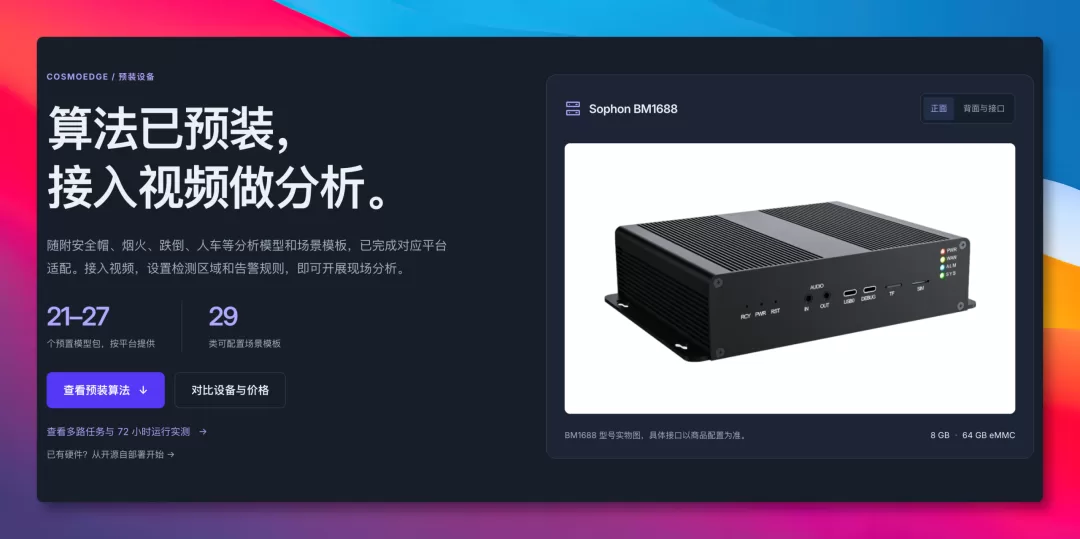
希望省去环境配置的,也可以选择官方预装设备。价格 1980 元起,随附 20 余种高质量算法模型和 29 种场景任务模板,接上视频就能从现成场景开始测试。
对想做视频 AI 应用的团队来说,CosmoEdge 提供了一套可以直接动手的基础:先用自己的画面跑通一个场景,再把时间花在模型效果和业务需求上。