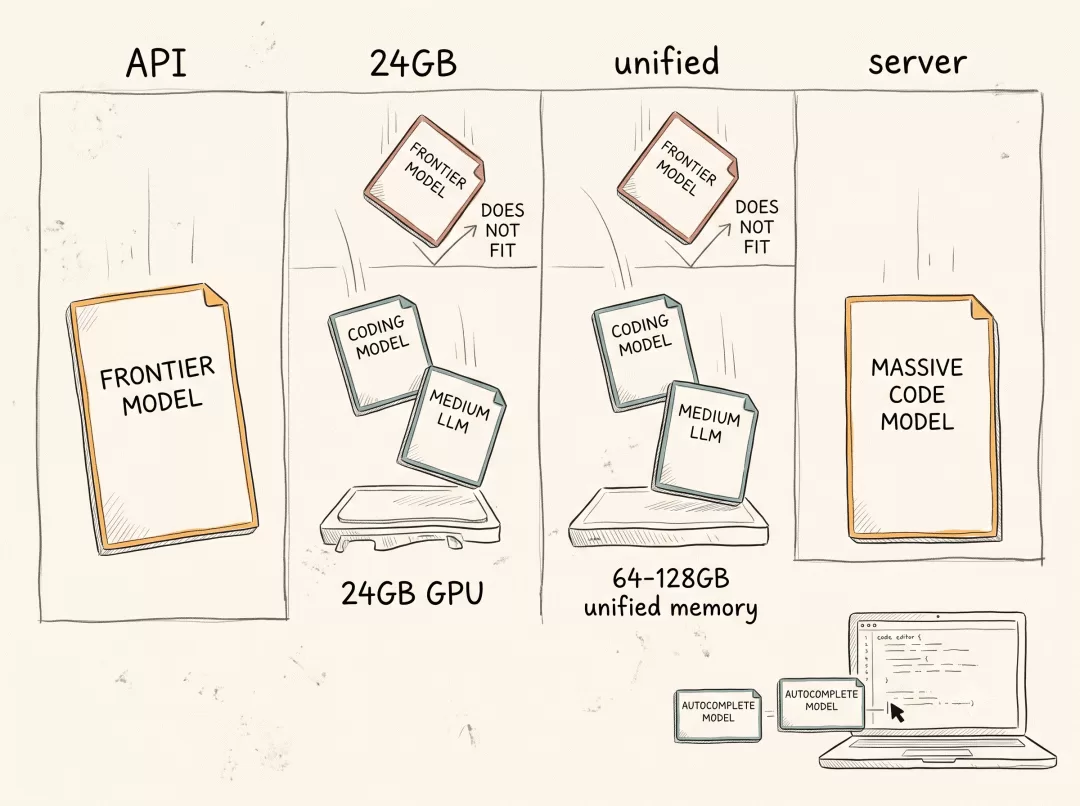
开源 coding model 在 2026 年追上了前沿水平。DeepSeek V4 Pro 最近据报道在 SWE-bench Verified 基准测试中达到了 80.6%,与全球最昂贵的闭源模型并驾齐驱。但问题在于:当前最优秀的开源 coding model 需要一整套服务器机架。能够在单张 24GB 显卡上运行的那个模型,水平却比应有的更接近顶尖。问题不是哪个模型总体上最好,而是对于你实际从事的 coding 工作,哪个模型最适合,并且能够在你的设备上运行。
第一档:开源前沿六强
这些模型能够与闭源前沿模型正面竞争。参数量从 4000 亿到接近 3 万亿。你很可能通过 API 调用它们。在这一档中,开源意味着你可以获得一个低价、可替换且不会被供应商锁定的 API endpoint。
GLM-5.2
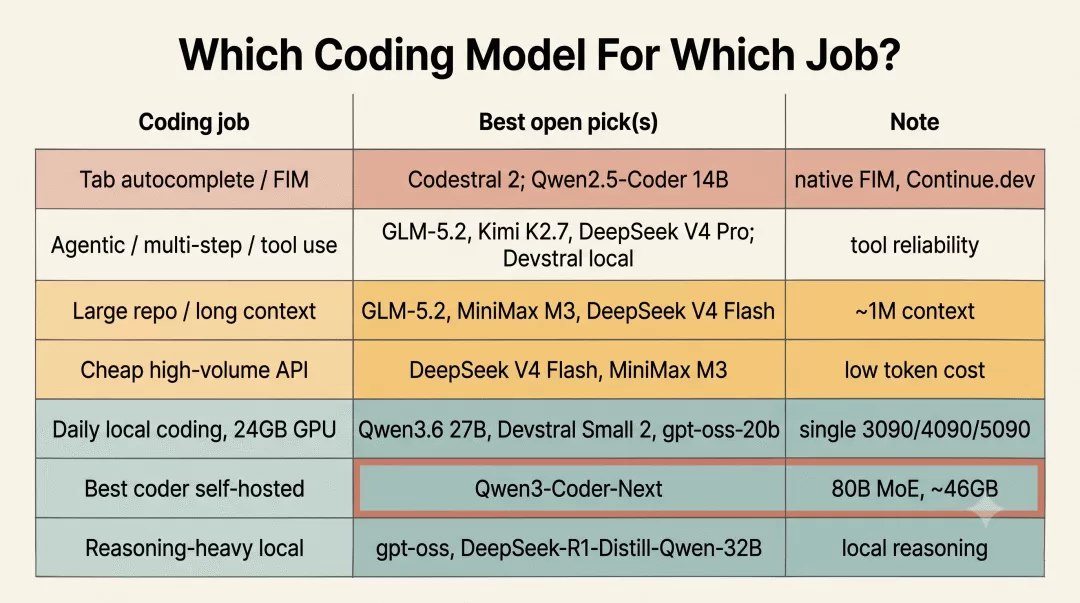
智谱构建 GLM-5.2 的目标,是处理大型代码仓库中的长流程、多步骤工程任务。它能够在 1M token context window 中保持专注,并跟踪变量之间的依赖关系。该模型采用 MIT license,总参数量约为 753B,使用 MoE 架构,每个 token 只运行约 40B 参数。它在 SWE-bench Pro 上领先开源模型,得分 62.1%。API 输入成本约每百万 token $1.40,输出约 $4.40。
GLM-5.2 使用改进的 rotary position embedding(RoPE)scaling 技术,相比前代能够更好地保留对中间上下文的召回能力。当你把整个代码仓库的 abstract syntax tree 粘贴到 prompt 中时,该模型确实能够使用这些内容。
Kimi K2.7 Code
Moonshot AI 设计 Kimi K2.7 Code 时,目标是让它能够自主工作。你可以将一个描述后台 worker 中 race condition 的 GitHub issue 交给它。它会编写修复代码、运行 test suite、读取 failure logs,然后不断重写函数直到测试通过。总参数量约 1 万亿,每个 token 激活 32B。采用修改版 MIT license。针对成功和失败的 compiler outputs 轨迹进行了大规模 reinforcement learning,它理解 syntax error 并不是失败状态,而是用于调整的信号。
DeepSeek V4 Pro 和 Flash
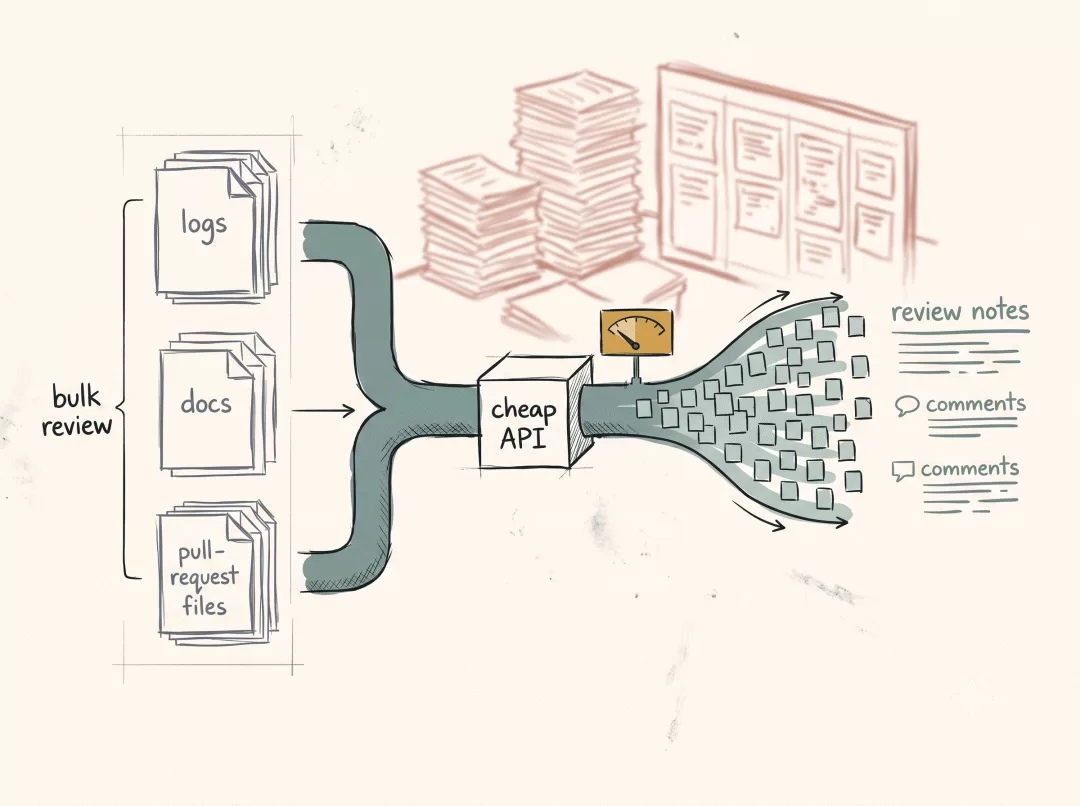
DeepSeek V4 让使用 API 的成本低于运行自有服务器所需的电费。Pro 版本输入约每百万 token $0.435,输出 $0.87。Flash 版本降至 $0.14 和 $0.28。两个版本都采用 MIT license,提供 1M token context window。集成到 automated workflow 只需要使用标准 OpenAI SDK boilerplate,替换 base URL 和 model ID 即可。
Qwen3-Coder-480B-A35B
阿里巴巴以 Apache 2.0 license 发布的 480B MoE 模型。能够处理 256,000 token,SWE-bench Verified 得分 69.6%。Apache 2.0 license 消除了商业使用的法律阻碍。公司可以在无需法律审查的情况下将其用于商业产品。不过部署 480B model 需要大量基础设施,即使 8-bit quantization 也需要接近半 TB VRAM,意味着需要 8x H100 或 8x MI300X node。
MiniMax M3
面向需要 visual context 的重型 front-end development workflow。可以将 Figma export、CSS module 和 UI bug 截图放入 prompt。原生 multimodal 功能可以将 visual layout 直接映射到需要修复的 React components。提供 1M token context window,SWE-bench Pro 得分 59%。输入约每百万 token $0.30,output 约 $0.96-$2.40。
Kimi K3
Moonshot 的 Kimi K3 于 2026 年 7 月公开 open weights,规模推高至 2.8 万亿参数。提供 1M token context window。能够处理复杂的 algorithmic reasoning task、systems programming 和 compiler optimization。对于大多数开发者而言只能通过 API 使用。
第二档:可以运行的四个模型
那 6 个模型需要租用。这 4 个模型属于你自己。这正是开源对个人开发者有价值的地方——不需要支付 API 账单,专有代码不会离开机器。可运行模型这一档距离前沿水平已经足够近,对于大多数日常 coding 工作,你不会明显感受到差距。
Qwen3-Coder-Next
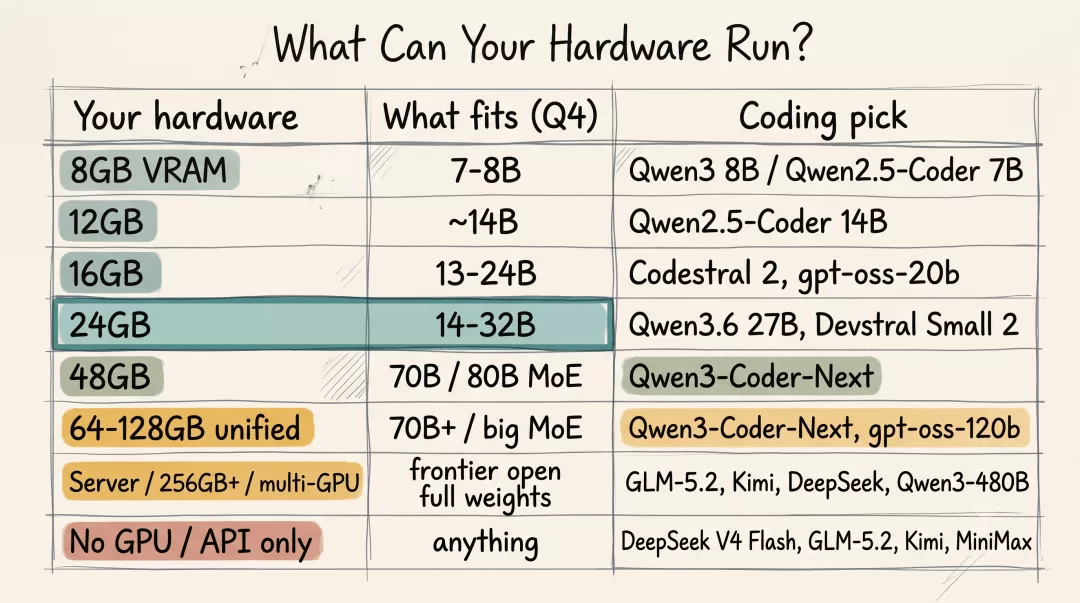
如果你拥有一台 64GB 或 96GB 的 Mac Studio,或者一台新的 128GB AMD Strix Halo,那么 Qwen3-Coder-Next 就是你的目标。总参数 80B,Apache 2.0 license,SWE-bench Verified 得分 70.6%。得益于 4-bit quantization,它大约需要 46GB unified memory。真正的 engineering trick 在于 MoE 架构——每个 token 只激活 3B 参数。这意味着一个 80B 参数的模型,generation latency 和一个 3B 模型几乎一样快。
GLM-5.2 Nano
这是智谱的轻量版本,参数量大幅缩减,但仍然保持了对长上下文的处理能力。适合那些需要快速本地部署、不需要最顶级推理能力的开发者。
MiniMax M3 Edge
MiniMax 的 Edge 版本保留了 multimodal 能力,但模型规模被压缩到可以在消费级 GPU 上运行的程度。适合需要视觉理解的本地开发场景。
Qwen3-Coder-Next-Instruct
这是 Qwen3-Coder-Next 的 instruction-tuned 版本,针对日常 coding 任务进行了优化。如果你只需要一个能帮你写日常 CRUD、debug 和 review code 的本地模型,这个版本最合适。
总结
2026 年的开源 coding LLM 格局已经清晰:前沿六强通过 API 提供接近闭源模型的能力,价格却低得多;四个可运行模型则让个人开发者在本地就能获得接近前沿的体验。选择哪个模型,取决于你的硬件条件和使用场景。但有一点是确定的——开源 coding model 已经不再是"将就"的选项,而是很多场景下的首选。