上个月团队做了一件事:给内部的 Agent Runtime 加了一套 Memory + Skill 沉淀机制,然后跟老板说「以后这个 Agent 会越用越聪明」。老板问了一个问题,让全桌鸦雀无声——怎么证明?你说它进化了,但拿不出一张成绩单。跑过几次任务、写了几页 log、存了几段记忆——这些东西到底有没有让 Agent 下次干活更利落?是快了?还是反而变慢了?还是没变化?
过去一年,几乎所有严肃的 Agent 框架都在往「自我进化」方向卷:Memory、Skill 自动沉淀、Reflection 反思、自改写 Prompt、甚至自动重构自身 DAG。但有一个共同的缺口——没人知道这些机制到底有没有用、用了多少。
主流的 Agent Benchmark 都在测「Agent 初始有多强」:GAIA 测真实世界任务、ClawBench 测浏览器操作、MMLU 测知识推理。这些榜单回答的是「Agent 能不能」,而不是「Agent 能不能越来越能」。直到发现了 LIFT 这个项目。
01 什么是 LIFT
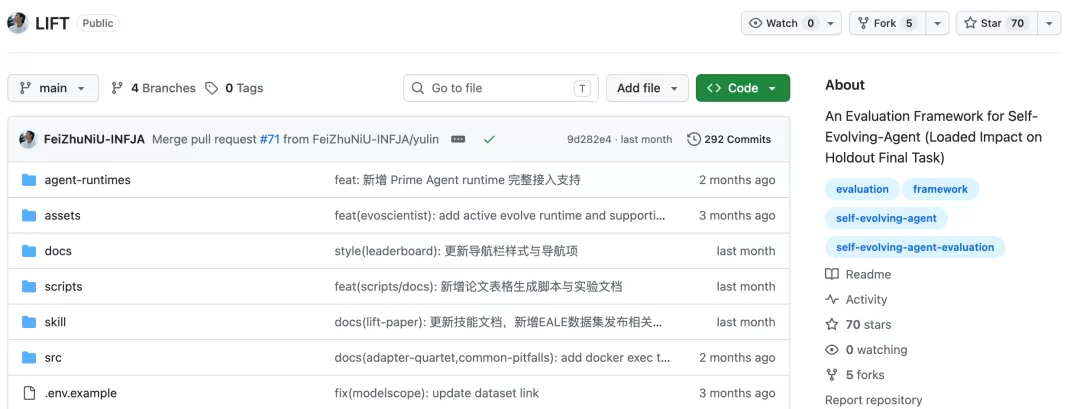
LIFT 是一套专门面向 Agent 自我进化能力的开源评测框架,来自 Infja 团队。项目地址在 github.com/FeiZhuNiU-INFJA/LIFT。
核心定位一句话就能说清:传统 Benchmark 测 Agent 有多强,LIFT 开始测 Agent 能不能变强。它不评测 Agent 本身的开箱能力——数学、代码、推理交给 GAIA、ClawBench 们。LIFT 只关心一个朴素问题:Agent 做完练习题、跑过一轮记忆沉淀之后,同一套期末考题,它比进化之前考得好吗?好多少?
02 一个被普遍误解的概念
很多人以为给 Agent 加个 Memory 就是 Self-Evolution,其实不是。「记住过去的信息」和「学会过去的经验」是两回事。前者只是存储,后者才是真正的进化。
举个例子:Agent 做了一道题,把题目和答案存进向量数据库,下次遇到类似题能检索到——这是 Memory。而真正的 Self-Evolution 是:Agent 做完题后反思解题过程中的冗余步骤,提炼出一个 Skill,下次再遇到同类题直接调用 Skill,用更少的对话轮数和工具调用完成。LIFT 量化的是后者——进化带来的边际收益。
03 LIFT 怎么测
整个评测分三组任务:
- Warmup Tasks(练习题)——让 Agent 先跑一批题,触发进化机制(写 Memory、沉淀 Skill、做 Reflection)
- Holdout Tasks(期末考)——同一组考题跑两遍:Baseline(干净环境,零进化产物)vs Evolved(加载进化产物后)
然后把两组成绩摆在一起看差距。关键设计:Warmup 共用一个容器保证状态连续,每道 Holdout 起新容器防止污染,进化产物以 Docker 镜像形式落地确保对照对称。
04 评测数据长什么样
LIFT 的 Benchmark 数据集设计精细,人能直接读,机器也能直接跑。按三层结构分层:总数据集 -> 场景数据集(Suite)-> 训练/测试任务。
每个任务包含三个元素:query(模拟用户第一次开口,刻意保持口语化和不完整)、要求(真正的验收清单,至少 12 条,每条可独立验证)、轨迹要求(约束 Agent 用什么方法完成任务,而不只是"完成了就行")。
测试集与训练集有 75% 的要求重合度,剩下 25% 是变体或矛盾——检验 Agent 是否能灵活迁移经验,而不是死记硬背或过拟合。
05 另一个 Agent 扮演用户
LIFT 最精巧的设计是不用一次性 pass/fail 来判 Agent,而是用另一个 LLM 来模拟真实的人机交互过程。LLM Judge 只发 query(不透露要求),Agent 执行任务产出文件后,Judge 用所有「要求」逐条检查。全通过则成功,有未过的则以自然口吻反馈,进入修正循环。
为什么 Judge 只披露前两条未完成的要求?因为一次把所有要求都告诉 Agent 等于给了"标准答案"。真实用户的反馈是渐进式的,这迫使 Agent 在"理解需求 -> 产出 -> 接收反馈 -> 迭代"的循环里工作。
06 仪表盘 + 在线排行榜
LIFT 用四个「越低越好」的效率指标来衡量进化收益:Delta Turns%(对话轮数变化率)、Delta Tools%(工具调用次数变化率)、Delta Tokens%(Token 消耗变化率)、Delta Latency%(延迟变化率)。负数表示变好,正数表示变差。
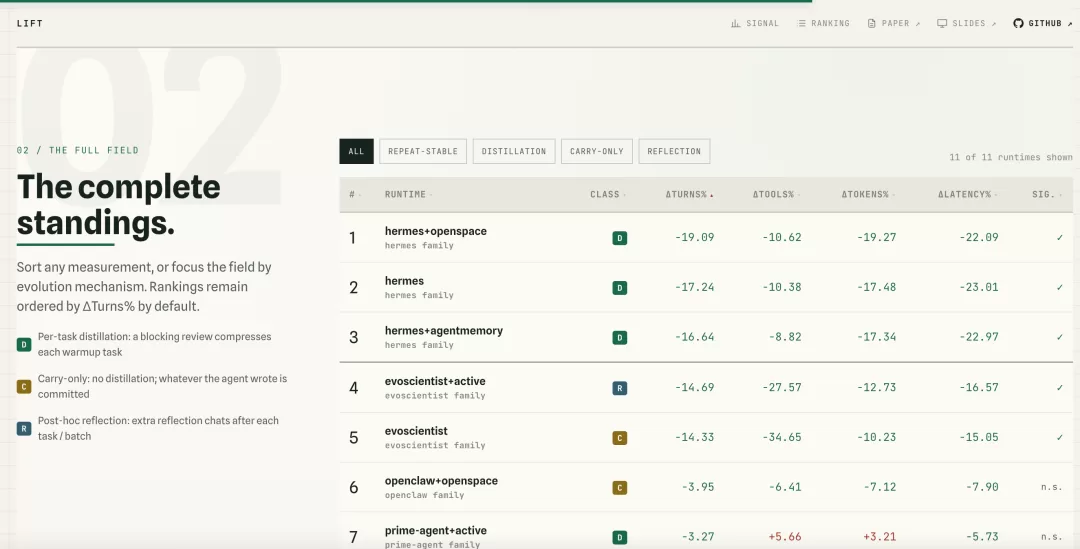
目前排行榜已收录 11 个不同的 Agent Runtime,用 10 次重复试验确保统计显著性。数据表明:
Hermes 系列领跑,三种配置的 Delta Turns% 都稳定在 -17% 到 -19% 之间,95% 置信区间完全在零以下——进化是可复现、统计显著的。裸奔的 OpenClaw(无进化机制)反而略微变慢(+2.74%)。逐题蒸馏这种进化方式效果最好,比事后反思和仅累积 Memory 都强。
07 跑得快也跑得稳
LIFT 默认用 3 repeats x 14 suites x 6 holdouts 的矩阵跑评测,holdout 阶段峰值有 36 个 Docker 容器同时运行。通过 Cell 级隔离 + 自动重试、容器端口随机化、资源闸门等机制保证稳定性。
08 技术架构
整个评测流程完全跑在 Docker 容器里。核心是三类镜像:Base 镜像(干净基础)、Delta 镜像(Warmup 后通过 docker commit 生成的增量镜像)、Evolved 镜像(Base + Delta 叠加后的完整状态)。Baseline 和 Evolved 的唯一变量就是"有没有加载 Delta",任何性能差异都可以归因于进化本身。
所有 Agent 对话、工具调用、Token 消耗都通过 Langfuse 进行全链路 Trace,每一轮对话的 Prompt/Response 都有完整记录。
写在最后
LIFT 的价值不只在于它是一个评测框架,更在于它给了 Agent 行业一个问题的答案——Agent 的竞争,终有一天会从「谁初始能力更强」变成「谁更善于从经验中持续进化」。LIFT 想为这个方向建立一套公开、可复现的评测标准。