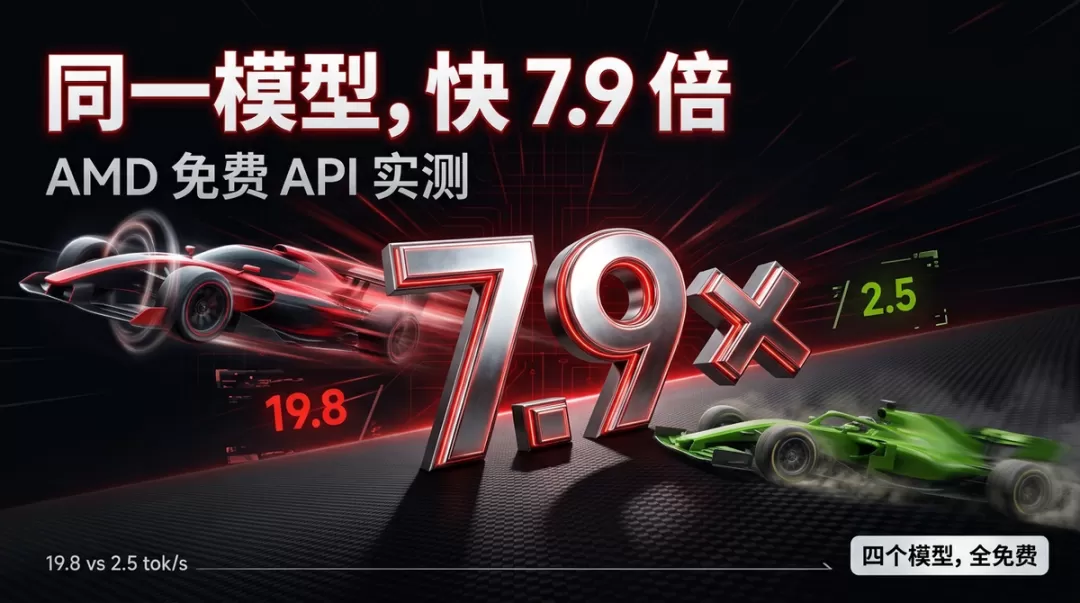
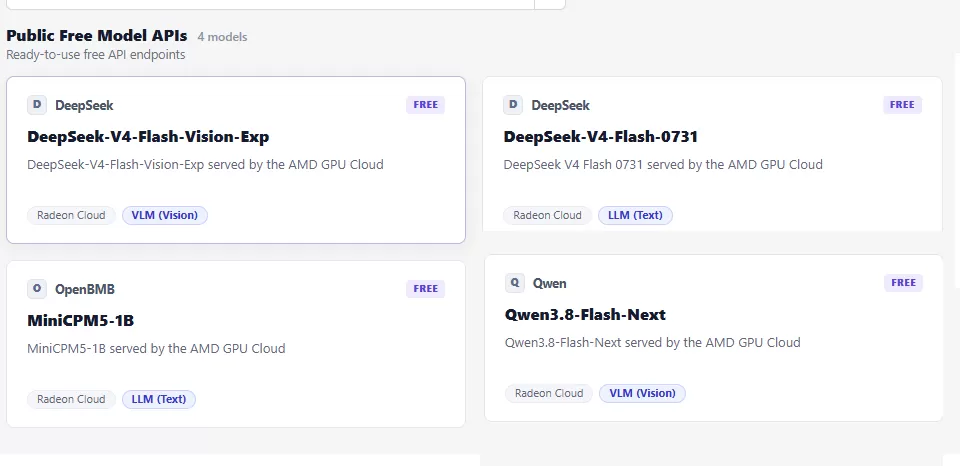
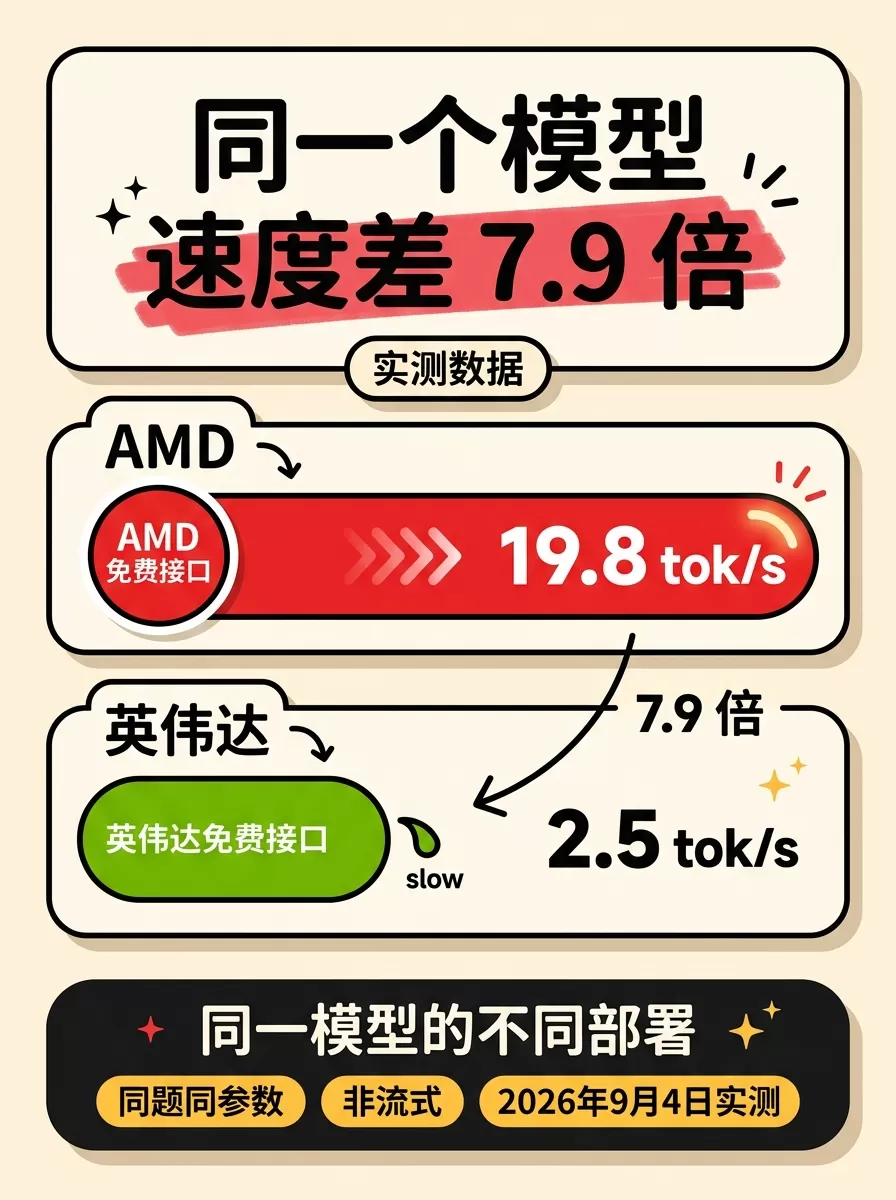
AMD 开发者站上挂着四个免费的大模型 API,注册拿 key,接口 OpenAI 兼容。我把它们和英伟达的免费接口放在一起,用同一道题跑了一轮。同一个 DeepSeek V4 Flash,AMD 输出 19.8 tok/s,英伟达 2.5 tok/s,差 7.9 倍。
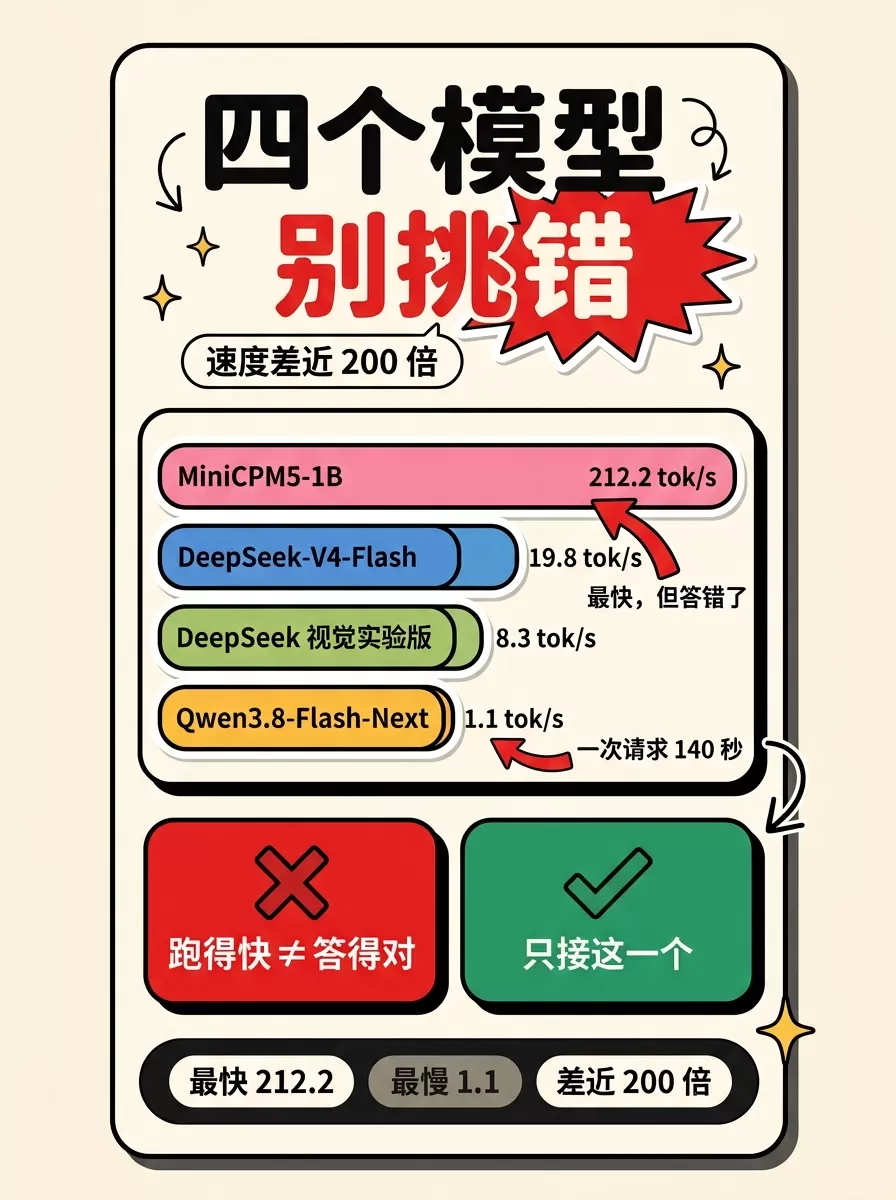
但这个倍数救不了挑错模型的人。AMD 自家四个模型里,最快的 MiniCPM5-1B 跑 212.2 tok/s,最慢的 Qwen3.8-Flash-Next 跑 1.1 tok/s,内部差了近 200 倍。
四个模型是什么,以及怎么拿 key
打开 AMD Radeon TokenFactory,页面列出四个 Public Free Model APIs,全部跑在 AMD GPU Cloud 上:
| 模型 | 上下文 | 输入(pts/M) | 输出(pts/M) | 缓存读 | 视觉 |
|---|---|---|---|---|---|
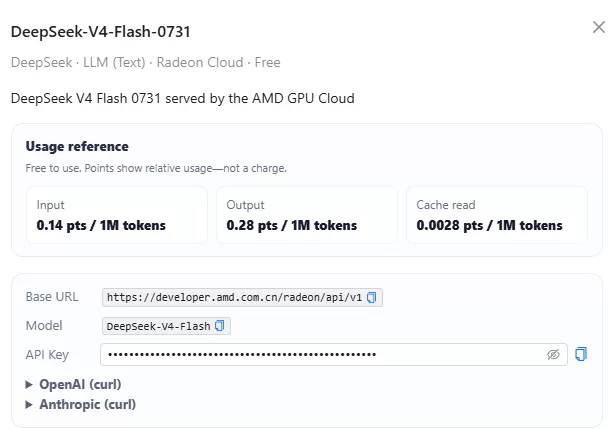
| DeepSeek-V4-Flash | 1,048,576 | 0.14 | 0.28 | 0.0028 | ✗ |
| DeepSeek-V4-Flash-Vision-Exp | 1,048,576 | 0.14 | 0.28 | 0.0028 | ✓ |
| Qwen3.8-Flash-Next | 262,144 | 0.15 | 0.47 | 0.016 | ✓ |
| MiniCPM5-1B | 131,072 | 0.124 | 0.7425 | 0.124 | ✗ |
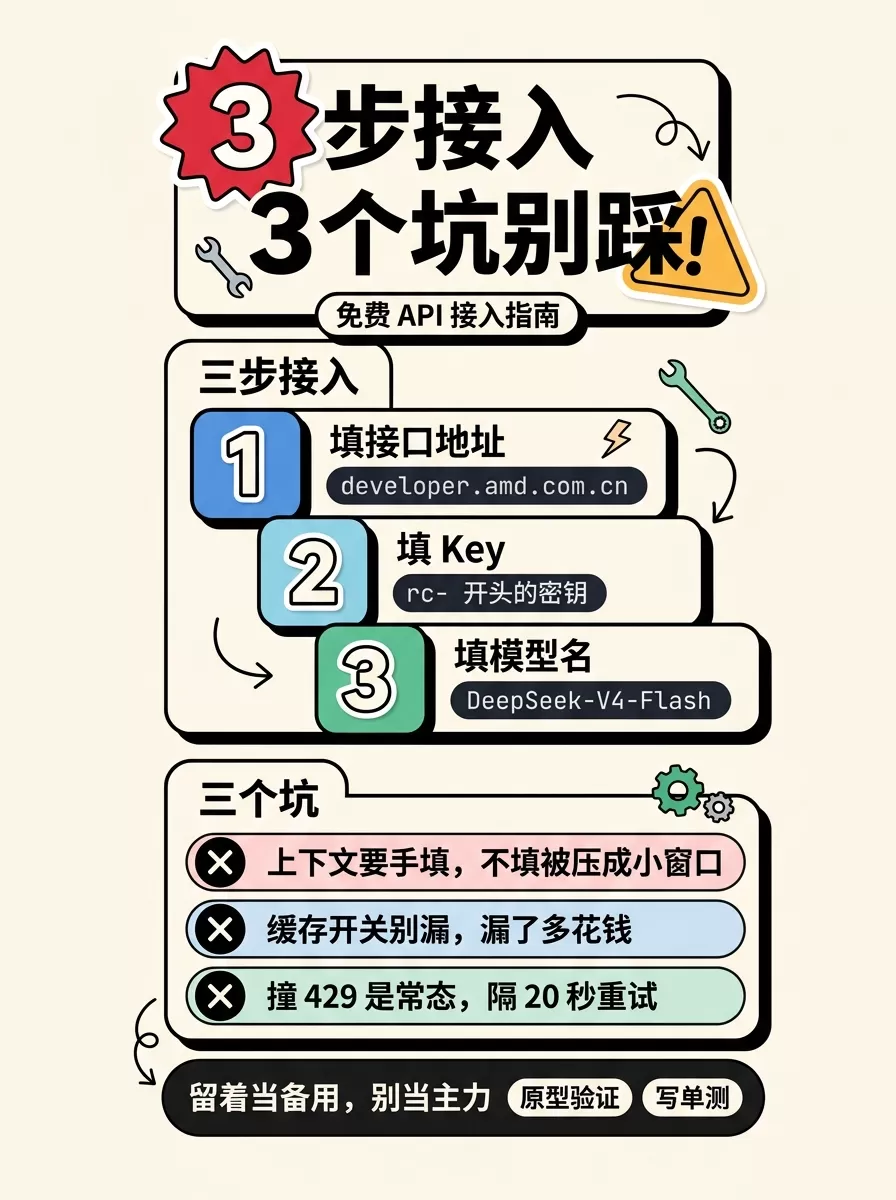
价格单位是 pts / 1M tokens。NVIDIA 的 integrate.api.nvidia.com 免费接口同样限速率;AMD 这边我连着打第二轮时撞过一次 HTTP 429,间隔 20 秒重试就通了。两边都不是无限量,别拿它跑批量任务。
拿 key 的流程是:登录 AMD 开发者账号后进 Radeon TokenFactory 生成 token,前缀是 rc-。验证最快的方式是直接打 models 接口:
curl https://developer.amd.com.cn/radeon/api/v1/models \ -H "Authorization: Bearer rc-xxxx"HTTP 200,1.23 秒返回,四个模型全在。
实测:AMD 和英伟达跑同一道题
测试条件两家完全一致。同一道题("用一句话解释什么是温度系数采样,然后写一段 Python 的斐波那契函数"),非流式,max_tokens 300,串行请求。
AMD 四个模型:
| 模型 | 耗时 | 输出速度 | 结果 |
|---|---|---|---|
| MiniCPM5-1B | 1.41s | 212.2 tok/s | 答错 |
| DeepSeek-V4-Flash | 7.63s | 19.8 tok/s | 正确 |
| DeepSeek-V4-Flash-Vision-Exp | 22.82s | 8.3 tok/s | 正确 |
| Qwen3.8-Flash-Next | 140.33s | 约 1.1 tok/s | 正确 |
英伟达免费接口:
| 模型 | 耗时 | 输出速度 |
|---|---|---|
| deepseek-v4-flash-0731 | 70.57s | 2.5 tok/s |
| kimi-k3 | 61.53s | 4.8 tok/s |
AMD 的 DeepSeek-V4-Flash 和英伟达的 deepseek-ai/deepseek-v4-flash-0731 是同一个模型的不同部署。19.8 对 2.5,7.9 倍。横向看,AMD 的 Vision-Exp 跑 8.3 tok/s,英伟达最快的 kimi-k3 跑 4.8 tok/s。除了 Qwen3.8-Flash-Next,AMD 在剩下的每一项上都更快。
MiniCPM5-1B 甩出 212 tok/s,但它答错了——题目问的是采样温度,它答成了温度传感器采样。1B 量级的模型,跑得快和答得对是两回事。
接入 opencode
opencode 的 provider 配置写在 ~/.config/opencode/opencode.json:
{
  "amd": {
    "models": {
      "DeepSeek-V4-Flash": {
        "name": "DeepSeek-V4-Flash",
        "limit": {"context": 1048576, "output": 384000}
      }
    },
    "npm": "@ai-sdk/openai-compatible",
    "options": {
      "apiKey": "rc-xxx",
      "baseURL": "https://developer.amd.com.cn/radeon/api/v1",
      "setCacheKey": true
    }
  }
}
三个字段容易填错:npm 必须是 @ai-sdk/openai-compatible;baseURL 末尾的 /v1 不能省;setCacheKey: true 是让 prompt 缓存生效的开关,对应便宜 50 倍的缓存读价。
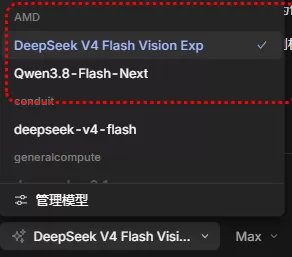
改完把顶层 model 设成 amd/DeepSeek-V4-Flash,或者启动时用 /model 切。
接入 WorkBuddy
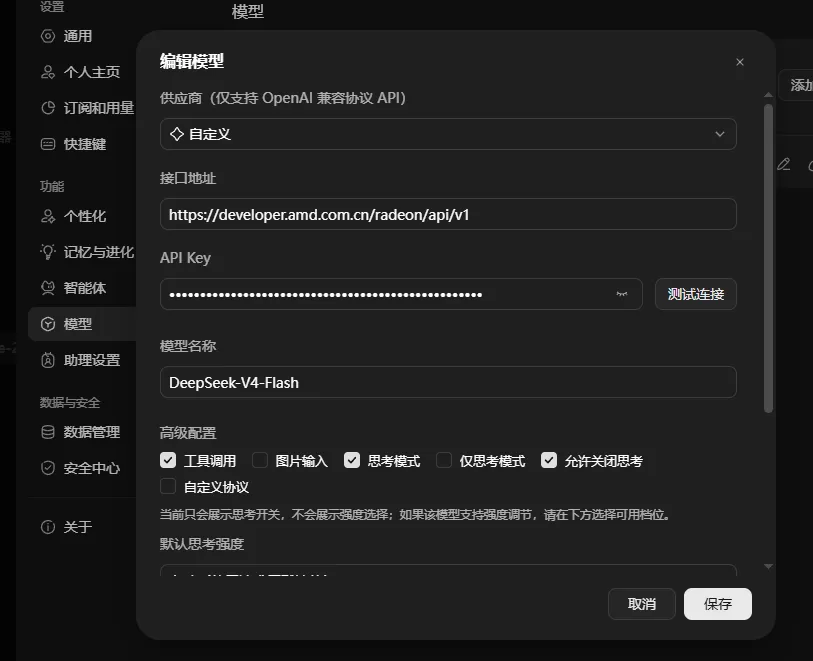
图形界面:左下角账户头像 → 设置 → 左侧导航"模型"→ 自定义模型区域点"添加模型"。提供商选"自定义 / Custom",接口地址填 https://developer.amd.com.cn/radeon/api/v1,API Key 填 rc- key,模型名称填 DeepSeek-V4-Flash。
DeepSeek-V4-Flash 实测支持工具调用,勾上"工具调用";它没有视觉能力,"图片输入"别勾。
另一条路是直接写 ~/.workbuddy/models.json,WorkBuddy 会监听文件变更并热重载:
[
  {
    "id": "DeepSeek-V4-Flash",
    "name": "AMD DeepSeek-V4-Flash (免费)",
    "vendor": "Custom",
    "url": "https://developer.amd.com.cn/radeon/api/v1",
    "apiKey": "rc-xxx",
    "supportsToolCall": true,
    "supportsImages": false,
    "supportsReasoning": true,
    "useCustomProtocol": false
  }
]
适用边界与三条建议
该用的:想先把编码工具跑起来、不想掏钱的人。需要一个备用端点、在几个免费额度之间来回切的人。任务类型限于原型验证、写单测、改文档这类对延迟不敏感的活。DeepSeek-V4-Flash 的 19.8 tok/s,干这些够用。
别用的:要跑长上下文、多轮 Agent 的人——Qwen3.8-Flash-Next 一个请求 140 秒,一轮循环下来你会以为它死了。需要视觉输入的也别指望,Vision-Exp 是 8.3 tok/s 的实验版。MiniCPM5-1B 的速度像本地模型,错误率也像本地 1B 模型。
三条建议:
- 只接 DeepSeek-V4-Flash 一个,它是四个里唯一同时做到"跑得动"和"答得对"的
- limit.context 和 setCacheKey 别漏——前者决定你能读多长的代码,后者决定你实际花多少钱
- 429 当常态处理——连着打第二轮我就撞上了,隔 20 秒重试即通,批量脚本里加个退避
免费的额度按 token 计价,时间不按 token 计价。7.9 倍的速度差能把一个免费工具从"忍一忍"推到"能日常用",前提是你挑对了那个模型。