换了电脑、换了 Agent,如何迁移数据让 AI 还能记得你的上下文?这是很多朋友问我的问题。
"harness" 在 AI 领域指的是模型之外、让模型能干活的整套结构。可以分为两部分:一部分是 Claude Code、Codex、WorkBuddy、豆包等定义好的工程环境;另一部分,是使用 Agent 的人自己决定的——模型能读到哪些文件、能调哪些工具、记得什么。
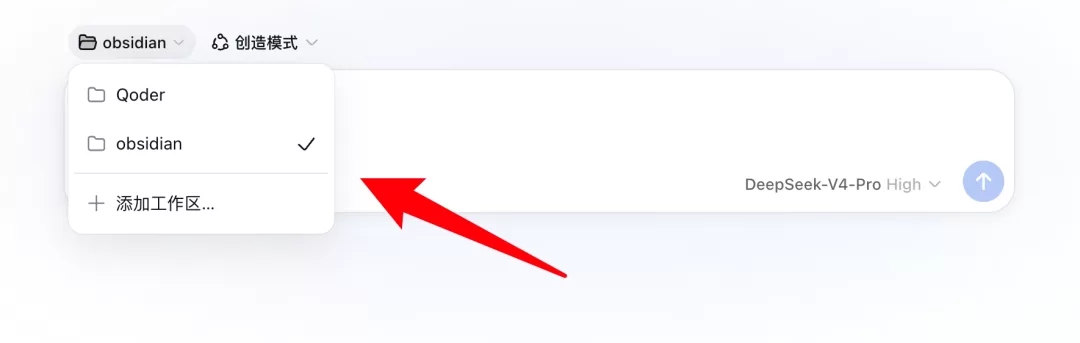
这部分得自己动手搭建,整理自己的上下文,换了不同的 Agent,选中文件夹,就能让它知道你是谁,正在做什么。
我几个月前把个人 harness 的搭建方法,做成了三个 Skill 放在 GitHub 上:
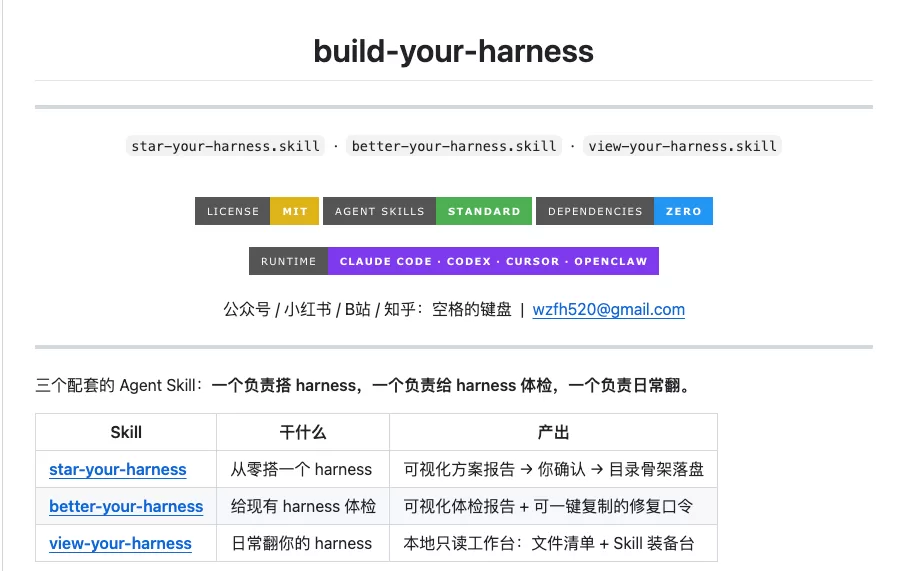
- star-your-harness:问你四个问题,按职业生成一套目录骨架,你自己选择相关内容按骨架搭建上下文。
- better-your-harness:给现有的 harness 做体检,出一份 HTML 报告和修复口令。
- view-your-harness:起一个本地服务,把文件夹和 Skill 变成可视化的个人工作台。
2.0 版本解决三个核心问题
- 如何迁移数据使不同 Agent 共享上下文、工具、记忆?
- 如何把社媒数据动态拉取,让不同 Agent 实时获取我创作了什么?
- 如何把上述所有文件推送到云端,实现跨设备共享?
为此我查了不少开源项目:LifeOS(2 万 star,一套 AI harness 原样发布)、claude-obsidian(约 1.6 万 star,素材自动写成互链 wiki)、obsidian-mind(约 5500 star,给 Agent 提供持久记忆的 vault 模板)。
这些项目热度很高,但大多是"克隆模板",且都半年多没更新了。所以我用 Claude 改造了 build your harness 1.0,对个人一年积攒的 5000 多个文件做体检、精简目录、建入口、生成个人动态画像、创建共享及云端 git 推送规则。
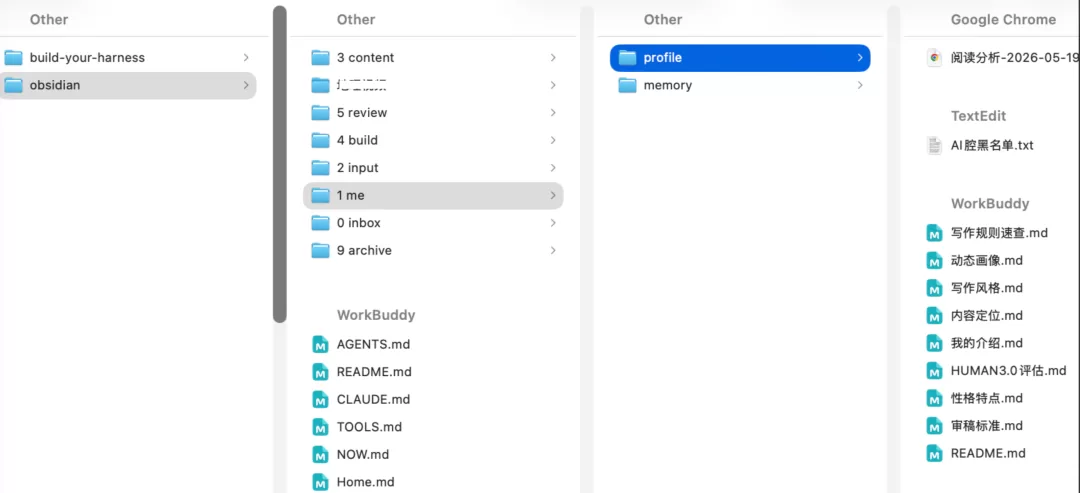
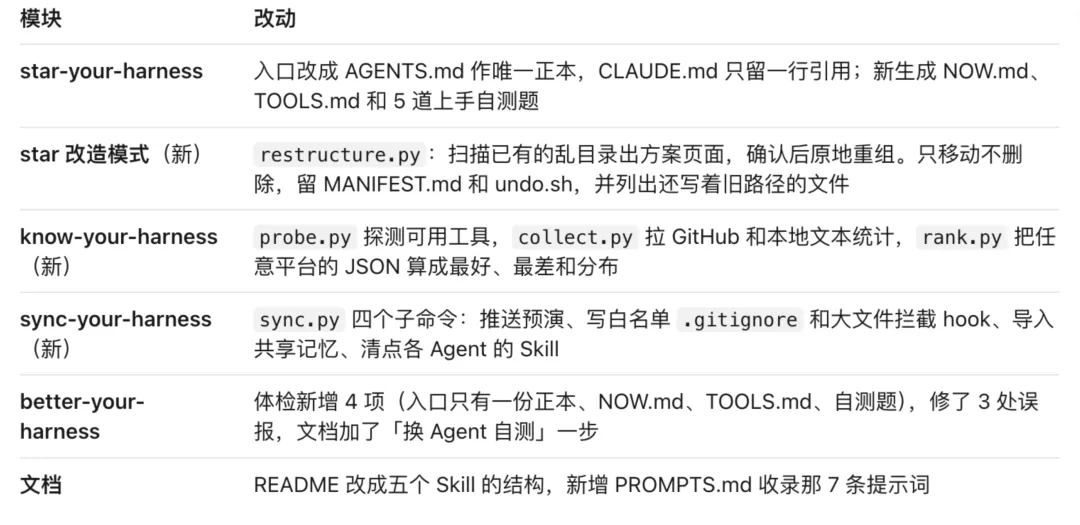
一轮对话下来,顶层的 24 个目录变成了 7 个。build-your-harness 升级到了 2.0 版本,新增了 know-your-harness 和 sync-your-harness,也对之前的 build、view、better 做了优化。
它可以帮你把现有的乱目录原地重组,让所有 Agent 共用同一个入口,用真实数据生成个人画像,并且放心地同步到 GitHub。使用 git 存储数据,只需要推送文稿类文件,图片视频就不需要了,可以限制在 1MB 或 5MB 以内。
01 star-your-harness:重组你的目录
如果你手里已经有一堆用了很久的文件,不想从零建新文件夹,直接对 Agent 说一句:我的目录太乱了,帮我重组。
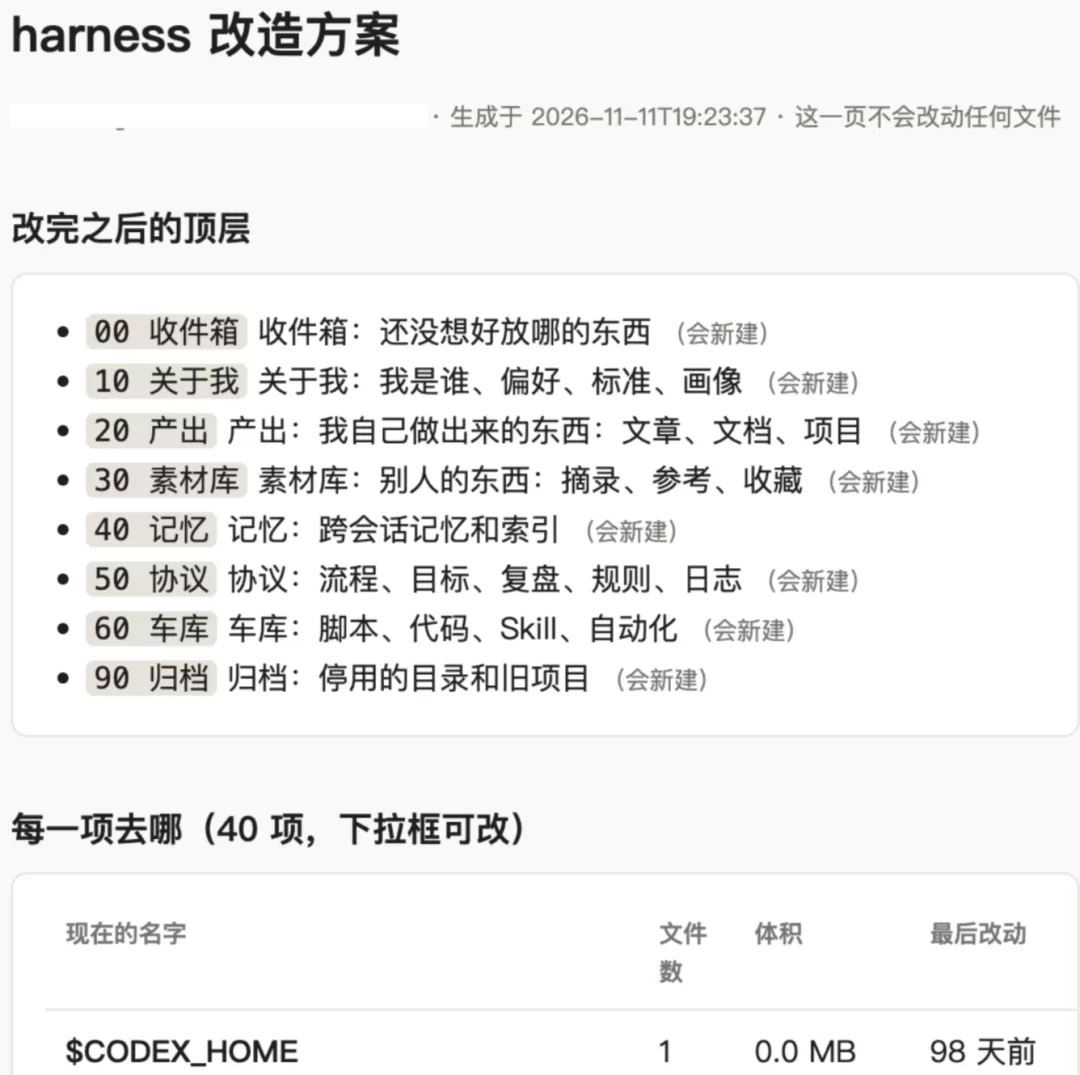
它先只读扫描,给你出一个 HTML 方案页面。每个顶层目录占一行:多少文件、多大、多久没动、建议去哪、为什么。每一行都有下拉框,你可以改它的建议。调完点"复制我的决定",粘回对话,它才开始动手:
- 只移动,不删除
- 目标位置有同名的就跳过,不合并不覆盖
- 每一次移动都记进 MANIFEST.md,同时生成 undo.sh,一条命令原路退回
移动完它还会告诉你,哪些文件里还写着旧路径,需要你确认后再改。整理文件可以交给 AI 干,但后悔药必须握在自己手里。
02 统一入口:一个文件夹,所有 Agent 共用
1.0 的入口是 CLAUDE.md,只有 Claude Code 会读。2.0 改成了 AGENTS.md,CLAUDE.md 只留一行引用它。Codex、Cursor、WorkBuddy 读到的都是同一份。
同时在之前多了两个文件:
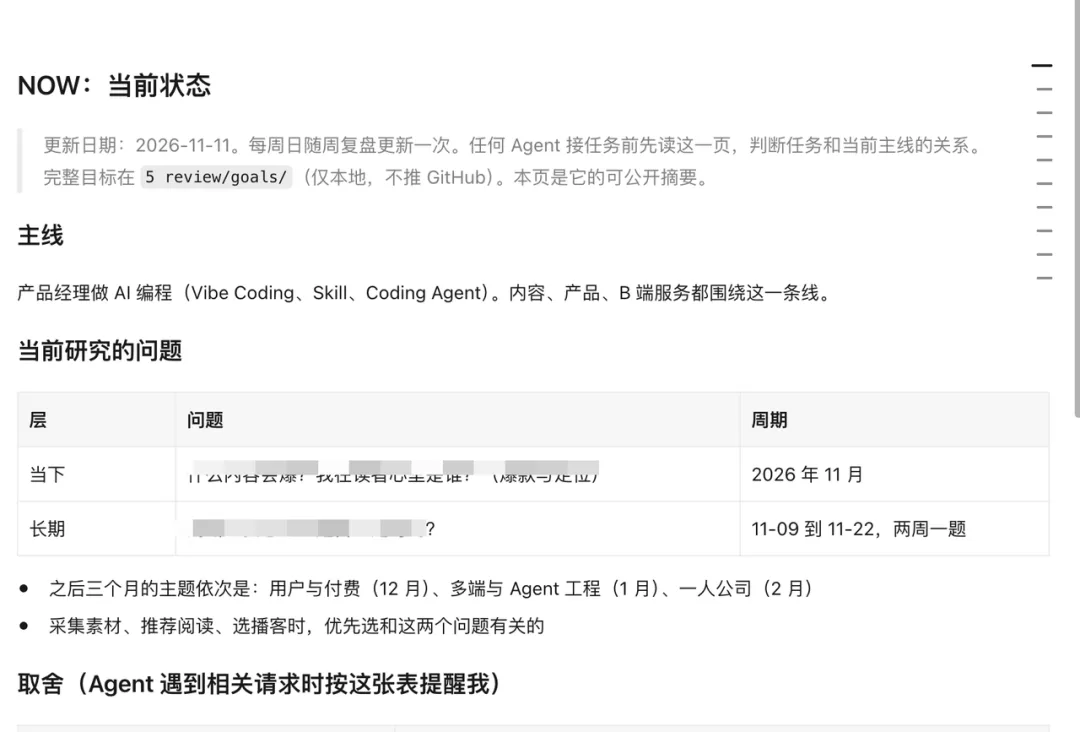
1)NOW.md——记录我现在的主线、本周在做什么、哪些事明确不做。这次我让 AI 帮我把明年的目标拆到了每周,摘要就放在这一页。Agent 接任务前先读它,偏离主线会提醒我。
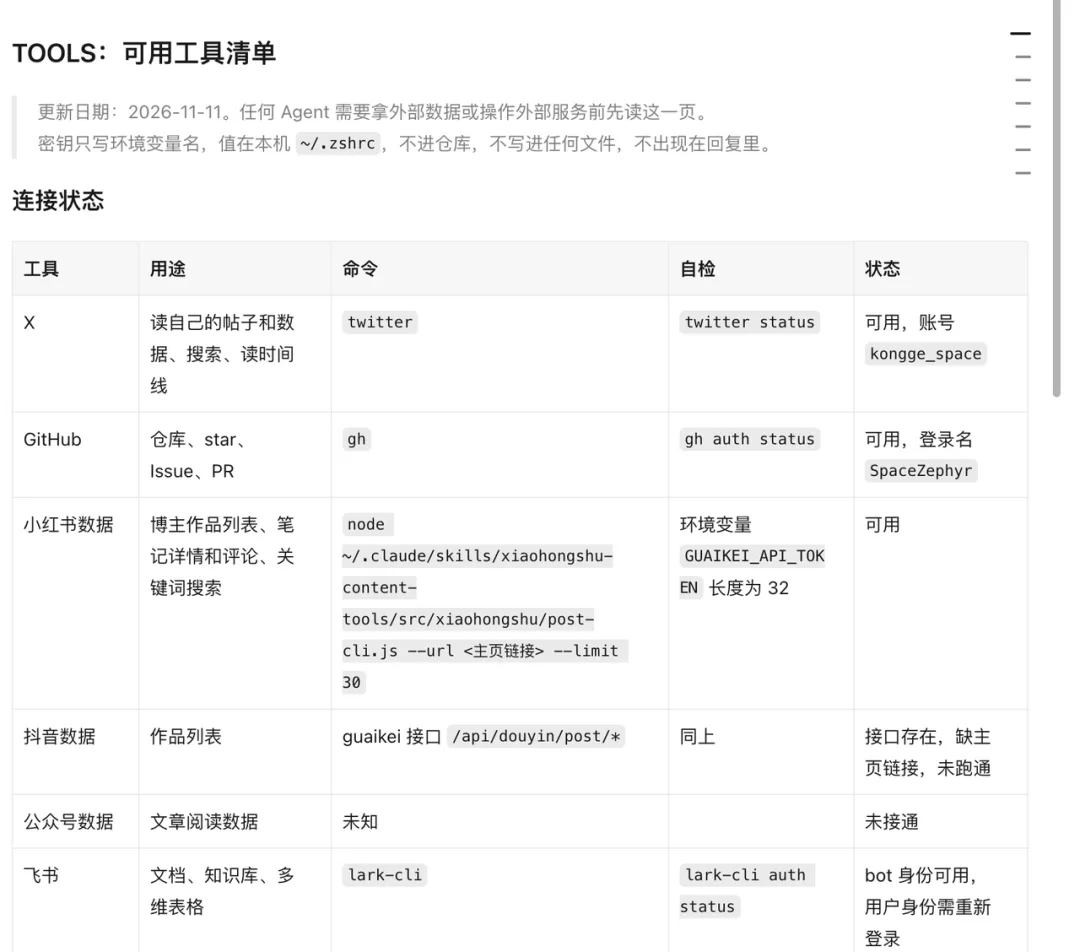
2)TOOLS.md——记录我能用哪些工具、怎么调、自检命令是什么、调一次多少钱。密钥只写环境变量的名字,值不进任何文件。
03 know-your-harness:让 Agent 认识你
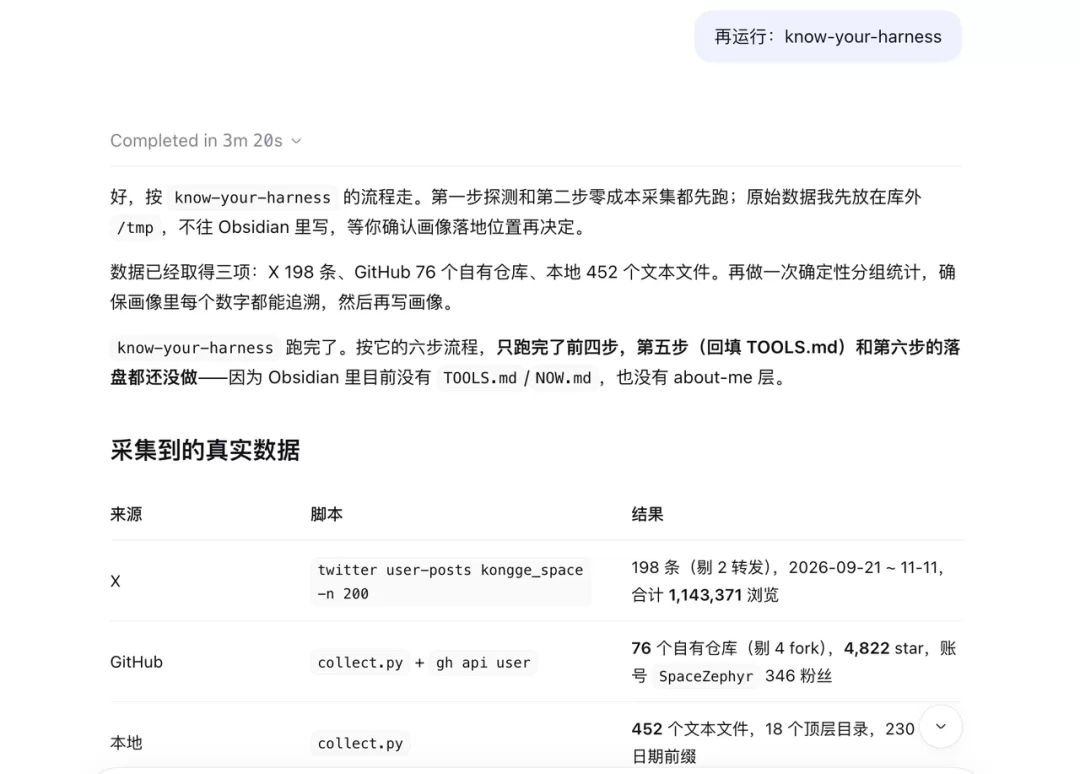
1.0 会给你三份空模板:我是谁、工作偏好、质量标准。这种模板,很少有人能填完。2.0 换了个思路,不让人写自我介绍,直接看个人在社交媒体发过什么。
它先探测你电脑上有哪些工具能拿数据,再拉你在社交媒体发过的内容,用脚本算出什么表现好、什么表现差。我拿自己的数据跑了一遍:X 最近 199 条帖子,小红书 300 条笔记,都保存在了本地。这些数据比个人去整理内容,更能够让 Agent 理解我个人的创作方向、写作风格。
04 sync-your-harness:同步到不同设备
harness 想多台电脑用、多个 Agent 用,最省事的办法是放进一个 Git 仓库。不管用什么设备,只需要发一个 git 链接就能让这个设备同步你的内容。这个 Skill 会做四件事:
- 推送预演:告诉你按规则会推多少文件、挡住多少、有没有疑似密钥落在要推的文件里。
- 定时推送:根据你的习惯设置推送脚本,定时在本地把文件夹推送到云端。
- 大文件拦截:提交前自动拦住超过 1MB 的文件。
- 共享记忆和 Skill 清点:把某个 Agent 私有的记忆复制成所有 Agent 共用的,再清点一遍各处的 Skill。
05 better-your-harness:迁移到不同 Agent
体检还是之前的五层扫描,这次从 34 项增加到了 38 项。多查了 4 项:有没有 NOW.md,有没有 TOOLS.md,有没有迁移自测。
还多了一项迁移自测:在 AGENTS.md 末尾放 5 道题,当你迁移到不同 Agent,这 5 道题可以帮助 Agent 自测是否打通了你的数据。比如:我的内容主线是什么?一篇文章存在哪里,写完要更新哪个索引?
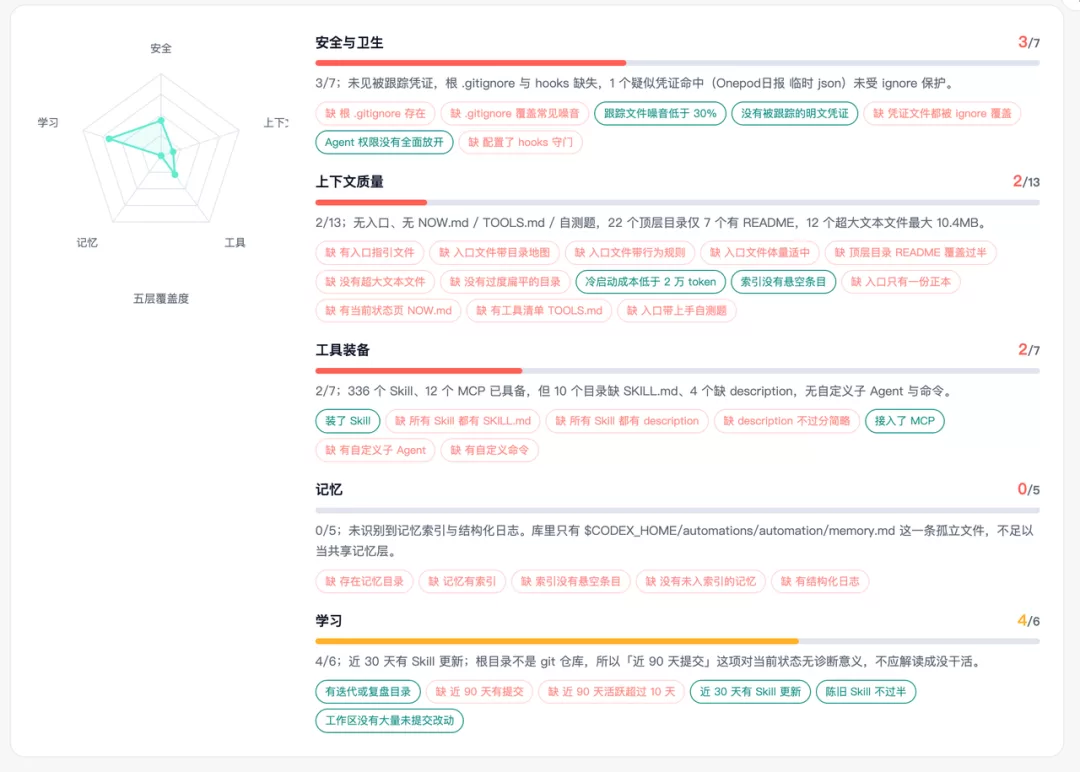
用 Claude Code 搭的,就用 Codex 验。答不出来,说明文件缺了东西。结构体检查的是文件夹整不整齐,自测查的是 AI 是不是真的懂你。
06 最后
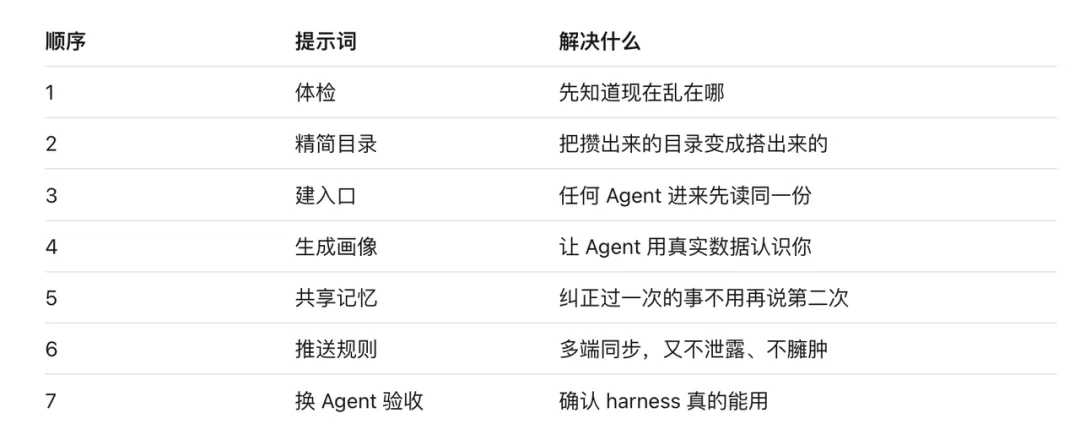
如果你不想装 Skill,仓库里也放了一份 PROMPTS.md,7 条提示词对应上面的每一步:体检、精简目录、建入口、生成画像、共享记忆、推送规则、换 Agent 验收。整块复制给任何 Agent 就能用。
模型每隔几个月就换一代。但我的目录、偏好、目标、工具清单,会持续沉淀在这份文件夹里。下一个最强模型出来的时候,把这个文件夹发给它就行了。