你是否遇到过这样的困境?硬盘里堆满PDF论文、Excel报表、日志文件、祖传源码,想要检索某一段文字,系统文件搜索只能匹配文件名,根本搜文件内部内容。想上Elasticsearch?先要部署JVM、编写复杂Mapping,机器负载飙升风扇狂转,部署维护成本极高。
而当下最头疼的是AI Agent编码场景:Agent用grep检索代码,就算匹配到目标行,依旧要读取整个文件塞进上下文,海量Token疯狂消耗,成本居高不下。
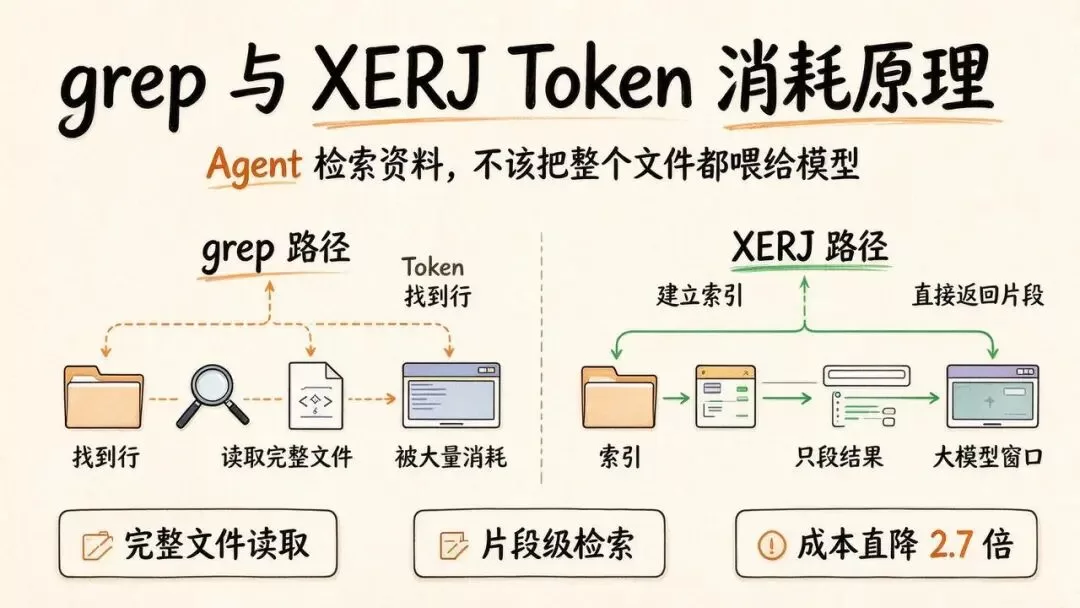
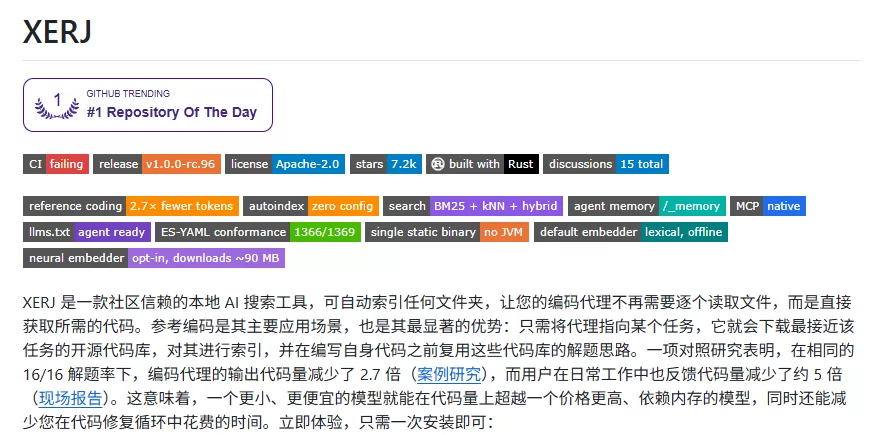
XERJ,一款Rust开发、单静态二进制分发的本地AI搜索引擎,完美解决这个痛点。一条 xerj autoindex 命令,自动识别目录下全部文件并建立索引,直接返回精准片段+文件行号,不再把完整文件喂给大模型。同时兼容Elasticsearch API,现有ES客户端、Kibana看板直接复用。
01|为什么grep正在疯狂烧掉你的Token
很多编码智能体标准工作流:grep定位匹配行,然后读取完整源码文件送入LLM上下文。官方实测,这种方式输入Token最高可达106万。模型对不熟悉API会反复重试,每一轮都重复读取文件,持续付费。
XERJ的思路完全不同:提前将文件夹构建检索索引,Agent只查询匹配段落,按需取回片段,不再读取完整文件,也就是参考式编码(Reference Coding)。Agent在写代码前,检索同类开源项目解决方案,引用已有实现,而不是凭空硬写。
02|实测数据
| 方式 | 输出Token | 费用 | 完成任务 |
|---|---|---|---|
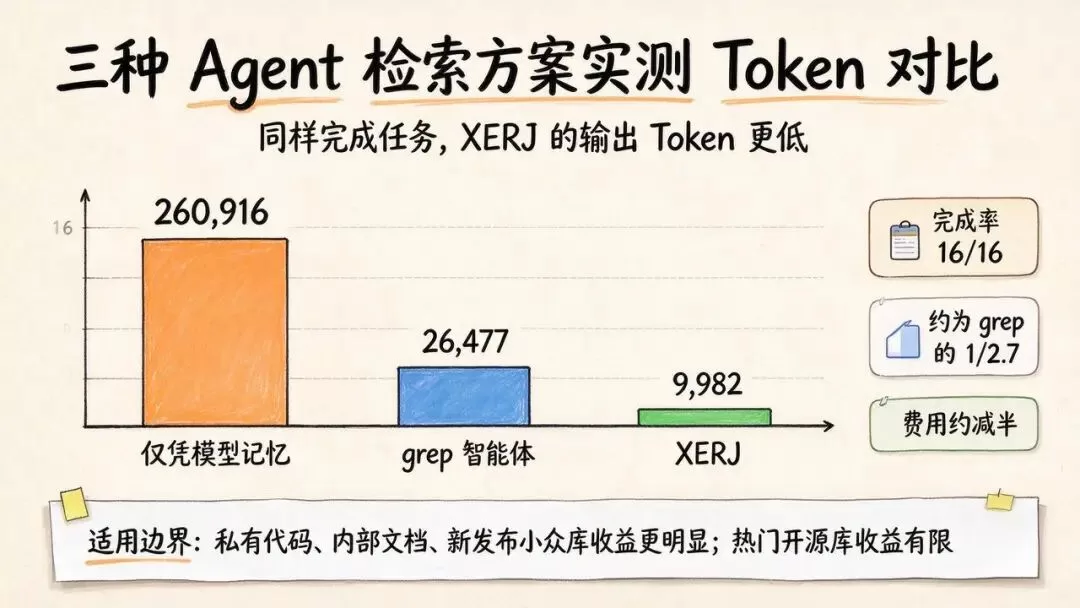
| 仅凭模型记忆 | 260,916 | $11.18 | 11/16 |
| 使用grep的智能体 | 26,477 | $3.27 | 16/16 |
| XERJ | 9,982 | $1.58 | 16/16 |
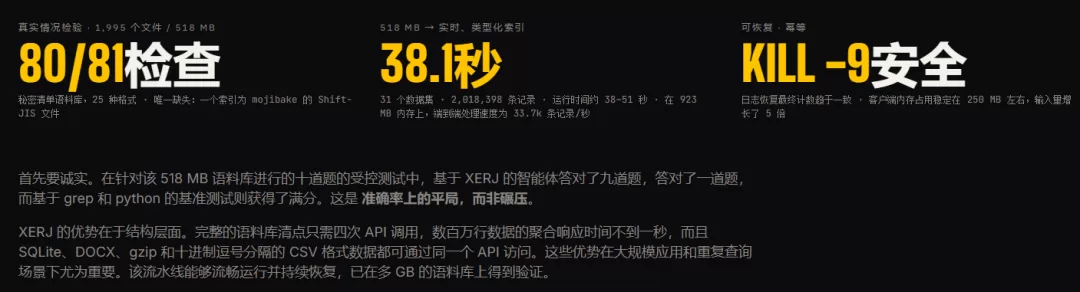
同样100%解题率,XERJ输出Token是grep模式的1/2.7,相比纯模型记忆减少26倍,费用直接减半;单个Java任务最高节省278倍Token。日常开发者真实反馈,端到端Token用量能降到原来的1/5。
诚实边界:对于大模型训练数据里已经熟记的热门开源库,XERJ收益有限甚至增加开销;真正适合私有代码、内部文档、新发布小众库。
03|XERJ核心特性
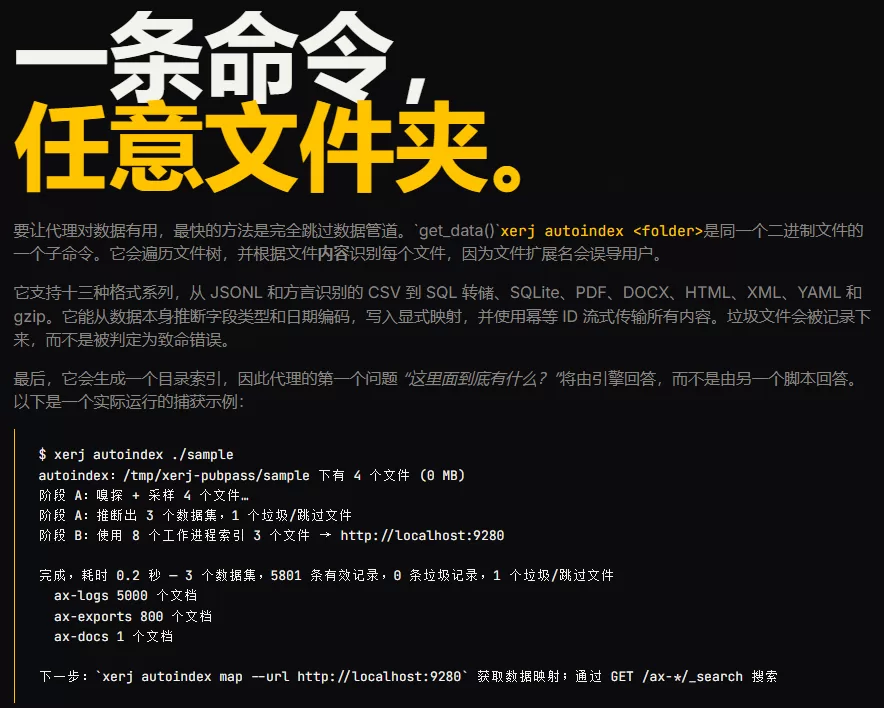
一条命令自动索引,无需编写Schema:xerj autoindex,丢任意文件夹,自动嗅探识别文件类型,跳过垃圾文件,自动为数据集创建索引。官方示例:索引25329个文件,推断593个数据集,跳过1955个垃圾文件,158秒完成,生成83103条可检索记录。
源代码采用tree-sitter解析,保留AST符号、函数签名、行号,不是简单扁平文本。支持 xerj def,直接定位函数定义,自带跳转定义能力。
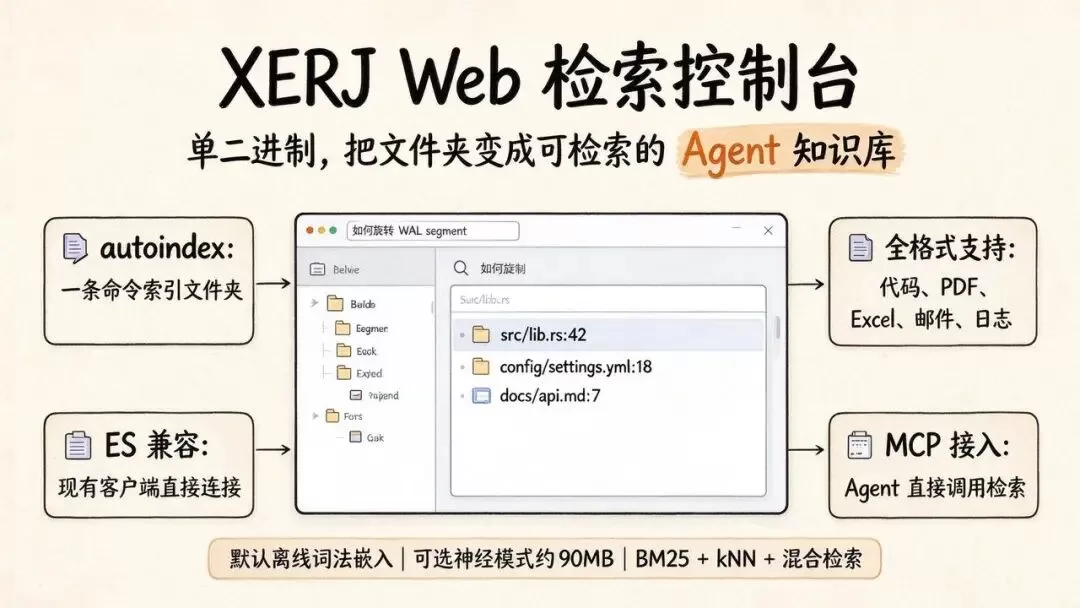
支持格式覆盖面极广:代码文件、CSV、JSON、YAML、SQLite数据库、PDF、DOCX、PPTX(每页幻灯片单独一条记录)、Excel(每个工作表独立数据集)、EPUB电子书(按章节分记录)、Jupyter Notebook、man手册、HTML、邮件.eml/mbox等。
Elasticsearch API高度兼容:ES兼容性测试1366/1369项通过,_cat/indices、_search、DSL查询、聚合、knn向量检索、语义检索全部支持。Kibana、各语言ES客户端,仅修改地址localhost:9200直接连接。
混合检索开箱即用,离线优先:默认词法嵌入器完全离线,不需要下载模型;如需语义检索,可手动开启神经模式,仅下载约90MB模型文件。支持BM25全文检索 + kNN向量检索 + RRF混合检索。内置Web控制台,支持查询、切面过滤、实时指标仪表盘。
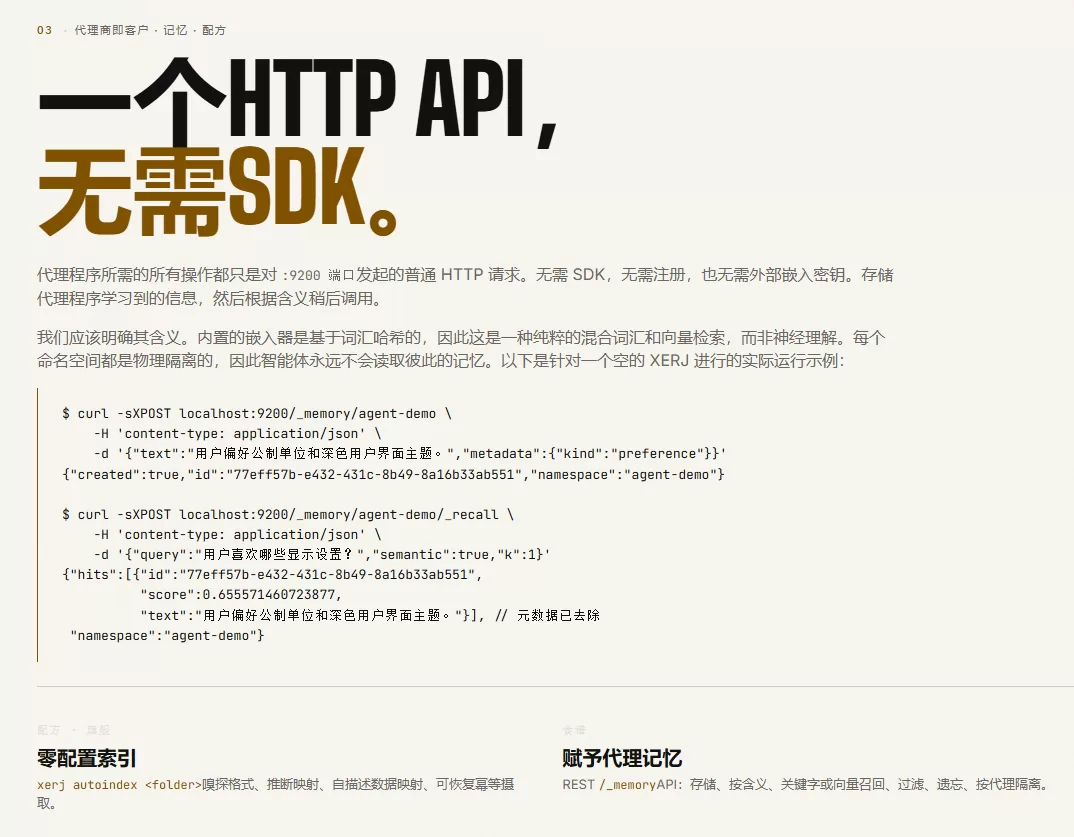
MCP原生支持 + Agent长期记忆:二进制自带MCP Server,无需额外部署。一条 xerj init 自动把XERJ接入Claude Code / Cursor,自动配置MCP与技能。内置/_memory/{namespace}接口,充当Agent跨会话长期记忆,支持语义召回,附带记忆聚类视图,作为AI的第二大脑。
04|五分钟上手实战
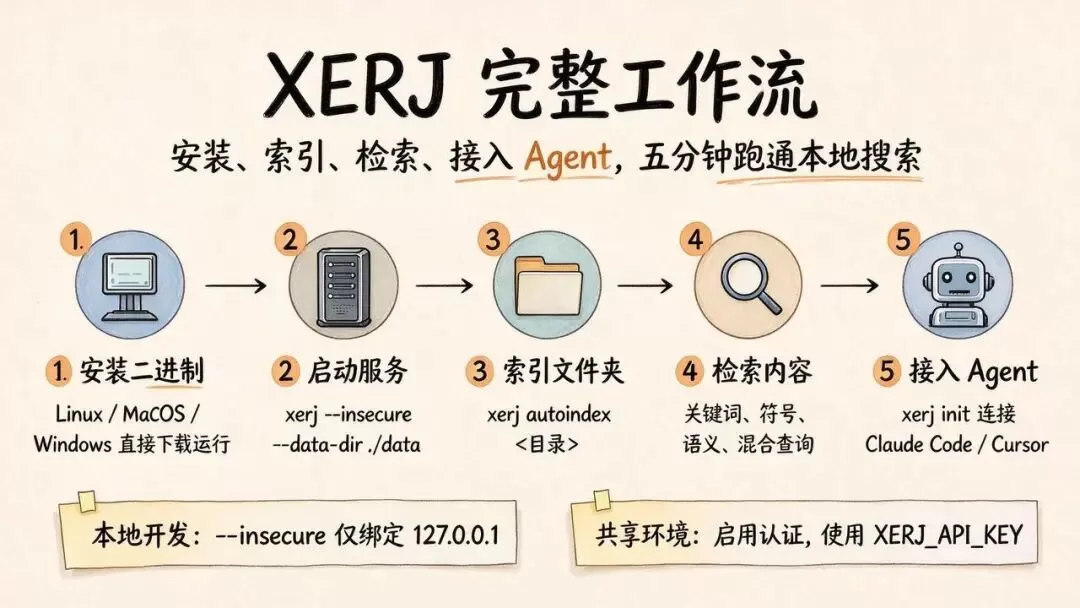
1、安装:
# Linux/macOS
curl -fsSL https://xerj.org/get | sh

# Windows PowerShell
irm https://xerj.org/get.ps1 | iex
2、启动服务 & 索引文件夹:
# 本地开发单用户(关闭鉴权与TLS,仅127.0.0.1)
xerj --insecure --data-dir ./data &

# 索引目标项目文件夹
xerj autoindex ~/my-project

# 检索内容
xerj search "how do we rotate the WAL segment"

# 查询函数定义
xerj def "euler_to_rotation_matrix"

# 查看节省token统计
xerj gain

# 一键接入Cursor/Claude Code MCP
xerj init
3、使用ES客户端直接调用API:
# 查看全部索引
curl localhost:9200/_cat/indices

# 全文检索
curl "localhost:9200/ax-*/_search?q=checkout+error"

# DSL结构化查询+聚合
curl localhost:9200/ax-orders/_search -H 'content-type: application/json' -d '{"query": { "range": { "total": { "gte": 100 } } },"aggs": { "by_status": { "terms": { "field": "status" } } }}'
4、MCP接入无法执行Shell的AI助手:
# 先启动xerj服务,再启动MCP stdio服务
xerj --insecure --data-dir ./data &
xerj mcp

# MCP客户端配置JSON示例:
{"mcpServers": {"xerj": {"command": "/home/you/.local/bin/xerj","args": ["mcp"],"env": { "XERJ_URL": "http://localhost:9200" }}}}
05|适用场景
- 开发者 & AI编码Agent:私有源码库检索,查找函数定义、错误代码定位,替换grep,大幅削减Token开销
- 个人知识库:本地PDF、电子书、日志、文档一站式全文+语义检索,远超系统自带文件搜索
- 安全审计:跨多类型文件批量扫描密钥、高危代码调用
- 日志运维分析:异构日志统一检索、聚合统计
- 团队内网:作为轻量Elasticsearch替代,单二进制,内网离线部署,复用现有ES工具链
- AI Agent长期记忆:/_memory接口,存储会话知识,跨会话语义召回,搭建Agent第二大脑
06|选型对比
- 系统文件搜索:仅文件名检索,不支持文档内全文、代码AST解析、向量检索
- Elasticsearch:依赖JVM,资源占用高,部署复杂,重量级
- grep:仅文本匹配,必须读取完整文件,Token消耗巨大,无语义检索
- XERJ:单二进制、零依赖,自动识别全类型文件,ES兼容,混合检索,原生MCP与Agent记忆,轻量化,本地离线优先
07|写在最后
XERJ目前处于RC候选发布阶段(最新v1.0.0-rc.96),功能迭代很快,会存在少量粗糙细节,但方向极具潜力:它把搭建搜索引擎的门槛,从部署ELK整套组件,简化到只运行一个二进制。
✅ 推荐尝试:大量私有代码/内部文档、AI Agent高频检索、内网离线环境,想要低成本ES兼容检索能力。
❎ 不推荐:大规模高并发线上写入场景(官方基准测试显示高频写入场景p99读取延迟弱于ES);热门开源库检索场景收益很低。
社区规则:Apache-2.0协议免费开源,只需要提交一份使用反馈PR(负面评价也接受,仅反馈类PR免签CLA),人类和AI Agent都可以参与贡献。