今年视频模型圈子里最热闹的方向,莫过于实时生成和实时交互。不少团队都推出了实时交互模型,做到了能实时对话的数字人,还能一边生成一边播放视频。
随着实时交互模型逐渐增多,大家的需求也不断增加,自然就想比一比谁家模型做得更好。但传统的离线视频评测,放到流式实时交互模型身上比不出好坏——得看模型能不能连着几分钟都接住新指令,还不把画面弄乱。
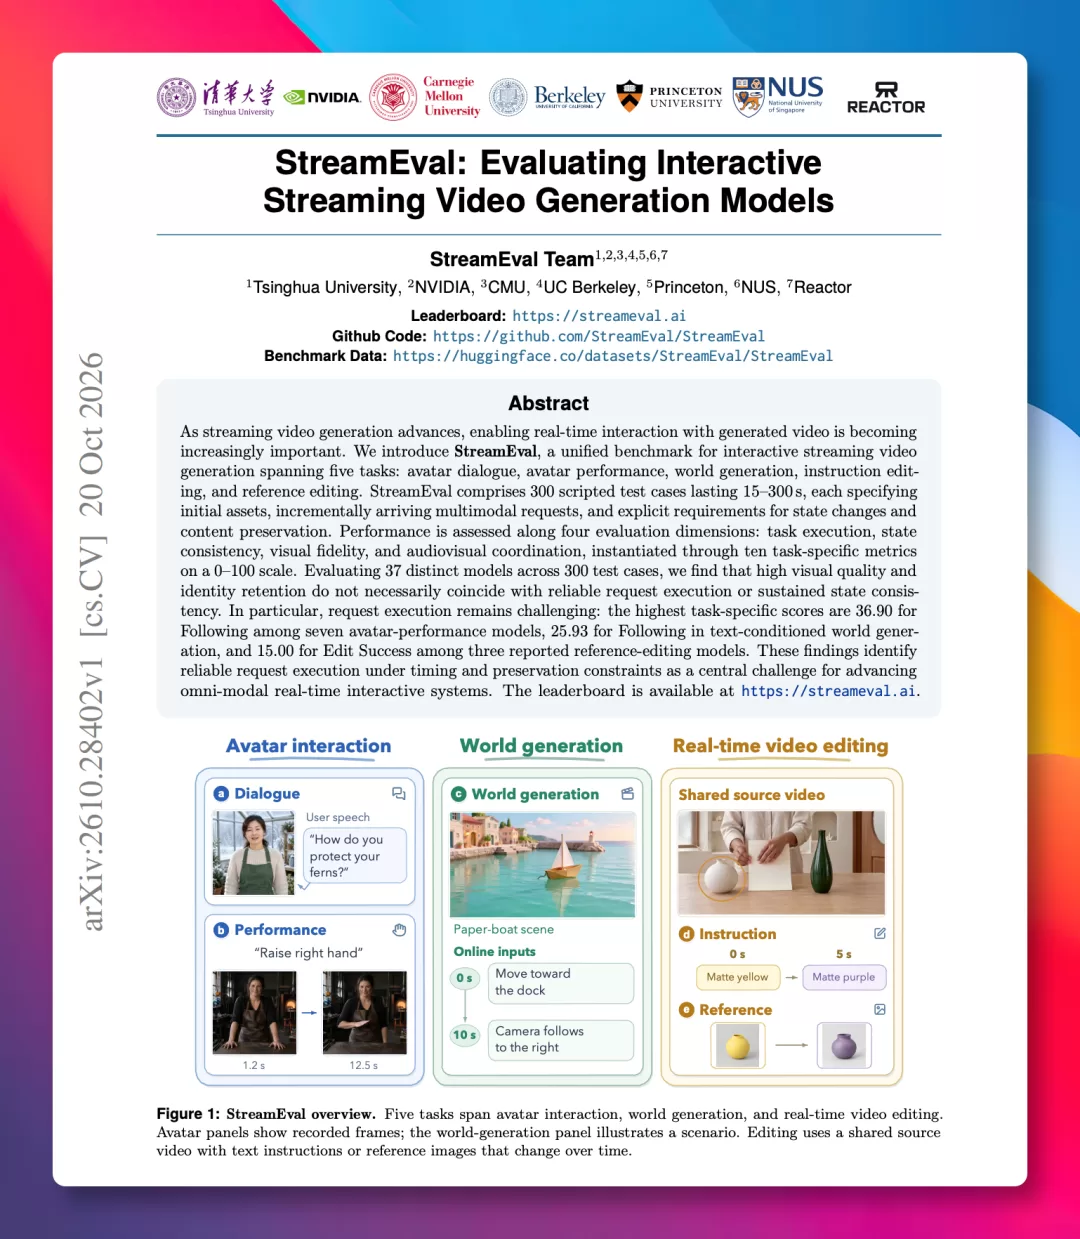
直到最近,首个流式视频生成评测榜单 StreamEval 正式上线。配套的评测基准也已开源,让不同模型在统一的测试规则下接受比较。项目参与者来自清华大学、英伟达、普林斯顿、UC Berkeley 等海内外高校和机构。
StreamEval 的一个重要特点是评测过程公开透明:所有测试题目和测试代码全部开源,每道题的输入素材、指令时间轴、预期结果和评分规则一并公开。任何人都可以按照公开流程复现评测、核验结果。
榜单还将由 StreamEval Team 长期维护,每个月更新一次,持续评测新增模型和已有模型的新版本。
评的是一整段互动
StreamEval 一共设了五类任务:数字人对话、数字人表演、世界生成、指令编辑和参考编辑。
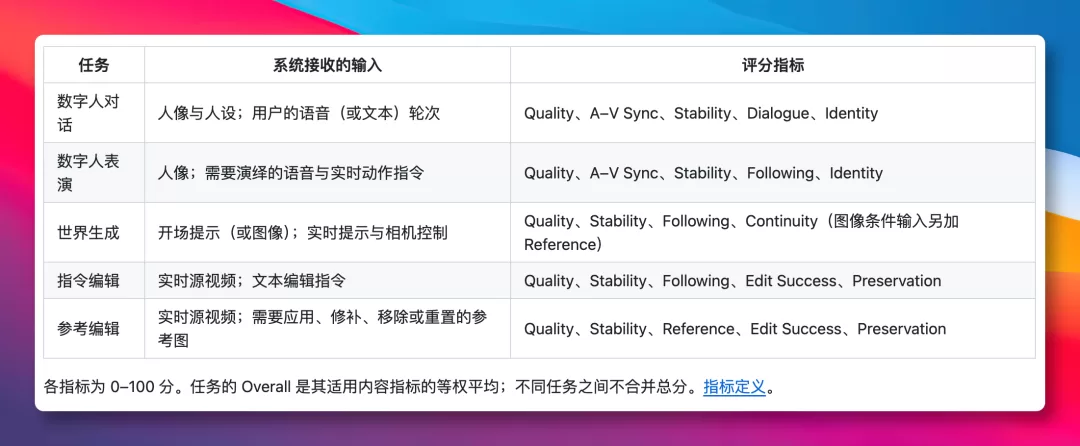
数字人对话考的是持续聊天时能不能听懂、接得上话,人物的长相和声音前后保持一致。数字人表演是按实时指令做动作、换表情。世界生成则是根据指令持续改变场景、镜头或物体状态。后面两类属于实时视频编辑,一个靠文字指令改视频,一个靠参考图改目标外观。
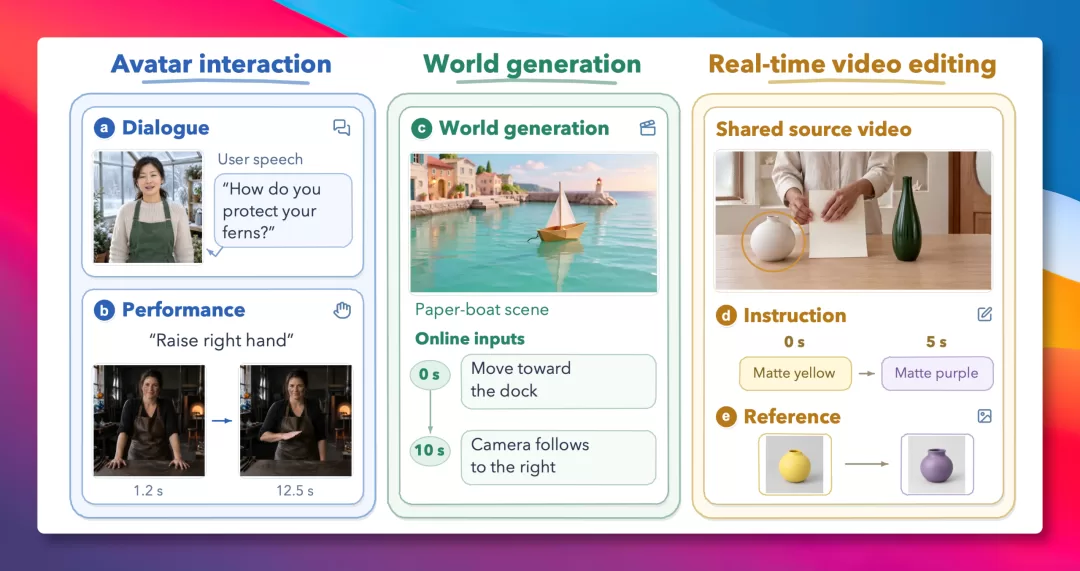
论文里对比了 19 个已有的相关 benchmark,每一个只覆盖这五类任务里的一到两类,StreamEval 是把它们放进同一套框架里来测。整个基准有 300 个测试用例,每类任务 60 个,每场测试从 15 秒到 300 秒不等。
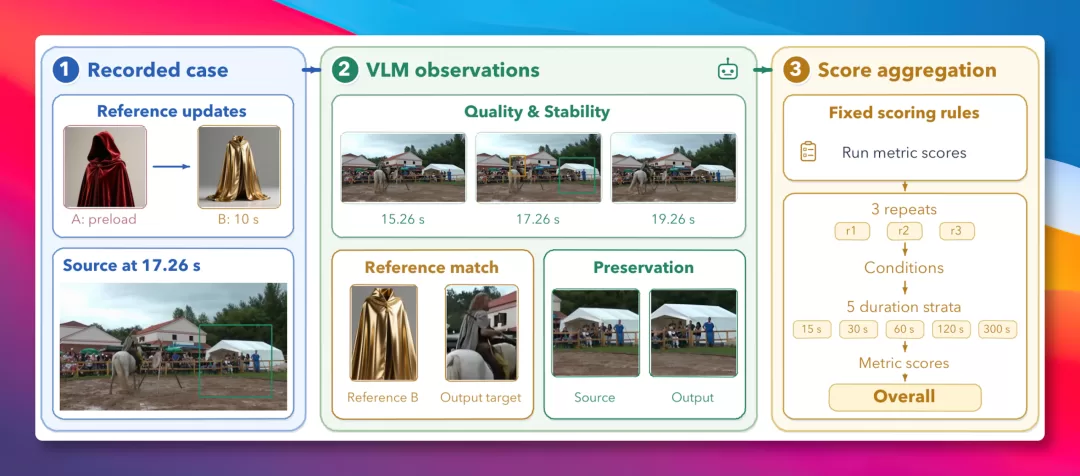
评分分了四个维度:任务执行、状态一致性、视觉保真度和声画协调。四个维度下面一共十项指标,每项都是 0 到 100 分。每类任务各自算一个 Overall 综合分,不会再把五类任务放到一起排总榜。
模型表现怎么样
论文里测了 37 个模型,一共 47 个模型任务配置,开源模型和商业服务都有。不少模型画面质量得分挺高,但持续指令执行的分数就低了不少。
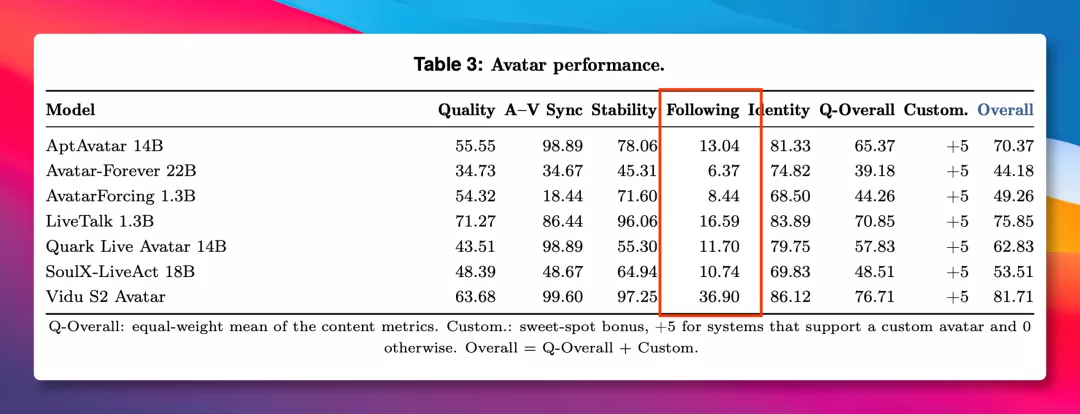
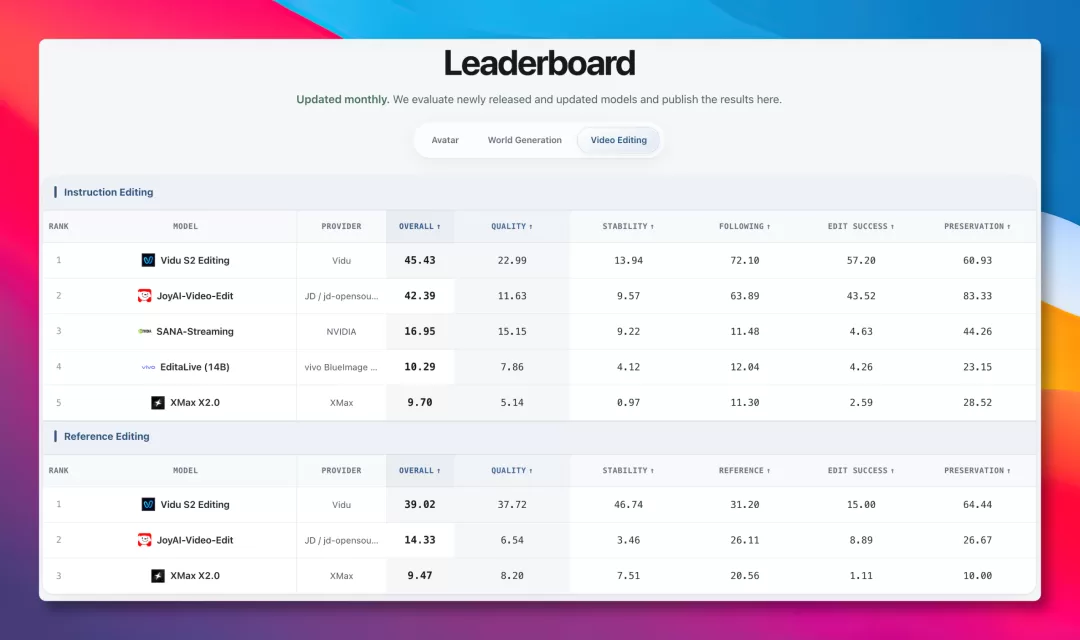
数字人表演测了 7 个模型,Following(指令跟随)这一项,最高的也只拿到 36.90 分。世界生成也是,给模型输入文字指令的情况下,Following 最高只有 25.93 分。参考编辑里,3 个模型的 Edit Success(编辑成功率),最高只有 15.00 分。
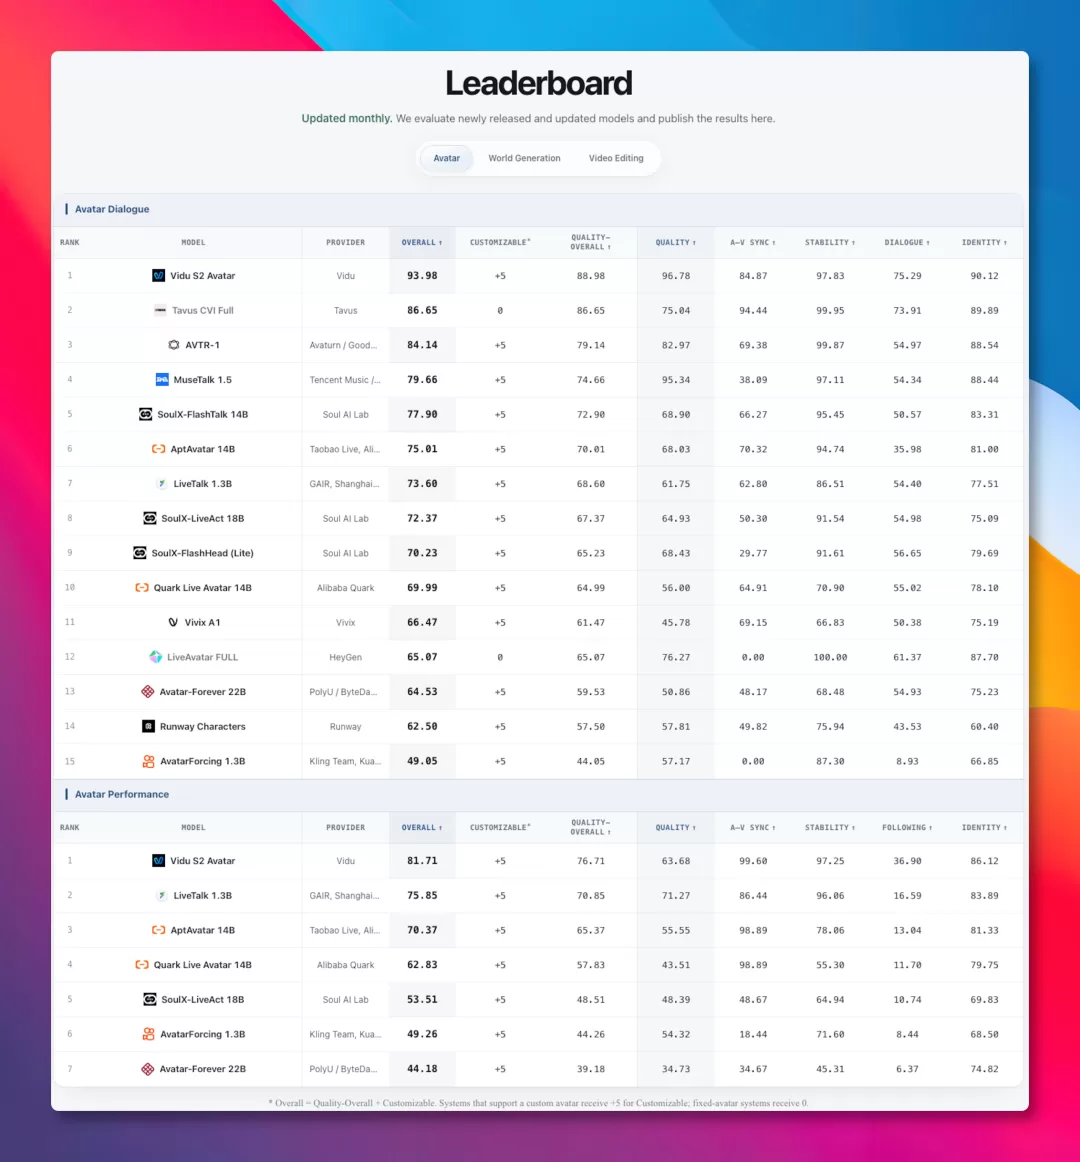
在 StreamEval 的官方榜单上,数字人对话有 15 个模型参评,生数科技的 Vidu S2-Avatar 以 93.98 的 Overall 排第一。数字人表演的第一同样是 Vidu S2-Avatar,Overall 81.71。
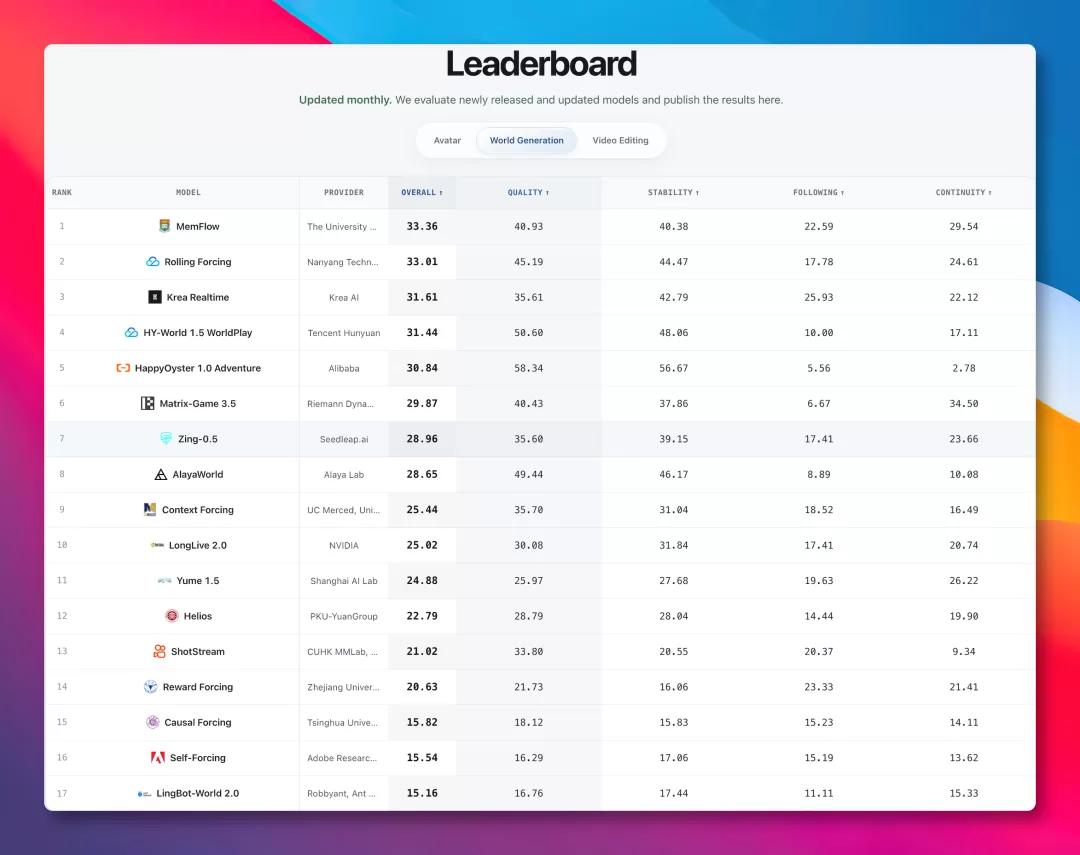
世界生成有 17 个配置参评,港大和可灵团队的 MemFlow 以 33.36 排第一。指令编辑有 5 个模型参评,Vidu S2-Editing 以 45.43 排第一,京东的 JoyAI-Video-Edit 以 42.39 排第二。参考编辑的第一也是 Vidu S2-Editing,Overall 39.02。
怎么参与进来
除了读论文,StreamEval 仓库里的评测工具也可以直接跑起来,Linux 和 macOS 都行,需要 Python 3.10 以上版本。第一次上手可以先跑一个 CPU 示例,用的是程序在本地生成的素材,不需要 API Key、GPU,也不用先下载数据。
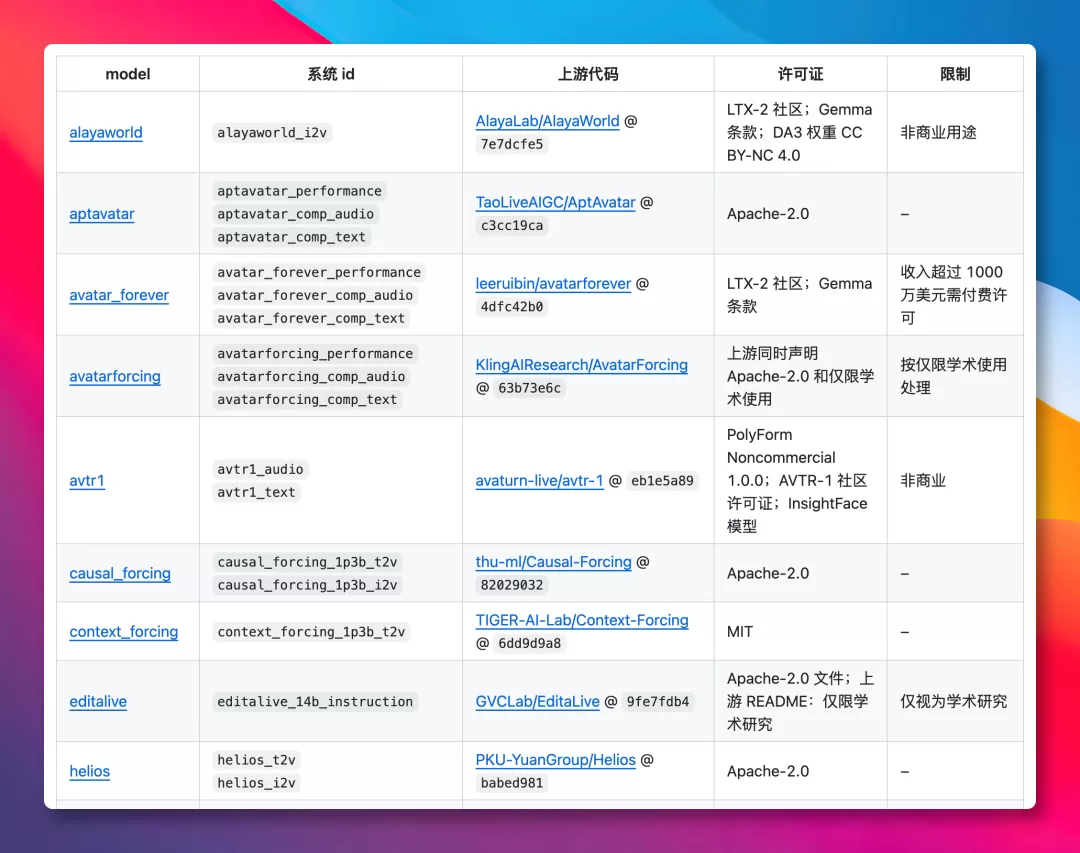
跑通之后,再去下载完整的评测数据(约 3.1 GB),目前已经可以在 ModelScope 上下载。仓库里已经写好了 29 个开源模型的接入代码,配置好评审模型的凭证,就能跑一遍完整评测。
想测自己的模型的话,可以照着仓库里的 Add a Model 文档来接入,目前支持进程内模型接口和 WebSocket 服务两种方式。
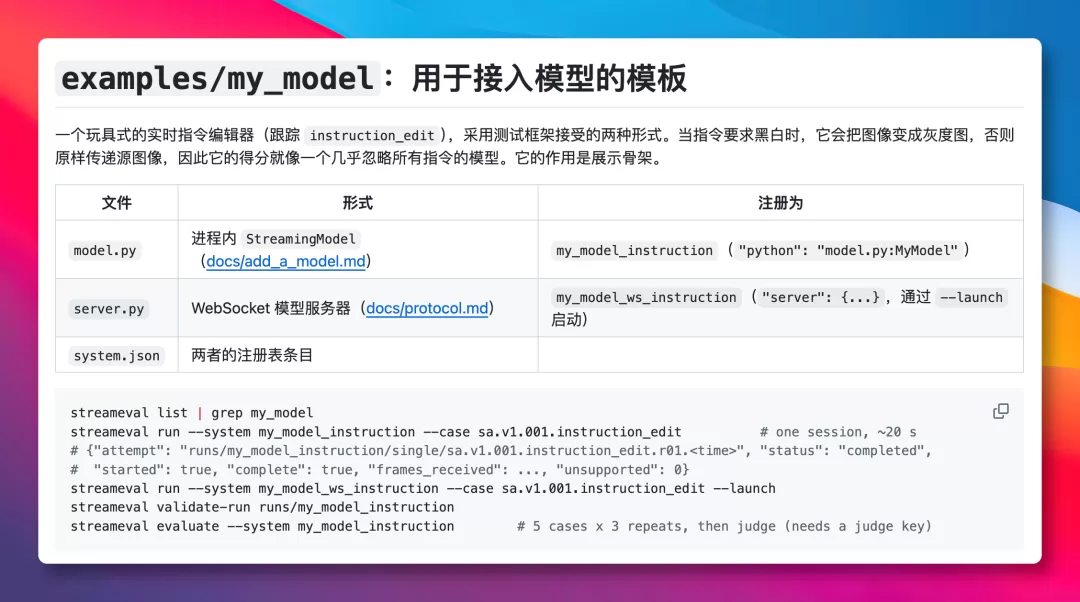
跑完之后,本地会留下结果和评测记录,项目欢迎大家把模型接入信息、评测结果和技术反馈贡献给维护团队。官网已提供 'Evaluate your model' 评测申请入口。
写在最后
视频生成模型这两年的进步大家应该都有感受,从生成几秒的短片,一路做到了能实时生成、实时互动。StreamEval 开放的不只是一份成绩单,评测方法、工具和数据都摆在桌面上,所有测试题目与测试代码全部开源,让大家既能查看排名,也能检查评分依据。
榜单也会长期持续更新,不断纳入新的模型和测试结果。从这一轮的结果看,数字人表演和参考编辑里,跟执行指令相关的最高分都还不到 40 分,这道题离答好还早。
做实时视频模型的团队,或者对这个方向感兴趣的朋友,可以去看看,把自己的模型接进来跑一跑。