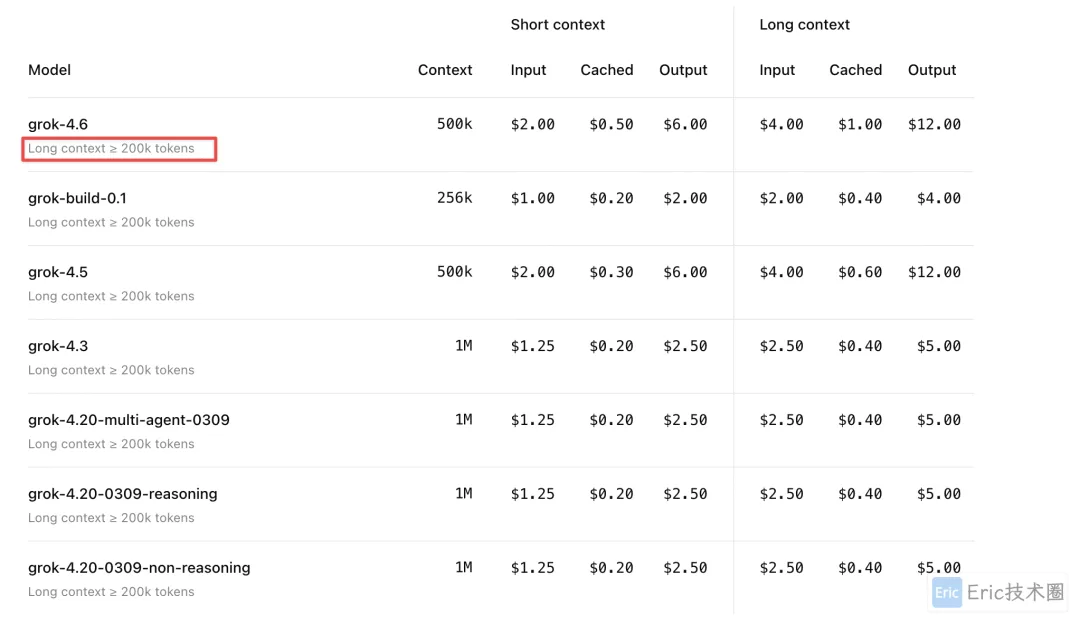
将 Grok 作为主力编码模型有几项突出优势:周限额机制而非 5 小时短周期、原生上下文最大 500K、推理速度快、Token 效率高。但实际使用中发现一个关键问题:Grok 的计费在上下文超过 200K 后,价格会全量翻倍——包括输入、缓存和输出。任务稍长,额度消耗可能飙到平时的 1.5 倍以上。
解决思路很直接:使用 Pi Agent 接入 xAI,利用 Pi 精细的上下文管理机制,将上下文控制在 200K 翻倍线以内,最大化周额度利用率。
Grok 接入 Pi Agent
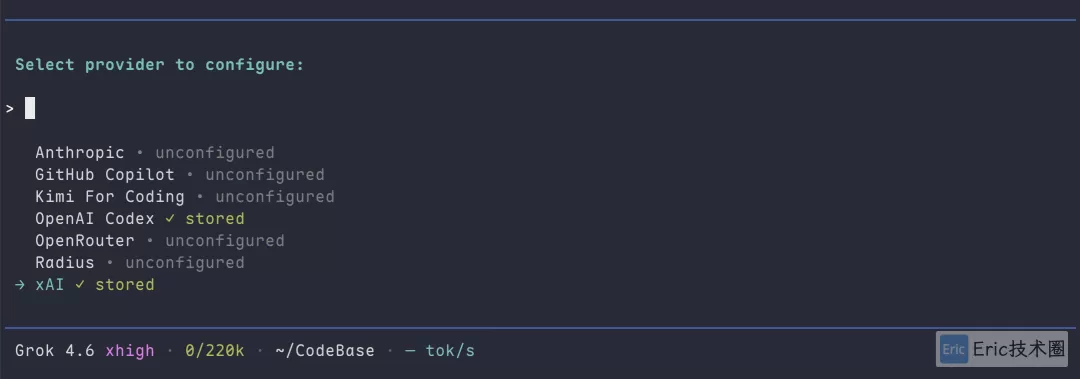
在 Pi Agent 中执行 /login 命令,选择 Sign in with an account,按提示登录 xAI 账号即可完成订阅授权。
上下文压缩配置
Pi 支持在全局配置中覆盖模型定义。编辑 ~/.pi/agent/models.json:
{
  "providers": {
    "xai": {
      "modelOverrides": {
        "grok-4.6": {
          "contextWindow": 220000
        }
      }
    }
  }
}
配合 ~/.pi/agent/settings.json 中的压缩参数:
{
  "compaction": {
    "enabled": true,
    "reserveTokens": 27200,
    "keepRecentTokens": 32000
  }
}
这里设置 contextWindow: 220000 的巧妙之处在于:Pi 的实际压缩阈值是 contextWindow - reserveTokens,减去预留的 27200 后约为 192K。这样 Pi 会在上下文即将触达 200K 价格翻倍线之前,自动完成一次上下文压缩(Compaction)。绝大部分长时任务只需 1 次压缩即可平稳收尾,既保证代码生成质量,又把单价牢牢压在未翻倍的低价区间。
保证交付质量的两点实践
主动限制上下文、触发压缩是否真正划算,核心取决于最终交付质量。两点核心实践:
发挥 Grok 高 Token 效率优势:Grok 的 Token 表达非常紧凑,同样代码修改消耗更少,上下文膨胀慢,自然拉长触碰 200K 翻倍线的时间。实测中绝大部分复杂任务在 1-2 次压缩内即可收尾。如果频繁压缩,往往意味着单次任务颗粒度过大,应在需求层面做拆解。
以规划文档做确定性兜底:开工前先梳理包含需求、架构设计与分步执行计划的规划文档。这是最稳定的上下文锚点——即使触发压缩,模型也可以随时通过重新读取规划文档找回全局记忆,确保长任务不跑偏。
写在最后
把 Grok 接入 Pi 之后,通过主动控制上下文避开长时任务超出 200K 后的全量翻倍计价,将开销锁定在基础价格区间,周额度的抗用程度大幅提升。